
إذا كان Collector في المستوى الثاني يعيد التشغيل باستمرار، أو لم تنخفض فاتورة التتبعات، فالأولى مراجعة قواعد tail sampling قبل أي تعديل على حجم الحركة. كل قاعدة تضيفها تغيّر ما يحتفظ به المعالج في الذاكرة وما يتخلص منه وما يرسله إلى الخادم الخلفي. ليست هذه مسألة إعداد ثانوية، بل ميزانية يجب توزيعها.
ننطلق هنا من قرار التشغيل لا من قائمة السياسات. كم ذاكرة تخصص للتتبعات «قيد المعالجة»؟ بأي ترتيب تركّب القواعد؟ وما المزالق التي تظهر بعد الانتقال إلى الإنتاج؟ مبدأ tail sampling مشروح في الدرس التطبيقي عن tail sampling في OpenTelemetry، وتوجيه التتبعات حسب المعرّف في مقال load balancing حسب trace ID. أما هنا فنحدد الحجم ونضبط الإعدادات.
المعلومات مستمدة من ملف README الخاص بالمعالج tail_sampling (مستودع opentelemetry-collector-contrib) ومن صفحة أخذ العيّنات في opentelemetry.io، وقد اطّلعت عليهما في 11 نوفمبر 2026. تجري المعالجة داخل Collector قبل التصدير عبر OTLP، لذا ينطبق المنطق نفسه على Dynatrace SaaS وDynatrace Managed وعلى أي خادم خلفي آخر.
ما تكلّفه القاعدة: الذاكرة أولًا
يصنّف ملف README هذا المعالج ضمن المكوّنات ذات الحالة (stateful)، فهو يُبقي الـ spans في الذاكرة إلى أن يقرر. لذلك تُقاس تكلفة مجموعة القواعد بالذاكرة قبل المعالج المركزي بكثير. وتتحكم بها ثلاثة إعدادات.
decision_wait(القيمة الافتراضية 30 ثانية): مدة الانتظار قبل تقييم التتبع. مضاعفتها تضاعف عدد التتبعات المحتفظ بها عند ثبات الحركة.num_traces(القيمة الافتراضية 50 000): حجم المخزن الدائري. عند وصول تتبع جديد والمخزن ممتلئ، يُطرد الأقدم حتى لو لم يُقيَّم بعد.maximum_trace_size_bytes: التتبع الأكبر من هذا الحد يُهمل فورًا. إنه حماية من التتبعات الضخمة.
القاعدة الحسابية الناتجة عن ذلك مجرد حساب، وليست صيغة رسمية: يجب أن تساوي num_traces على الأقل عدد التتبعات الجديدة في الثانية لكل نسخة مضروبًا في decision_wait. فيما يلي مثال حسابي بفرضيات اخترتها أنا، وعليك استبدالها بقياساتك.
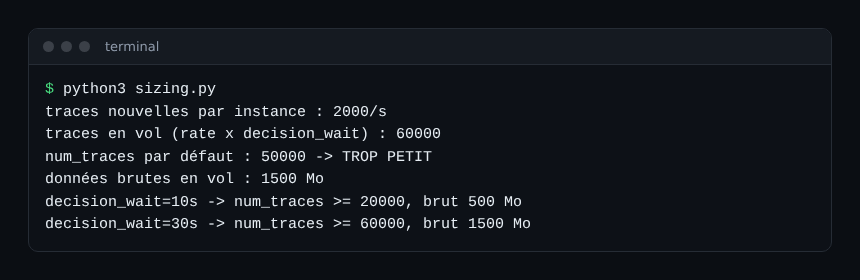
في هذا المثال تكون القيمة الافتراضية صغيرة: يطرد المخزن تتبعات قبل اتخاذ القرار، ويذكر README المقياس الذي ينبّه إلى ذلك وهو sampling_trace_dropped_too_early. تخفيض decision_wait إلى 10 ثوانٍ يخفض الحاجة إلى 20 000 تتبع. لم أقِس البصمة الفعلية للـ span في ذاكرة المعالج، فالميغابايتات المعروضة أرقام خام مبنية على فرضيات، والاستهلاك الحقيقي سيكون أعلى. قِسه على حركتك قبل تحديد حدود الـ pod.
تركيب قواعد tail sampling بحيث تكمّل إحداها الأخرى
يقيّم المعالج جميع السياسات ثم يحسم وفق شجرة القرار في README. عمليًا: إذا انطبقت سياسة drop أُسقط التتبع، وإذا قبلته سياسة أخذ عيّنات احتُفظ به، وفي الحالات الأخرى لا يُحتفظ به. فالأهم هو طبيعة كل قاعدة أكثر من ترتيبها.
ثلاث عائلات من القواعد
- الاستثناءات:
dropتستبعد الضجيج، مثل فحوص الصحة. وهي تتغلب على السياسات التي تريد الاحتفاظ بالتتبع. - شبكات الأمان:
status_codeعلىERRORوlatencyفوق حد معيّن تحتفظان بما سيقرؤه فريق المناوبة لتقليل MTTR. - سقف التكلفة:
compositeتوزّع حدًا أقصى من الـ spans في الثانية على عدة سياسات فرعية. نسبةrate_allocationتحجز مكانًا للخدمة الحرجة، وسياسة احتمالية تأخذ الباقي.
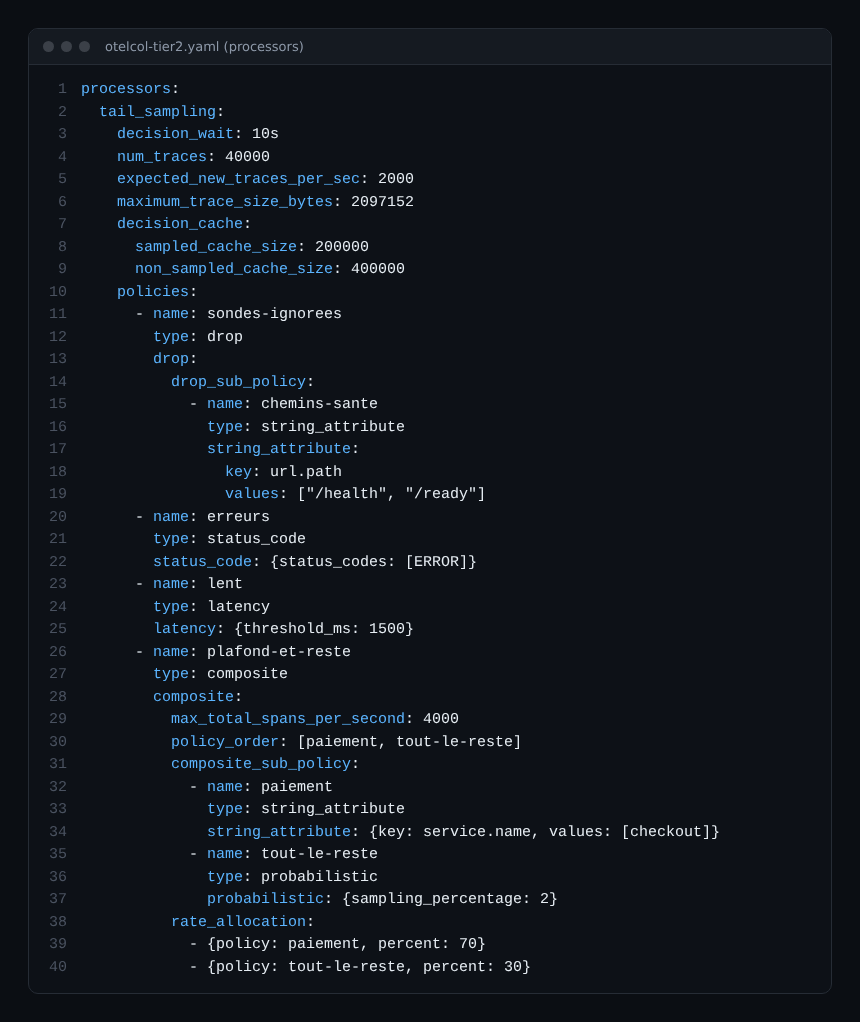
هذا الإعداد مثال كُتب انطلاقًا من README، ولم تشغّله span.observer داخل Collector، وأسماء الخدمات والحدود والمسارات وهمية. وهو لا يغني عن اختبار على حركتك الفعلية.
هناك ملاحظتان تستحقان الانتباه. الأولى أن README يوصي بإضافة سياسة probabilistic داخل المعالج إذا كنت تستخدمه أصلًا، فالكلفة الإضافية ضئيلة، ولا يُسقط معاين ثانٍ لاحق التتبعات التي احتفظت بها قواعد أخرى. والثانية أن sample_on_first_match يقرر بمجرد انطباق أول سياسة: وهذا أسرع، لكن README ينصح بعدم الجمع بينه وبين بوابة الميزة usetracestate، لأن التوقف المبكر يحرّف الأعداد المعدّلة لاحقًا.
مزالق قواعد tail sampling في الإنتاج
الـ spans التي تصل متأخرة
الـ span «المتأخر» يصل بعد اتخاذ القرار. إذا كان القرار ما زال في المخزن ورثه، وإلا ومن دون ذاكرة قرارات يعامله المعالج كتتبع مجهول ويفتح نافذة جديدة مدتها decision_wait، فقد يُحفظ التتبع الواحد ناقصًا. تحفظ decision_cache (بالحجمين sampled_cache_size وnon_sampled_cache_size وقيمتهما الافتراضية 0) معرّفات التتبعات التي صدر بشأنها قرار. وينصح README بتحديد حجمها أكبر بكثير من num_traces.
نسخة واحدة من Collector أم عدة نسخ
بمجرد وجود عدة نسخ، يجب أن تصل كل spans التتبع الواحد إلى النسخة نفسها. يوصي README بطبقتين: مُصدِّر load balancing في المقدمة والمعالج خلفه، لعزل الأعطال. تفاصيل الإعداد في المقال المخصص لذلك. ولمعرفة موضع المعالج في الـ pipeline راجع أيضًا مكوّنات Collector contrib: يوضح README أنه يجب أن يأتي بعد المعالجات التي تعتمد على السياق مثل k8sattributes، لأنه يعيد تكوين دفعات جديدة.
حدود المعدل مع عدة shards
عندما تكون قيمة num_shards أكبر من 1، يوزَّع num_traces والحدود في الثانية بين الـ shards. ويوضح README أن التطبيق يصبح تقريبيًا: قد يُتجاوز في المجموع حدٌّ أصغر من عدد الـ shards. أبقِ num_shards عند 1 ما لم تقِس تنافسًا على الموارد.
مكوّنات لا تزال تتغير
المعالج في مرحلة استقرار beta للتتبعات. القرارات «المعكوسة» (invert_match) متقادمة لصالح drop وnot، والتخزين الخارجي (tail_storage) ما زال خلف بوابة ميزة قيد التطوير. أعد قراءة README عند كل ترقية لـ Collector.
كيف تتحقق من أنه يعمل
راقب المعالج كما تراقب أي خدمة. يعطي README المقاييس التي تُتابَع: التتبعات المطرودة قبل القرار، وعمر التتبعات عند إزالتها، ومدة التقييم، ونسبة التتبعات المحتفظ بها.
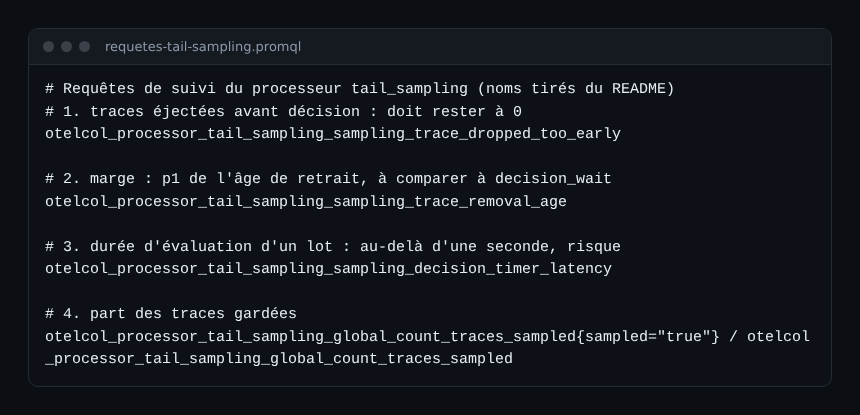
- يجب أن يبقى المقياس
sampling_trace_dropped_too_earlyعند الصفر. وإلا فارفعnum_tracesأو اخفضdecision_wait. - قارن القيمة p1 للمقياس
sampling_trace_removal_ageمعdecision_wait: إذا اقتربت منه فأي ارتفاع في الحركة سيسبب فقدانًا. - إذا زاد
sampling_decision_timer_latencyعلى ثانية فقد تتأخر القرارات عنdecision_wait، بحسب README. - لمعرفة أي قاعدة احتفظت بتتبع ما، فعّل البوابة
processor.tailsamplingprocessor.recordpolicy، فتُضاف السمةtailsampling.policyإلى الـ spans المحتفظ بها.
أفضل الممارسات
- حدّد الذاكرة أولًا ثم القواعد: مجموعة قواعد مثالية لا قيمة لها إذا كان المخزن يطرد التتبعات.
- ضع الاستثناءات (
drop) وشبكات الأمان (الأخطاء والبطء) قبل سقف التكلفة. - احجز جزءًا من السقف للخدمات الحرجة بدل نسبة موحدة.
- فعّل ذاكرة القرارات متى وُجدت تتبعات طويلة أو spans متأخرة.
- احتفظ في المستودع بقالب حسابك مع الفرضيات، لتعيده كلما تغيّرت الحركة.
- لفهم أخذ العيّنات من جهة SDK تبقى صفحة Sampling في opentelemetry.io المرجع.
الأسئلة الشائعة
ما القيمة المناسبة لـ decision_wait؟
مدة أطول تتبع تريد أن تراه كاملًا، ولا تزد عليها. القيمة الافتراضية 30 ثانية. كلما زادت القيمة احتجت ذاكرة أكبر وتأخرت القرارات.
هل تحل قواعد tail sampling محل أخذ العيّنات في SDK؟
لا، بل تكمّله. لا يرى tail sampling إلا ما ترسله SDK، فإذا كان SDK يأخذ العيّنات في البداية فإنه يتخلص من تتبعات قبل أن يتمكن Collector من تقييمها. وللدرس التطبيقي خطوة بخطوة راجع Collector الخاص بـ OpenTelemetry على Kubernetes.
هل أحتاج Collector لكل نسخة من التطبيق؟
لا. تحتاج مستوى ثانيًا من Collector يتلقى كل التتبعات حسب المعرّف كما وُصف أعلاه. العدد الدقيق يتوقف على حركتك، فاحسبه بحساب القسم الأول.
الخلاصة
تبدأ قواعد tail sampling الفعّالة بميزانية ذاكرة ومهلة قرار، ثم بتركيب واضح: استبعاد الضجيج، والاحتفاظ بالأخطاء والبطء، وتحديد سقف للباقي. بعد ذلك راقب مقاييس المعالج وأعد قراءة الوثائق عند كل إصدار. المرجع: README الخاص بالمعالج tail_sampling.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC. Dynatrace علامة تجارية لشركة Dynatrace LLC. العلامات الأخرى المذكورة تعود إلى مالكيها. الأمثلة وهمية ولم تُشغَّل داخل Collector. تحقق دائمًا من القيم والخيارات في الوثائق الرسمية الخاصة بإصدارك.