موازنة الحمل حسب trace ID: يستطيع Collector واحد أن يجري أخذ العينات (sampling) دون مشكلة، لكن بمجرد إضافة نسخ (replicas) تصبح القرارات غير متسقة. تعالج موازنة الحمل حسب trace ID هذه المشكلة: مستوى أول من Collectors يوزّع الـ spans بحسب traceID، فتصل جميع spans التتبع الواحد إلى النسخة نفسها في المستوى الثاني، وهي التي تحمل المعالج tail_sampling.
الهدف: بناء هذه البنية ذات المستويين باستخدام المُصدِّر load_balancing من مستودع OpenTelemetry Collector contrib، والتحقق منها، ومعرفة حدودها (إضافة pods أو سحبها، وفقدان البيانات). المبدأ مستقل عن الواجهة الخلفية: ينطبق على Dynatrace SaaS وعلى Dynatrace Managed معًا، لأن كل شيء يجري داخل Collector قبل تصدير OTLP.
تكمّل هذه المقالة الدرس التطبيقي عن tail sampling في OpenTelemetry الذي يشرح سياسات أخذ العينات بالتفصيل. التركيز هنا على التوجيه الذي يجعل تلك السياسات موثوقة.
لماذا تلزم موازنة الحمل حسب trace ID مع tail sampling
بحسب ملف README الخاص بالمعالج tail_sampling، يجب أن تستقبل نسخة Collector نفسها جميع spans التتبع الواحد للحصول على قرار صحيح. يحتفظ المعالج بالـ spans في الذاكرة مجمّعةً حسب trace_id، ثم يقيّم سياساته. إذا تقاسمت نسختان spans تتبع واحد، قررت كل منهما برؤية جزئية: تحتفظ إحداهما بالجزء الذي فيه خطأ وترمي الأخرى الباقي. النتيجة: تتبعات مبتورة بلا span جذر، لا يعرف فريق المناوبة كيف يستفيد منها.
موازن الحمل الشبكي التقليدي (round-robin على المنفذ 4317) لا يحل شيئًا: فهو يوزّع الاتصالات أو الطلبات لا التتبعات. لذلك يلزم توجيه حتمي (deterministic) على معرّف التتبع. يصف README المُصدِّر هذه الحالة تمامًا: توجيه متسق يتيح معالجة لاحقة ذات حالة، ومنها tail sampling.
كيف يعمل المُصدِّر load_balancing
يقرأ المُصدِّر مفتاح التوجيه (routing_key) لكل دفعة، ويحسب الواجهة الخلفية التي يجب أن تذهب إليها، وينشئ مُصدِّر OTLP لكل endpoint. إليك بعض الوقائع المأخوذة من README الخاص به:
- القيم الممكنة لـ
routing_keyهيserviceوtraceIDوmetricوresourceوstreamIDوattributesوrandomness. بالنسبة إلى التتبعات،traceIDهي القيمة الافتراضية؛ ويبقى ذكرها صراحةً ممارسة جيدة لسهولة القراءة. - مصدر الواجهات الخلفية هو محلِّل (resolver):
static(قائمة ثابتة)، أوdns(اسم يُحَلّ إلى جميع العناوين، مثل خدمة Kubernetes من نوع headless)، أوk8s(خدمة Kubernetes)، أوaws_cloud_map. - يعتمد اختيار الواجهة الخلفية على المعرّف وحده لا على الحمل الفعلي. يعلن README توزيعًا قريبًا من التوازن، بانحراف معياري أقل من 5% في الإعداد الحالي.
- الاستقرار المعلَن: beta للتتبعات والسجلات، وalpha للمقاييس.
- أُعيدت تسمية نوع المُصدِّر إلى
load_balancing؛ ويبقى الاسم القديمloadbalancingمقبولًا كاسم بديل مهجور.
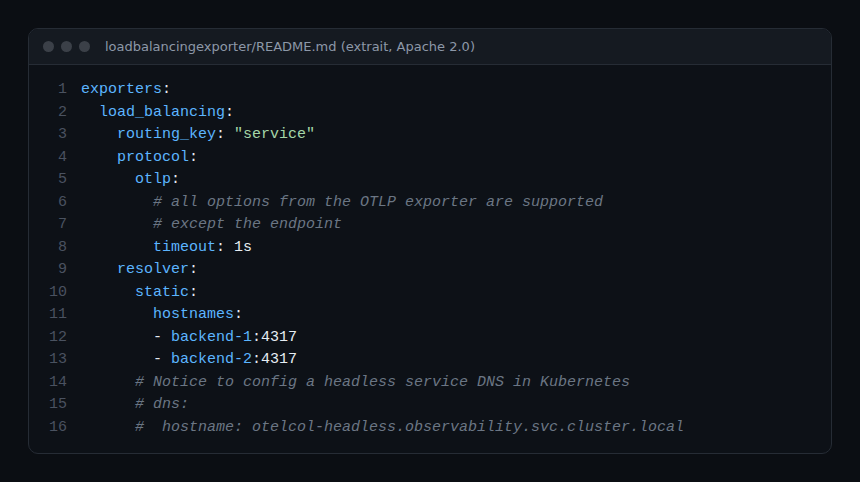
هذا مقطع README يُظهر بنية الإعداد، مع المحلِّل الثابت وفي التعليق ما يعادله في DNS لبيئة Kubernetes:
الإعداد خطوة بخطوة
الخطوة 1: المستوى الأول الذي يوجّه حسب traceID
# collector-routing.yaml
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317
      http:
        endpoint: 0.0.0.0:4318

exporters:
  load_balancing:
    routing_key: traceID
    protocol:
      otlp:
        timeout: 1s
        tls:
          insecure: true
    resolver:
      dns:
        hostname: otel-sampler-headless.observability.svc.cluster.local
        port: 4317

service:
  pipelines:
    traces:
      receivers: [otlp]
      exporters: [load_balancing]
الأسطر الحاسمة: routing_key: traceID يضمن واجهة خلفية واحدة لكل تتبع؛ والمحلِّل dns يشير إلى خدمة headless ليظهر كل pod في المستوى الثاني بعنوان مستقل. يعيد محلِّل DNS الاستعلام عن الاسم دوريًا (5 ثوانٍ افتراضيًا بحسب README). الخيار tls.insecure: true يناسب الاختبار؛ أما في الإنتاج فاستخدم TLS بين المستويين.
إذا فضّلت المحلِّل k8s، فيوضح README أن pod المستوى الأول يجب أن يستخدم حساب خدمة مخوَّلًا بقراءة (get وlist وwatch) كائنات EndpointSlice في namespace المستهدف؛ وبدون ذلك تبقى ذاكرة التخزين المؤقت للمحلِّل فارغة ويسجّل المُصدِّر خطأً.
الخطوة 2: المستوى الثاني الذي يأخذ العينات
# collector-sampler.yaml
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317

processors:
  memory_limiter:
    check_interval: 1s
    limit_percentage: 80
    spike_limit_percentage: 20
  tail_sampling:
    decision_wait: 10s
    num_traces: 100000
    policies:
      - name: erreurs
        type: status_code
        status_code:
          status_codes: [ERROR]
      - name: lentes
        type: latency
        latency:
          threshold_ms: 1000
      - name: echantillon-normal
        type: probabilistic
        probabilistic:
          sampling_percentage: 5
  batch: {}

exporters:
  otlphttp/dynatrace:
    endpoint: "https://<environment-id>.live.dynatrace.com/api/v2/otlp"
    headers:
      Authorization: "Api-Token ${env:DT_API_TOKEN}"

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, tail_sampling, batch]
      exporters: [otlphttp/dynatrace]
انشر هذا المستوى بصيغة StatefulSet أو Deployment خلف خدمة headless المذكورة في الخطوة 1، بنسختين على الأقل. يحتاج رمز Dynatrace المميّز إلى النطاق openTelemetryTrace.ingest؛ وفي Managed يكون الـ endpoint بالشكل https://<votre-domaine>/e/<environment-id>/api/v2/otlp. لنشر Collector على Kubernetes راجع Collector الخاص بـ OpenTelemetry على Kubernetes.
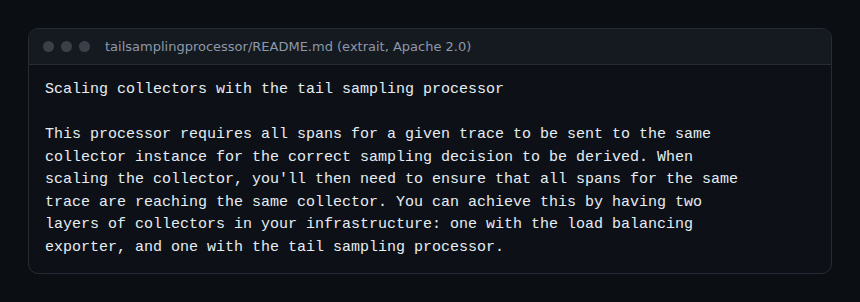
لماذا مستويان وليس خطّا معالجة (pipelines) في النسخة نفسها؟ يقول README المعالج ذلك: هذا ممكن تقنيًا، لكن فصل الطبقتين يمنح عزلًا أفضل للأعطال. ويصف البنية نفسها: مستوى بمُصدِّر موازنة الحمل ومستوى بمعالج tail sampling:
الخطوة 3: ضبط المرونة
افتراضيًا، بحسب README، لا يحاول المُصدِّر إعادة توجيه البيانات إلى واجهة خلفية سليمة عند الفشل: فطابور الانتظار وإعادة المحاولة والمهلة (timeout) معطّلة على مستوى المُصدِّر نفسه. يوجد مستويان للضبط:
- تحت
protocol.otlp(الخيارات 2):timeoutوretry_on_failureوsending_queueللحوادث العابرة في واجهة خلفية، مثل انقطاع شبكي قصير. مفعّل افتراضيًا. - مباشرة في قسم
load_balancing(الخيارات 1): المعاملات نفسها، وهي مفيدة في بيئة مرنة مثل Kubernetes حيث تتغير قائمة الـ endpoints مع كل نشر. معطّل افتراضيًا.
ويوضح README أيضًا أن فقدان البيانات يظل ممكنًا إذا بقيت كل الأهداف غير متاحة بعد استنفاد المحاولات. لذلك خصّص طوابير بأحجام مناسبة وتنبيهًا على إخفاقات التصدير.
ماذا يحدث عندما يتغير عدد pods
عندما تتغير قائمة الواجهات الخلفية يُعاد إسناد جزء من المسارات: نحو R/N، حيث R عدد المسارات (هنا معرّفات التتبع) وN عدد الواجهات الخلفية. كلما زاد عدد الواجهات الخلفية قل الاضطراب. أما التتبع الجاري أثناء النشر فقد تنتهي spans الخاصة به في نسختين وتنتج تتبعًا ناقصًا. يلاحظ README أن المحلِّلين dns وk8s يعكسان التغييرات بتأخير، وأن المحلِّل k8s أسرع من dns.
النتائج بالنسبة إلى فريق المنصة:
- تجنّب إعادة تشغيل المستوى الثاني كله دفعة واحدة: اعتمد نشرًا تدريجيًا وراقب نسبة التتبعات بلا جذر.
- إذا كانت قائمة الواجهات الخلفية تتغير باستمرار وكان الاستقرار مهمًا، فيقترح README النظر في المعالج
groupbytraceفي المنبع، فهو يرسل التتبعات إلى المُصدِّر بصورة ذرّية. - خصّص
decision_waitأكبر من مدة تتبعاتك الطويلة. يمكن حفظ القرارات المتخذة سابقًا في ذاكرات القرار (decision_cache) وهي معطّلة افتراضيًا.
كيف تتحقق من أنه يعمل
- اختبار محلي: يقترح README المُصدِّر إعدادًا يعمل فيه موازن الحمل وأربع واجهات خلفية على الجهاز نفسه، وتصدّر كل واجهة إلى المُصدِّر
debug. أرسل تتبعات متعددة الـ spans وتحقق من أن كلtraceIDيظهر في واجهة خلفية واحدة فقط. - سجلات المستوى الأول: خطأ من نوع couldn’t find the exporter for the endpoint يدل، بحسب README، على محلِّل
k8sبلا صلاحيات RBAC. - المقاييس الداخلية لـ Collector: تابع في المستوى الثاني عدّادات معالج tail sampling. تختلف الأسماء الدقيقة بحسب الإصدار؛ فاستعرضها من endpoint القياس عن بُعد الداخلي بدل نسخها من درس تطبيقي.
- Dynatrace SaaS: ابحث عن تتبعات بلا span جذر، وهي علامة على spans مبعثرة أو على
decision_waitقصير جدًا:fetch spans, from: now() - 1h | summarize spans = count(), racines = countIf(isNull(span.parent_id)), by: {trace.id} | filter racines == 0 | limit 20 - Dynatrace Managed: في عرض التتبعات الموزّعة، صفِّ الطلبات الفاشلة وتحقق من أن التتبعات غير مبتورة (استعلامات DQL لا تنطبق على Managed).
لربط السجلات بالتتبعات بعد أخذ العينات راجع سجلات OpenTelemetry وtrace ID. والتوجيه حسب traceID يصلح للسجلات أيضًا: يوضح README أن السجلات بلا معرّف تتبع تُوزَّع عشوائيًا.
أفضل الممارسات
- افصل المستويين: الأول بلا حالة، والثاني يحتفظ بالتتبعات في الذاكرة.
- استخدم خدمة headless ومحلِّل
dnsأوk8sبدل قائمة ثابتة، فهذه الأخيرة تعرّض لفقدان البيانات إذا سقطت واجهة خلفية. - حدّد ذاكرة المستوى الثاني بحسب معدل التدفق وقيمتي
decision_waitوnum_traces، وضعmemory_limiterأولًا. - احسب مقاييس RED قبل أخذ العينات، في المستوى الأول؛ ومع التوجيه حسب
traceIDيرى كل Collector جميع توليفات الخدمة والعملية، مما قد يسبب تصادمًا في الـ labels (ينصح README بالتوجيه حسبserviceلهذه الحالة). - تعامل مع التتبع المبتور على أنه خلل في الإعداد، وليس خطأ فريق بعينه.
الأسئلة الشائعة
هل تلزم موازنة الحمل حسب trace ID مع Collector واحد؟
لا. مع نسخة واحدة تستقبل كل الـ spans يرى المعالج كل تتبع كاملًا. يصبح التوجيه إلزاميًا بمجرد أن تأخذ عدة نسخ العينات.
ما الفرق بين routing_key بقيمة traceID وservice؟
مع traceID تذهب جميع spans التتبع إلى الواجهة الخلفية نفسها، وهو ما يشترطه tail sampling. ومع service تذهب جميع spans الخدمة إلى الواجهة الخلفية نفسها، وهو ما يناسب المقاييس المحسوبة لكل خدمة.
هل يكفي موازن حمل عادي في Kubernetes؟
لا: فخدمة Service التقليدية توزّع الاتصالات دون صلة بـ traceID. يلزم المُصدِّر load_balancing وخدمة headless ليكون كل pod قابلًا للعنونة بمفرده.
الخلاصة
لا يكون tail sampling موثوقًا على نطاق واسع إلا إذا وصل كل تتبع كاملًا إلى نسخة واحدة. المُصدِّر load_balancing مع routing_key: traceID هو شرط ذلك، مقابل مستوى إضافي من Collectors وبعض الاحتياطات عند النشر. للمتابعة راجع انتشار السياق مع Kafka الذي يتفادى تتبعات مقطوعة أخرى في المنبع. المراجع: README المُصدِّر load_balancing وREADME المعالج tail_sampling.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC ولا للمشاريع المذكورة. Dynatrace علامة تجارية لشركة Dynatrace LLC. العلامات المذكورة تعود إلى مالكيها. تحقق دائمًا من القيم (المنافذ والإصدارات والأحجام) في الوثائق الرسمية الخاصة بإصدارك.