
Votre Collector de second niveau redémarre en boucle, ou la facture de traces ne baisse pas : dans les deux cas, ce sont vos règles tail sampling qu’il faut revoir, avant même de toucher au débit. Chaque règle ajoutée change ce que le processeur garde en mémoire, ce qu’il jette et ce qu’il envoie au backend. Ce n’est pas un détail de configuration : c’est un budget à arbitrer.
Cet article part de la décision d’exploitation plutôt que de la liste des politiques. Combien de mémoire accorder aux traces « en vol » ? Dans quel ordre composer les règles ? Quels pièges guettent après la mise en production ? Le principe de base du tail sampling est déjà posé dans le tutoriel tail sampling OpenTelemetry, et le routage par identifiant de trace dans l’article sur le load balancing trace ID : ici, on dimensionne et on règle.
Les faits viennent du README du processeur tail_sampling (dépôt opentelemetry-collector-contrib) et de la page d’échantillonnage d’opentelemetry.io, lus le 11 novembre 2026. Le traitement se fait dans le Collector, avant l’export OTLP : le raisonnement vaut donc pour Dynatrace SaaS comme pour Dynatrace Managed, et pour tout autre backend.
Ce que coûte une règle : de la mémoire avant tout
Le README classe le processeur dans les composants « stateful » (avertissement de statefulness) : il garde les spans en mémoire tant qu’il n’a pas décidé. Le coût d’un jeu de règles se lit donc en mémoire, bien avant le CPU. Trois réglages le gouvernent.
decision_wait(30 s par défaut) : le délai avant d’évaluer une trace. Le doubler double, à débit constant, le nombre de traces gardées en mémoire.num_traces(50 000 par défaut) : la taille du tampon circulaire. Quand une nouvelle trace arrive et que le tampon est plein, la plus ancienne est éjectée, même si elle n’a pas été évaluée.maximum_trace_size_bytes: une trace plus grosse est abandonnée d’emblée. C’est un garde-fou contre les traces monstres.
La règle de calcul qui en découle est de l’arithmétique, pas une formule officielle : il faut que num_traces soit au moins égal au nombre de nouvelles traces par seconde, par instance, multiplié par decision_wait. Voici un calcul d’exemple, avec des hypothèses que j’ai choisies et qu’il faut remplacer par vos mesures.
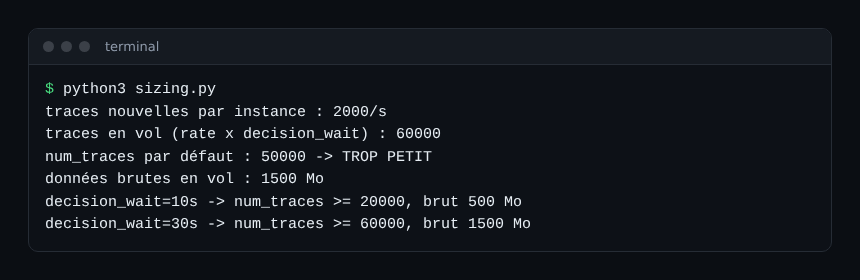
Dans cet exemple, le réglage par défaut est trop petit : le tampon éjecte des traces avant décision, et le README nomme la métrique qui le signale, sampling_trace_dropped_too_early. Descendre decision_wait à 10 s ramène le besoin à 20 000 traces. Je n’ai pas mesuré l’empreinte réelle en mémoire d’un span dans le processeur : les mégaoctets affichés sont des données brutes sous hypothèse, la consommation réelle sera plus élevée. Mesurez-la sur votre trafic avant de fixer les limites du pod.
Composer des règles tail sampling qui se répondent
Le processeur évalue toutes les politiques, puis tranche selon l’arbre de décision du README. En pratique : une politique drop qui se déclenche écarte la trace, une politique « sample » la garde, et dans tous les autres cas elle n’est pas gardée. Ce qui compte, c’est donc moins l’ordre que la nature de chaque règle.
Trois familles de règles
- Les exclusions :
dropécarte le bruit, par exemple les sondes de santé. Elle l’emporte sur les politiques qui voudraient garder la trace. - Les filets de sécurité :
status_codesurERRORetlatencyau-delà d’un seuil gardent ce que l’astreinte lira pour réduire le MTTR. - Le plafond de coût :
compositerépartit un nombre maximal de spans par seconde entre des sous-politiques. Un pourcentage derate_allocationréserve la place du service critique, et une probabiliste prend le reste.
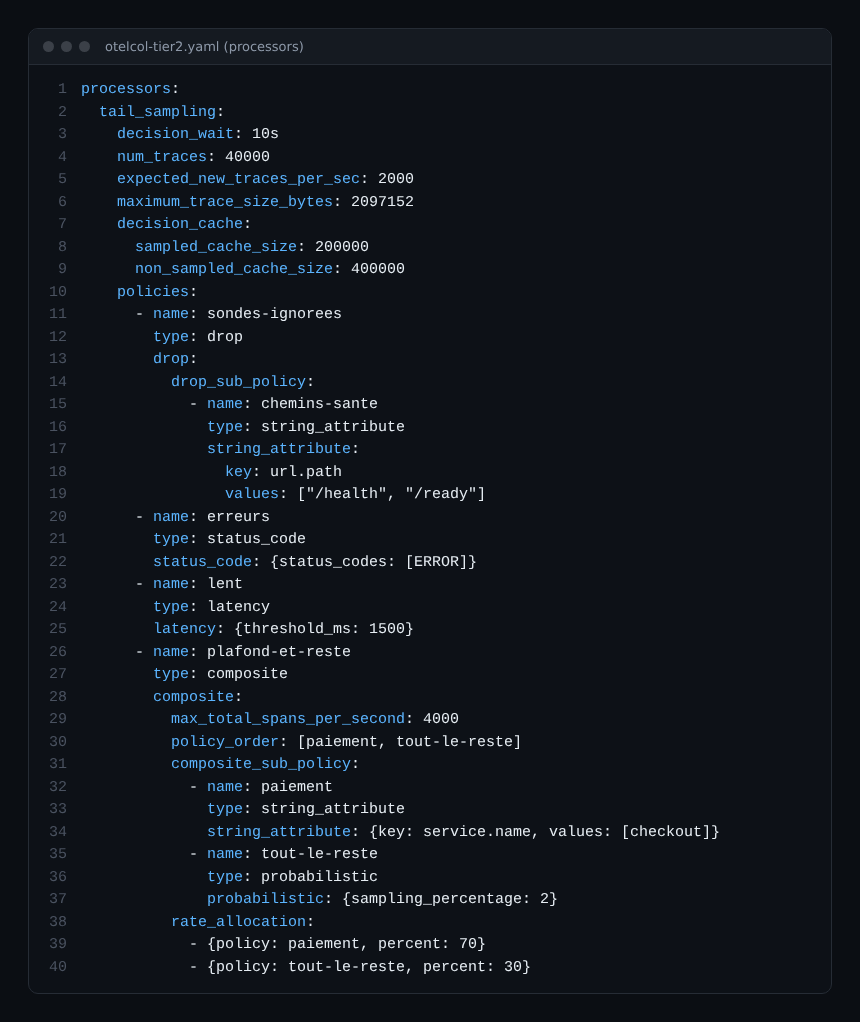
Cette configuration est un exemple écrit à partir du README : span.observer ne l’a pas exécutée dans un Collector, et les noms de services, seuils et chemins sont fictifs. Elle ne remplace pas un test sur votre trafic.
Deux nuances méritent l’attention. D’abord, le README recommande d’ajouter la politique probabilistic dans le processeur quand vous l’utilisez déjà : le surcoût est négligeable, et les traces gardées par d’autres règles ne sont pas jetées par un second échantillonneur en aval. Ensuite, sample_on_first_match décide dès qu’une politique correspond : c’est plus rapide, mais le README déconseille de l’associer à la porte de fonctionnalité usetracestate, car l’arrêt anticipé fausse les comptes ajustés en aval.
Les pièges des règles tail sampling en production
Les spans qui arrivent trop tard
Un span « tardif » arrive après la décision. Si la décision est encore dans le tampon, il en hérite. Sinon, sans cache, le processeur le traite comme une trace inconnue et ouvre une nouvelle fenêtre de decision_wait : une même trace peut alors être gardée à moitié. Le decision_cache (tailles sampled_cache_size et non_sampled_cache_size, à 0 par défaut) mémorise les identifiants décidés. Le README conseille de le dimensionner bien au-delà de num_traces.
Un seul Collector, ou plusieurs
Dès qu’il y a plusieurs instances, tous les spans d’une trace doivent atteindre la même. Le README recommande deux couches : l’exporteur de load balancing devant, le processeur derrière, pour isoler les pannes. Les détails de mise en place sont dans l’article dédié. Pour la place du processeur dans un pipeline, voir aussi les composants du Collector contrib : le README précise qu’il doit passer après les processeurs qui dépendent du contexte, comme k8sattributes, puisqu’il reconstitue de nouveaux lots.
Les limites de débit sous plusieurs shards
Avec num_shards supérieur à 1, num_traces et les limites par seconde sont répartis entre les shards. Le README précise que l’application devient approximative : une limite plus petite que le nombre de shards peut être dépassée en agrégat. Gardez num_shards à 1 tant que vous ne mesurez pas de contention.
Les composants encore mouvants
Le processeur est en stabilité beta pour les traces. Les décisions « inversées » (invert_match) sont dépréciées au profit de drop et not, et le stockage externe (tail_storage) reste derrière une porte de fonctionnalité en développement. Relisez le README à chaque montée de version du Collector.
Comment vérifier que ça fonctionne
Surveillez le processeur comme un service. Le README donne les métriques à suivre : traces éjectées avant décision, âge des traces au retrait, durée d’évaluation, part de traces gardées.
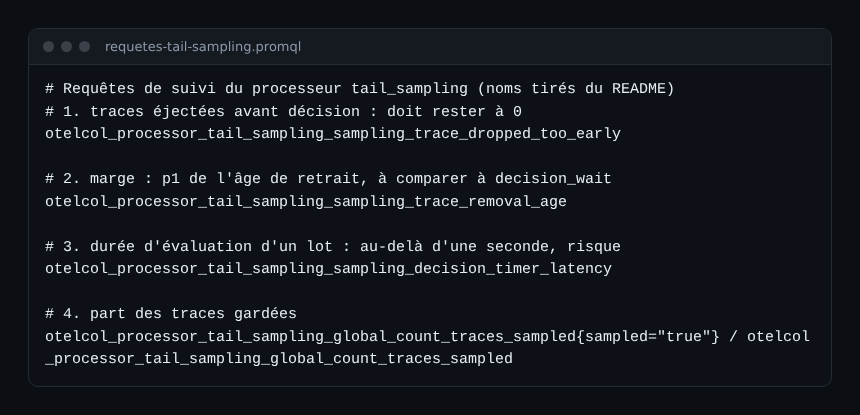
- La métrique
sampling_trace_dropped_too_earlydoit rester à zéro. Sinon, augmenteznum_tracesou baissezdecision_wait. - Comparez le p1 de
sampling_trace_removal_ageàdecision_wait: s’il s’en approche, la moindre hausse de trafic provoque des pertes. - Une
sampling_decision_timer_latencyau-delà d’une seconde peut retarder les décisions au-delà dedecision_wait, selon le README. - Pour savoir quelle règle a gardé une trace, activez la porte
processor.tailsamplingprocessor.recordpolicy: l’attributtailsampling.policyest alors ajouté aux spans gardés.
Bonnes pratiques
- Dimensionnez d’abord la mémoire, puis les règles : un jeu de règles parfait ne sert à rien si le tampon éjecte les traces.
- Posez les exclusions (
drop) et les filets (erreurs, lenteur) avant le plafond de coût. - Réservez une part du plafond aux services critiques plutôt qu’un pourcentage uniforme.
- Activez le cache de décisions dès que des traces longues ou des spans en retard existent.
- Gardez le gabarit de votre propre calcul dans le dépôt, avec les hypothèses, pour le refaire à chaque changement de trafic.
- Pour comprendre l’échantillonnage côté SDK, la page Sampling d’opentelemetry.io reste la référence.
Questions fréquentes
Quelle valeur donner à decision_wait ?
Celle de votre trace la plus longue que vous voulez voir complète, pas plus. Le défaut est de 30 s. Plus la valeur est grande, plus il faut de mémoire et plus les décisions arrivent tard.
Les règles tail sampling remplacent-elles l’échantillonnage dans les SDK ?
Non, elles le complètent. Le tail sampling ne voit que ce que les SDK envoient : si un SDK échantillonne en tête, il jette des traces avant que le Collector puisse les juger. Pour le tutoriel pas à pas, voir le Collector OpenTelemetry sur Kubernetes.
Faut-il un Collector par instance d’application ?
Non. Il faut un second niveau de Collectors qui reçoit toutes les traces par identifiant, comme décrit plus haut. Le nombre exact dépend de votre débit : mesurez-le avec le calcul de la première section.
Conclusion
Des règles tail sampling efficaces commencent par un budget mémoire et un délai de décision, puis une composition claire : exclure le bruit, garder les erreurs et les lenteurs, plafonner le reste. Surveillez ensuite les trois métriques du processeur, et relisez la documentation à chaque version. Référence : le README du processeur tail_sampling.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Les marques citées appartiennent à leurs propriétaires. Les exemples sont fictifs et n’ont pas été exécutés dans un Collector : vérifiez les options dans la documentation officielle de votre version.