
Tu Collector de segundo nivel se reinicia en bucle, o la factura de trazas no baja: en ambos casos lo que toca revisar son tus reglas de tail sampling, antes incluso de tocar el caudal. Cada regla que añades cambia lo que el procesador guarda en memoria, lo que descarta y lo que envía al backend. No es un detalle de configuración: es un presupuesto que hay que repartir.
Aquí partimos de la decisión de operación y no del catálogo de políticas. ¿Cuánta memoria das a las trazas «en vuelo»? ¿En qué orden compones las reglas? ¿Qué trampas aparecen después de pasar a producción? El principio del tail sampling ya está en el tutorial de tail sampling con OpenTelemetry, y el enrutado por identificador de traza en el artículo sobre load balancing por trace ID: aquí toca dimensionar y ajustar.
Los datos salen del README del procesador tail_sampling (repositorio opentelemetry-collector-contrib) y de la página de muestreo de opentelemetry.io, consultados el 11 de noviembre de 2026. El procesamiento ocurre en el Collector, antes de la exportación OTLP, así que el razonamiento vale para Dynatrace SaaS, para Dynatrace Managed y para cualquier otro backend.
Lo que cuesta una regla: memoria, ante todo
El README clasifica el procesador entre los componentes con estado (aviso de statefulness): conserva los spans en memoria hasta que decide. El coste de un conjunto de reglas se mide, por tanto, en memoria mucho antes que en CPU. Lo gobiernan tres ajustes.
decision_wait(30 s por defecto): el tiempo de espera antes de evaluar una traza. Duplicarlo duplica, con caudal constante, las trazas retenidas.num_traces(50 000 por defecto): el tamaño del búfer circular. Cuando llega una traza nueva y el búfer está lleno, se expulsa la más antigua, aunque no se haya evaluado.maximum_trace_size_bytes: una traza mayor se descarta de entrada. Es una protección contra las trazas gigantes.
La regla de cálculo que se deduce es aritmética, no una fórmula oficial: num_traces debe ser como mínimo el número de trazas nuevas por segundo y por instancia multiplicado por decision_wait. Este es un cálculo de ejemplo, con hipótesis que elegí yo y que debes sustituir por tus mediciones.
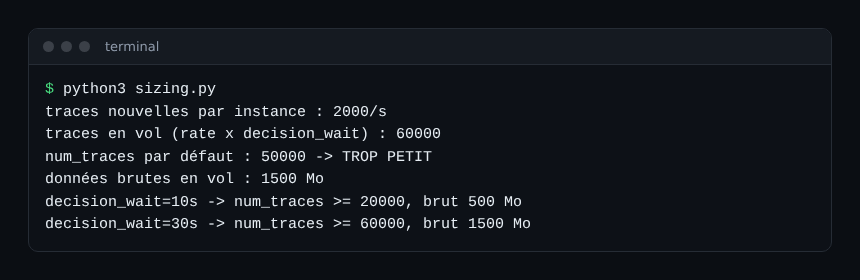
En este ejemplo el valor por defecto se queda corto: el búfer expulsa trazas antes de decidir, y el README nombra la métrica que lo avisa, sampling_trace_dropped_too_early. Bajar decision_wait a 10 s reduce la necesidad a 20 000 trazas. No he medido la huella real de un span en memoria dentro del procesador: los megabytes que se muestran son datos en bruto bajo hipótesis y el consumo real será mayor. Mídelo con tu tráfico antes de fijar los límites del pod.
Componer reglas de tail sampling que se complementen
El procesador evalúa todas las políticas y después resuelve según el árbol de decisión del README. En la práctica: si salta una política drop, la traza se descarta; si una política de muestreo la acepta, se conserva; en cualquier otro caso no se guarda. Importa menos el orden que la naturaleza de cada regla.
Tres familias de reglas
- Las exclusiones:
dropaparta el ruido, por ejemplo las sondas de salud. Prevalece sobre las políticas que querrían conservar la traza. - Las redes de seguridad:
status_codesobreERRORylatencypor encima de un umbral conservan lo que leerá la guardia para reducir el MTTR. - El tope de coste:
compositereparte un máximo de spans por segundo entre varias subpolíticas. Un porcentaje derate_allocationreserva sitio al servicio crítico y una política probabilística se queda con el resto.
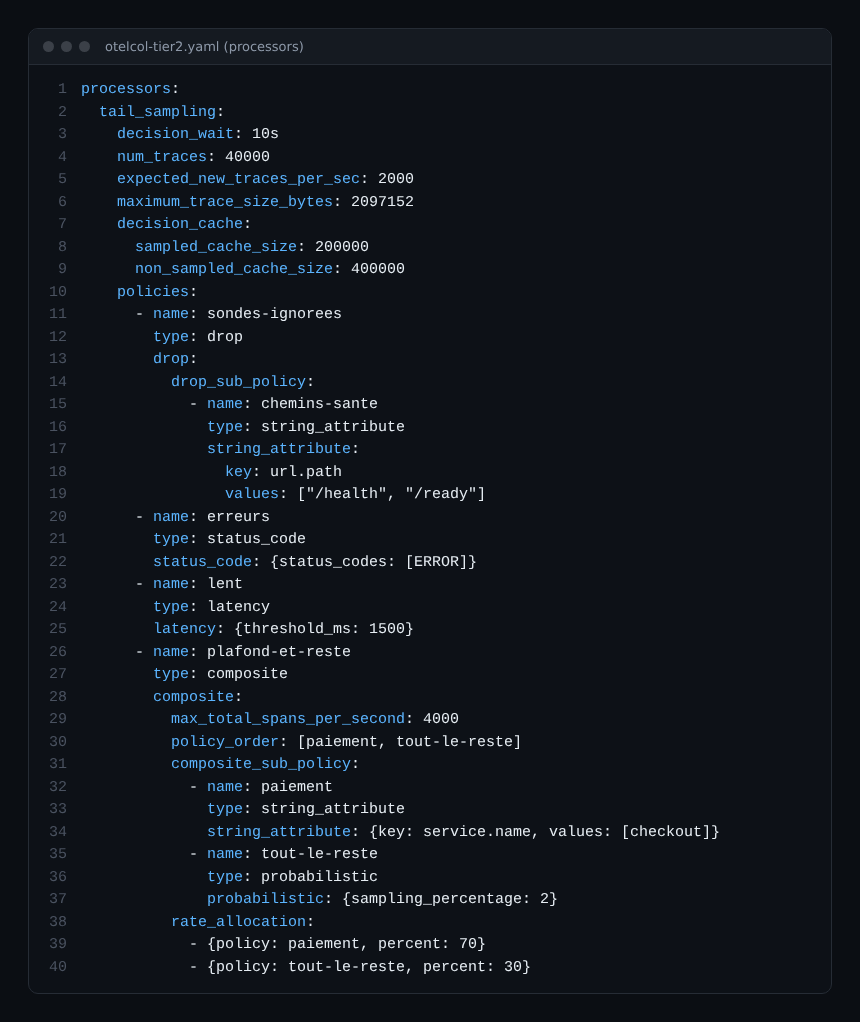
Esta configuración es un ejemplo escrito a partir del README: span.observer no la ha ejecutado en un Collector, y los nombres de servicio, umbrales y rutas son ficticios. No sustituye una prueba con tu tráfico.
Dos matices merecen atención. Primero, el README recomienda añadir la política probabilistic dentro del procesador si ya lo usas: el sobrecoste es despreciable y las trazas que conservan otras reglas no las tira un segundo muestreador aguas abajo. Segundo, sample_on_first_match decide en cuanto una política coincide: es más rápido, pero el README desaconseja combinarlo con la puerta de funcionalidad usetracestate, porque la parada anticipada falsea los recuentos ajustados aguas abajo.
Las trampas de las reglas de tail sampling en producción
Los spans que llegan tarde
Un span «tardío» llega después de la decisión. Si la decisión sigue en el búfer, la hereda. Si no, y no hay caché, el procesador lo trata como una traza desconocida y abre una nueva ventana de decision_wait: una misma traza puede quedar guardada a medias. La decision_cache (con los tamaños sampled_cache_size y non_sampled_cache_size, a 0 por defecto) recuerda los identificadores ya decididos. El README aconseja dimensionarla muy por encima de num_traces.
Un Collector o varios
En cuanto hay varias instancias, todos los spans de una traza deben llegar a la misma. El README recomienda dos capas: el exportador de load balancing delante y el procesador detrás, para aislar los fallos. Los detalles de la puesta en marcha están en el artículo dedicado. Para ubicar el procesador en un pipeline, consulta también los componentes del Collector contrib: el README precisa que debe ir después de los procesadores que dependen del contexto, como k8sattributes, porque reconstruye lotes nuevos.
Los límites de caudal con varios shards
Con num_shards mayor que 1, num_traces y los límites por segundo se reparten entre los shards. El README aclara que la aplicación pasa a ser aproximada: un límite menor que el número de shards puede superarse en conjunto. Deja num_shards en 1 mientras no midas contención.
Los componentes que aún se mueven
El procesador está en estabilidad beta para trazas. Las decisiones «invertidas» (invert_match) están obsoletas a favor de drop y not, y el almacenamiento externo (tail_storage) sigue tras una puerta de funcionalidad en desarrollo. Relee el README en cada actualización del Collector.
Cómo comprobar que funciona
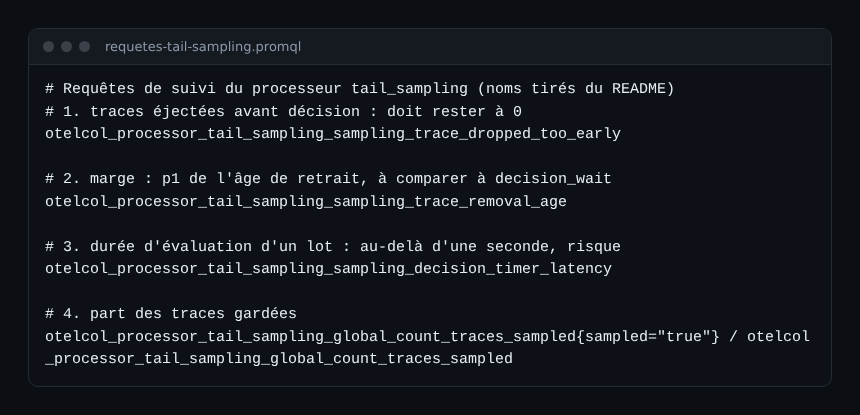
Vigila el procesador como un servicio más. El README indica las métricas a seguir: trazas expulsadas antes de decidir, edad de las trazas al retirarlas, duración de la evaluación y proporción de trazas conservadas.
- La métrica
sampling_trace_dropped_too_earlydebe mantenerse en cero. Si no, subenum_traceso bajadecision_wait. - Compara el p1 de
sampling_trace_removal_agecondecision_wait: si se le acerca, cualquier subida de tráfico provocará pérdidas. - Una
sampling_decision_timer_latencysuperior a un segundo puede retrasar las decisiones más allá dedecision_wait, según el README. - Para saber qué regla conservó una traza, activa la puerta
processor.tailsamplingprocessor.recordpolicy: el atributotailsampling.policyse añade entonces a los spans conservados.
Buenas prácticas
- Dimensiona primero la memoria y después las reglas: un conjunto de reglas perfecto no sirve de nada si el búfer expulsa las trazas.
- Coloca las exclusiones (
drop) y las redes de seguridad (errores, lentitud) antes del tope de coste. - Reserva una parte del tope para los servicios críticos en lugar de un porcentaje uniforme.
- Activa la caché de decisiones en cuanto haya trazas largas o spans tardíos.
- Guarda en el repositorio la plantilla de tu propio cálculo, con las hipótesis, para rehacerlo cada vez que cambie el tráfico.
- Para entender el muestreo en el lado del SDK, la página Sampling de opentelemetry.io sigue siendo la referencia.
Preguntas frecuentes
¿Qué valor conviene dar a decision_wait?
El de tu traza más larga que quieras ver completa, y no más. El valor por defecto es 30 s. Cuanto mayor es, más memoria hace falta y más tarde llegan las decisiones.
¿Las reglas de tail sampling sustituyen al muestreo en los SDK?
No, lo complementan. El tail sampling solo ve lo que envían los SDK: si un SDK muestrea al principio, descarta trazas antes de que el Collector pueda juzgarlas. Para el tutorial paso a paso, consulta el Collector de OpenTelemetry en Kubernetes.
¿Hace falta un Collector por cada instancia de la aplicación?
No. Hace falta un segundo nivel de Collectors que reciba todas las trazas por identificador, como se describe más arriba. El número exacto depende de tu caudal: calcúlalo con la primera sección.
Conclusión
Unas reglas de tail sampling eficaces empiezan con un presupuesto de memoria y un tiempo de decisión, y siguen con una composición clara: excluir el ruido, conservar errores y lentitud, y poner tope al resto. Después, vigila las métricas del procesador y relee la documentación en cada versión. Referencia: el README del procesador tail_sampling.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Las demás marcas citadas pertenecen a sus propietarios. Los ejemplos son ficticios y no se han ejecutado en un Collector: comprueba siempre los valores y las opciones en la documentación oficial correspondiente a tu versión.