

Antes de programar un experimento de chaos engineering con Dynatrace en producción, hazte una sola pregunta: «si corto o ralentizo este componente, ¿cómo sabré en diez minutos si el experimento va bien o debe detenerse?». Sin una respuesta con números, un fallo provocado es simplemente un fallo.
Este artículo parte de esa decisión operativa. No describe una herramienta de inyección: según la documentación y la entrada del fabricante que he leído, aquí Dynatrace sirve para medir (estado inicial, efectos, causa) y no para causar el fallo. La inyección sigue en tu herramienta habitual. La entrada original (Build systems more reliably with Dynatrace: Chaos Engineering, agosto de 2024, actualizada en enero de 2025) defiende una idea general parecida; el plan de abajo es mío.
Alcance: las aplicaciones Service-Level Objectives, Site Reliability Guardian (SRG) y Workflows de Dynatrace SaaS, que se apoyan en Grail y DQL. No he comprobado si están disponibles en Managed, así que no des nada por supuesto en ese caso.
El criterio de parada, antes de inyectar
Un experimento de caos es una prueba de hipótesis. Escríbela como un contrato de tres líneas: qué vas a romper, qué esperas que ocurra y qué umbral obliga a parar de inmediato. Si no puedes poner cifras en la segunda y la tercera, todavía no estás listo.
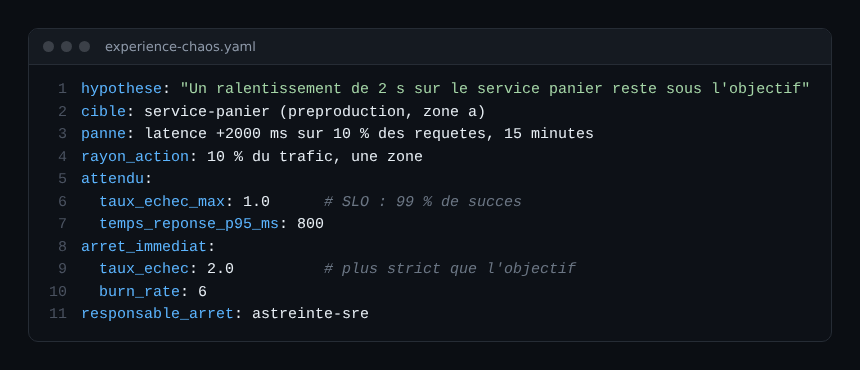
Este archivo contiene tres decisiones. El radio de impacto es pequeño a propósito (una zona, una fracción del tráfico). El resultado esperado se expresa como un objetivo de nivel de servicio. Los umbrales de parada son más estrictos que el objetivo, para poder interrumpir antes de agotar el presupuesto de errores. Para elegir bien los indicadores, consulta cómo elegir tus SLI en DQL.
Medir el estado inicial con DQL
El fallo clásico es construir la hipótesis sobre una sensación («este servicio es sólido»). Mide primero la línea base en un periodo normal, por ejemplo siete días, con un nivel de tráfico comparable al del experimento.
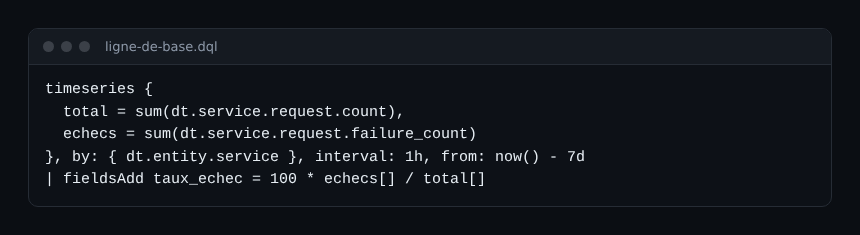
La consulta es un ejemplo que debes adaptar: revisa las claves de las métricas y las dimensiones en tu entorno antes de usarla, porque no la he ejecutado en ningún tenant. Quédate con el método: una tasa de fallos y un tiempo de respuesta por servicio, en un periodo comparable, anotados antes de cualquier inyección. Añade el número de problemas abiertos y su duración habitual para saber si el sistema ya está frágil ese día. Si la línea base ya es mala, aplaza el experimento.
Convertir la hipótesis en objetivos verificables
La plataforma ofrece dos piezas para esto, y responden a preguntas distintas.
- Un SLO: el indicador (SLI) es una serie normalizada de 0 a 100 % que calcula una consulta DQL y se compara con un objetivo en un periodo de evaluación. El presupuesto de errores es la diferencia entre el estado actual y el objetivo; el ritmo de consumo, o burn rate, indica a qué velocidad lo gastas. Durante el experimento, el burn rate te dice si la prueba sale demasiado cara. Mira las alertas de burn rate.
- Un guardian SRG: un conjunto de objetivos, cada uno alimentado por una consulta DQL y evaluado frente a umbrales de advertencia y de fallo. El resultado global es el más severo de los resultados individuales.
En un experimento, el guardian hace de árbitro. Un objetivo por cada línea de tu archivo de hipótesis: tasa de fallos, tiempo de respuesta y un indicador de capacidad si tocas la CPU. Los umbrales automáticos adaptativos necesitan al menos cinco validaciones superadas y devuelven «info» mientras tanto; en un primer experimento, fija umbrales estáticos sacados de tu línea base.
Automatizar la validación con un workflow
Un workflow puede llamar a la acción del guardian cuando termina la ventana de inyección, ya sea con un disparador por evento o con una llamada a demanda. El resultado expone un estado de validación (info, pass, warning, fail o error), un identificador y un enlace a la validación. De ahí sale una decisión clara: con pass se amplía el radio de impacto; con warning se repite con el mismo alcance; con fail se detiene todo y se abre el ticket. Es la misma lógica de una barrera de paso a producción, explicada en el artículo sobre SRG y los SLO de release, aplicada aquí a un fallo voluntario. Para los fundamentos de los workflows, consulta el módulo 7 de la formación SaaS.
Un detalle de vocabulario: la documentación de SRG llama a este paso «Site Reliability Guardian» al elegir la acción, «guardian validation action» en otros sitios y «run validation» en los workflows generados. Busca algo parecido, no el texto exacto.
Un chaos engineering en seis pasos
- Mide la línea base y anota la hora de inicio.
- Crea el guardian y el workflow; pruébalos primero sin fallo, el resultado debe ser
pass. - Avisa de la ventana a la guardia y nombra a la persona que puede interrumpir.
- Inyecta el fallo en el perímetro más pequeño posible, con tu herramienta de inyección.
- Deja correr la validación y vigila el burn rate; si se cruza el umbral de parada, corta sin discutir.
- Analiza: si hay un problema abierto, el análisis de causa raíz de Davis muestra si se atribuyó al fallo o a otra cosa; corrige y amplía un nivel.
La entrada del fabricante menciona, en su demo, una ralentización de peticiones y una restricción de CPU seguidas de un análisis de causa raíz. No he reproducido esa demostración: tómala como ejemplo de uso, no como un resultado medido en tu entorno.
Buenas prácticas
- Empieza en preproducción y pasa a producción solo con una fracción mínima del tráfico.
- Un cambio cada vez: nada de experimentos durante un despliegue.
- Mantén los umbrales de parada más estrictos que el SLO; si no, paras demasiado tarde.
- Guarda el rastro de cada experimento: hipótesis, línea base, resultado del guardian y corrección.
- Sin culpables: el experimento pone a prueba el sistema, no al equipo.
Preguntas frecuentes
¿Dynatrace provoca los fallos?
En las páginas de documentación y la entrada que he leído, no: describen la medición, el análisis y la automatización de la decisión. La inyección corresponde a otra herramienta. Si buscas una función nativa, revisa las novedades de tu versión.
¿Hace falta un SLO o un guardian?
Sirven los dos. El SLO sigue al servicio a lo largo del tiempo y vigila su presupuesto de errores; el guardian da un veredicto puntual sobre una ventana concreta, lo que encaja con un experimento.
¿Se puede probar directamente en producción?
Solo con un radio de impacto reducido, una línea base sólida y un criterio de parada automático. Si dudas, empieza en preproducción.
Conclusión
El chaos engineering con Dynatrace empieza por la medición: una línea base, umbrales de parada y un veredicto automatizado. El fallo llega después. Para profundizar, la lógica del presupuesto de errores está detallada en el artículo sobre el presupuesto de errores como barrera de release. Fuentes oficiales: Site Reliability Guardian y Service-Level Objectives.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Las funciones evolucionan: comprueba siempre los valores y el comportamiento en la documentación oficial correspondiente a tu versión.