Muchos equipos SRE empezaron con Prometheus y Grafana y después añadieron Loki para los logs y Tempo para las trazas. El día que la plataforma crece, llega la pregunta: Dynatrace vs Grafana, ¿hay que seguir operando esta stack de código abierto o pasar a una plataforma integrada?
La comparación es engañosa, porque no se comparan dos productos del mismo tipo. Por un lado, cuatro proyectos de código abierto que tú ensamblas, configuras y operas (o que consumes mediante la oferta gestionada Grafana Cloud). Por otro, una plataforma única con agente, almacenamiento, análisis de causas e interfaz. El verdadero asunto no es «cuál muestra los gráficos más bonitos», sino cuánto cuesta, en tiempo de equipo, cada minuto ganado en un incidente.
Este artículo ofrece una rejilla de comparación factual y una POC con OpenTelemetry que alimenta ambos mundos con las mismas trazas, métricas y logs. Por el lado de Dynatrace, la POC se refiere a Dynatrace SaaS; los puntos propios de Dynatrace Managed están señalados. Por el lado de Grafana, se refiere a la stack autoalojada.
Dynatrace vs Grafana: qué se compara realmente
| Criterio | Dynatrace | Stack de Grafana |
|---|---|---|
| Componentes | Una plataforma: OneAgent, Dynatrace Operator, Grail (SaaS), interfaz y análisis de causas | Prometheus (métricas), Loki (logs), Tempo (trazas), Grafana (visualización y alertas) |
| Licencia | Comercial | Grafana, Loki y Tempo bajo AGPLv3; Prometheus bajo Apache 2.0 |
| Lenguajes | DQL para todas las señales (SaaS) | PromQL (métricas), LogQL (logs), TraceQL (trazas) |
| Correlación | Topología Smartscape y análisis causal (Dynatrace Intelligence en SaaS, Davis AI en Managed) | Vínculos entre fuentes de datos configurados en Grafana, etiquetas comunes |
| Alojamiento | SaaS, o Managed en tu centro de datos | Autoalojado, o Grafana Cloud (gestionado) |
| Operación | Actualizaciones de la plataforma a cargo del proveedor (SaaS) o mediante la CMC (Managed) | Dimensionamiento, almacenamiento, retención, alta disponibilidad y actualizaciones a tu cargo (en autoalojado) |
Los SLO son un caso particular, ya tratado en la comparativa de SLO de Dynatrace, Grafana y Prometheus. Para el mismo método aplicado a un proveedor SaaS, consulta Dynatrace vs Datadog.
Requisitos previos de la POC
- Un tenant de prueba de Dynatrace SaaS y un token de acceso con los scopes
openTelemetryTrace.ingest,metrics.ingestylogs.ingest. - Prometheus, Loki, Tempo y Grafana desplegados en un clúster de pruebas (charts de Helm oficiales o los manifiestos que prefieras).
- Un OpenTelemetry Collector (distribución contrib), desplegado como en nuestra guía del Collector en Kubernetes.
- Una aplicación de demostración instrumentada con OpenTelemetry.
Paso 1: abrir los puntos de entrada OTLP de la stack de Grafana
Los tres backends saben recibir OTLP, siempre que lo actives:
- Prometheus: el receptor OTLP está desactivado por defecto. Inicia Prometheus con
--web.enable-otlp-receiver; entonces sirve la ruta/api/v1/otlp/v1/metrics. - Loki: la documentación de Loki indica exportar los logs a
http://<loki-addr>/otlpcon el exportadorotlphttp. - Tempo: activa el receptor
otlpen la seccióndistributor.receivers, con los protocolosgrpc(4317 por defecto) yhttp(4318 por defecto).
prometheus --config.file=prometheus.yml --web.enable-otlp-receiverPaso 2: un Collector, dos destinos
El Collector recibe la telemetría de la aplicación y la duplica: una copia hacia Dynatrace y una copia hacia cada backend de Grafana.
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317
      http:
        endpoint: 0.0.0.0:4318

processors:
  batch: {}

exporters:
  otlphttp/dynatrace:
    endpoint: https://${env:DT_ENV_ID}.live.dynatrace.com/api/v2/otlp
    headers:
      Authorization: "Api-Token ${env:DT_API_TOKEN}"
  otlphttp/prometheus:
    endpoint: http://prometheus.monitoring.svc:9090/api/v1/otlp
  otlphttp/loki:
    endpoint: http://loki.monitoring.svc:3100/otlp
  otlp/tempo:
    endpoint: tempo.monitoring.svc:4317
    tls:
      insecure: true

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlphttp/dynatrace, otlp/tempo]
    metrics:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlphttp/dynatrace, otlphttp/prometheus]
    logs:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlphttp/dynatrace, otlphttp/loki]
Líneas críticas:
otlphttp/prometheus: el exportador añade/v1/metricsa la URL base; no lo escribas tú. Adapta el nombre del servicio y el puerto a tu despliegue.otlphttp/loki: la dirección de Loki depende de tu chart (modo monolítico o distribuido); comprueba el servicio expuesto.tls.insecure: aceptable para tráfico interno del clúster de pruebas, nunca hacia el exterior.- En Managed, la URL de Dynatrace pasa a ser
https://{votre-domaine}/e/{id-environnement}/api/v2/otlp.
Hay un punto que merece atención en las métricas: Dynatrace espera sumas OTLP con temporalidad delta, mientras que el modelo de Prometheus es acumulativo. Con un solo flujo, añade el procesador cumulativetodelta en un pipeline dedicado a Dynatrace. El tema se detalla en la temporalidad de las métricas OTLP. Ten en cuenta también que Tempo escucha por defecto en localhost: configura una dirección de escucha accesible desde el Collector. Si mantienes Prometheus para el scraping, la integración de Prometheus con Dynatrace es una alternativa.
Paso 3: comparar el diagnóstico y el esfuerzo de operación
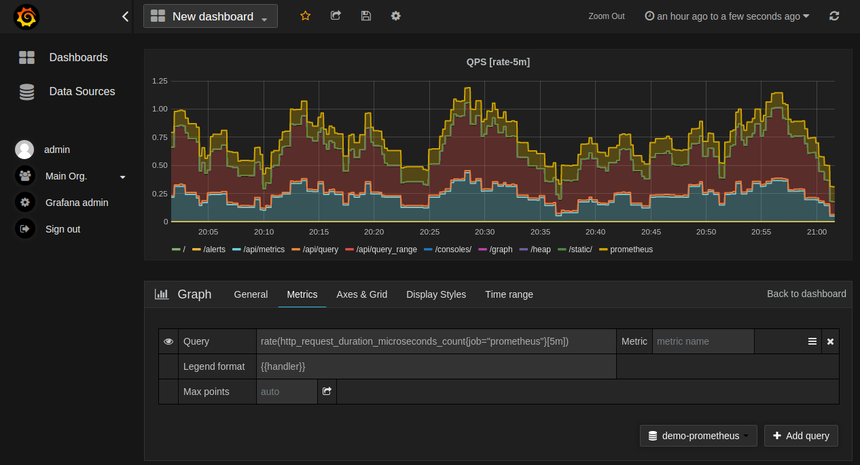
En Grafana, cada panel se apoya en una consulta escrita en el lenguaje de su fuente, como la consulta PromQL de arriba. En Dynatrace SaaS, la misma vista se escribe en DQL:
fetch spans, from: now() - 1h
| filter service.name == "checkout"
| summarize p95 = percentile(duration, 95), appels = count(), by:{span.name}
Puntúa después cada plataforma según estos criterios, con pruebas:
- Tiempo de diagnóstico: tres fallos inyectados, cronometrados por una persona que no conozca el escenario.
- Navegación entre señales: pasar de una métrica degradada a la traza y después a los logs, sin copiar ningún identificador a mano.
- Toil de operación: horas al mes dedicadas a las actualizaciones, el almacenamiento, la retención y las caídas de la propia stack de observabilidad.
- Cobertura: lo que aparece sin código (agente, autoinstrumentación) y lo que exige configuración por servicio.
- Competencias: tres lenguajes (PromQL, LogQL, TraceQL) que dominar de un lado, uno solo (DQL) del otro.
Cómo comprobar que funciona
- Dynatrace:
fetch spans, from: now() - 15m | filter service.name == "checkout" | summarize count()devuelve spans. - Grafana: Explore de la fuente Tempo encuentra trazas del servicio; la fuente Loki devuelve logs; una consulta PromQL sobre una métrica de la aplicación devuelve series.
- Collector:
kubectl logs deploy/otel-collector | grep -i errorno muestra ningún error de exportación.
Buenas prácticas
- Cuantifica el tiempo de operación de la stack de código abierto: es un coste real, aunque no haya licencia.
- Mantén OpenTelemetry como capa de instrumentación: podrás cambiar de backend sin tocar el código.
- Compara con el mismo alcance: mismo muestreo (consulta el tail sampling), misma retención.
- Involucra a la guardia (on-call): son quienes vivirán con la herramienta a las tres de la madrugada.
Preguntas frecuentes
¿Es gratuita la stack de Grafana?
El software es de código abierto, pero la infraestructura, el almacenamiento y el tiempo de operación no lo son. En autoalojado pagas en horas de equipo; con Grafana Cloud pagas un servicio gestionado. Compara esos costes reales con una oferta de Dynatrace por escrito.
¿Se pueden mostrar datos de Dynatrace en Grafana?
El Collector permite enviar los mismos datos a ambos, como en esta POC. Es útil durante una migración, pero mantener dos fuentes de verdad acaba costando caro.
¿Cambia Dynatrace Managed la comparación?
Sí, en el alojamiento: Managed permite, igual que la stack de Grafana autoalojada, conservar los datos en tu casa. En cambio, DQL y Grail son propios de Dynatrace SaaS; Managed usa el metric selector y sus propias pantallas.
Conclusión
Dynatrace vs Grafana enfrenta sobre todo dos modelos de operación: ensamblar y operar piezas de código abierto, o consumir una plataforma integrada. Una POC alimentada por el mismo Collector, con el toil medido igual que el tiempo de diagnóstico, permite decidir con cifras en lugar de preferencias.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Grafana Labs. Dynatrace, Grafana, Loki, Tempo y Prometheus son marcas de sus respectivos propietarios. Comprueba las opciones en la documentación oficial (Prometheus y OpenTelemetry, Loki y OpenTelemetry, API OTLP de Dynatrace). Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.