El viernes, en la reunión de equipo, alguien suelta la pregunta: ¿podemos alojar un modelo abierto grande en el equipo de la oficina, sin un servidor de ocho GPU? Con un modelo MoE local, la respuesta no depende tanto de la potencia de cálculo como de un equilibrio entre RAM, disco y paciencia. Colibri, un repositorio de GitHub de inferencia escrito en C, se ofrece justo para hacer ese reparto por ti.
Parto de la decisión operativa, no de la instalación: ¿qué conviene saber antes de bajar 400 GB? Aviso de método: no he ejecutado Colibri. Todo sale del repositorio JustVugg/colibri, leído el 10 de noviembre de 2026 (README, CHANGELOG y documentación de la API). Las velocidades citadas son las del propio proyecto, medidas en sus máquinas.
El código está bajo licencia Apache 2.0. La versión 2.1.0 es del 31 de octubre de 2026 y hay actividad a diario. GitHub mostraba unas 49 500 estrellas y 5800 forks (cifras redondeadas por la página, no exactas). Es un proyecto joven y veloz: toma sus números como mediciones que hay que reproducir.
Modelo MoE local: por qué la RAM ya no es el único cuello de botella
Un modelo MoE (mixture of experts, mezcla de expertos) ocupa muchísimo en disco, pero trabaja poco por token. Según el README, GLM-5.2 tiene 744 000 millones de parámetros, activa unos 40 000 millones por token (el 5,4 %) y solo cambian de un token al siguiente unos 11 GB: los expertos enrutados.
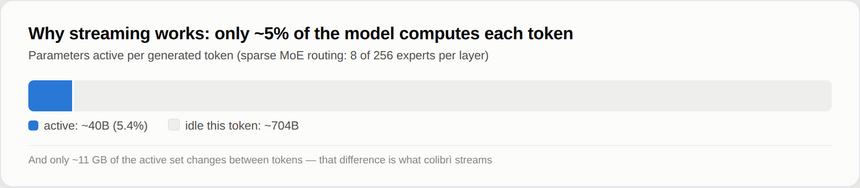
La consecuencia práctica es sencilla. El modelo no necesita caber en memoria rápida: necesita estar bien colocado. Colibri mantiene en RAM la parte densa (atención, expertos compartidos, embeddings) y va leyendo del disco los expertos que hacen falta, a través de una caché que aprende cuáles pide tu uso. Si hay GPU, se queda con los expertos más solicitados.
El proyecto insiste en algo: dónde viva un peso solo afecta a la velocidad, no al resultado. Menos memoria rápida puede costar tiempo, nunca precisión del modelo, afirma el README. Es una promesa del proyecto que no puedo confirmar sin medirla.
Cuántos tokens por segundo: lee la tabla antes de ilusionarte
Para cada modelo, el README da un mínimo de RAM por debajo del cual no arranca nada y un segundo umbral a partir del cual se alcanza la velocidad medida. Algunas filas, tal como se publican:
- Qwen3.6-35B-A3B (23 GB de descarga): 6,0 tokens/s en CPU y 30,0 con CUDA en una RTX 3070;
- DeepSeek V4 Flash (167 GB): 0,93 token/s con 32 GB de RAM, solo CPU;
- GLM-5.2 (429 GB, mínimo 16 GB de RAM): de 0,05 a 0,1 token/s en frío en un portátil con 25 GB, 1,83 en una máquina de 128 GB y de 9,0 a 9,2 con seis RTX 5090;
- Kimi K3 (1,56 TB): unos 9,4 segundos por token.
Léelo como un SRE lee un SLO: un portátil que suelta un token cada diez o veinte segundos responde «bien», pero no atiende a ningún usuario. Para trabajos por lotes nocturnos, evaluaciones o un asistente personal, menos de un token por segundo puede bastar. Si el equipo conversa en directo, apunta a modelos pequeños o a una GPU.
En los modelos grandes manda el disco. El proyecto señala que un NVMe rápido es lo que más ayuda y que dos NVMe en controladoras independientes midieron un 37,5 % más de caudal de generación. Un único disco lento no es un detalle: es tu techo.
Instalar Colibri: lo que dice el README
Hardware mínimo anunciado: 8 GB de RAM (se aconsejan 16 GB o más), 22 GB libres para el modelo más pequeño y conexión a internet. La GPU es opcional; según el motor se admiten Vulkan, CUDA y Metal. El camino de un solo paso en Linux:
sudo apt install git python3 build-essential
git clone https://github.com/JustVugg/colibri
cd colibri
./start-here.sh
En Windows se descomprime el archivo y se ejecuta START-HERE.bat; en macOS se instalan Xcode CLT, libomp, git y python con Homebrew y se lanza el mismo script. El programa analiza el equipo, recomienda el modelo más capaz que cabe en RAM, compila el motor, descarga con reanudación y abre el panel. Opciones útiles: --list compara todos los modelos con tu máquina, --model ID fuerza uno y --dir cambia el disco de destino.
Antes de comprometer 400 GB, el lanzador trae tres comandos pensados para decidir, siempre según el README: coli plan muestra dónde vivirá el modelo (VRAM, RAM, disco), coli doctor comprueba sin modificar nada y coli tune mide y guarda los ajustes seguros más rápidos para tu máquina.
Ver trabajar a los expertos
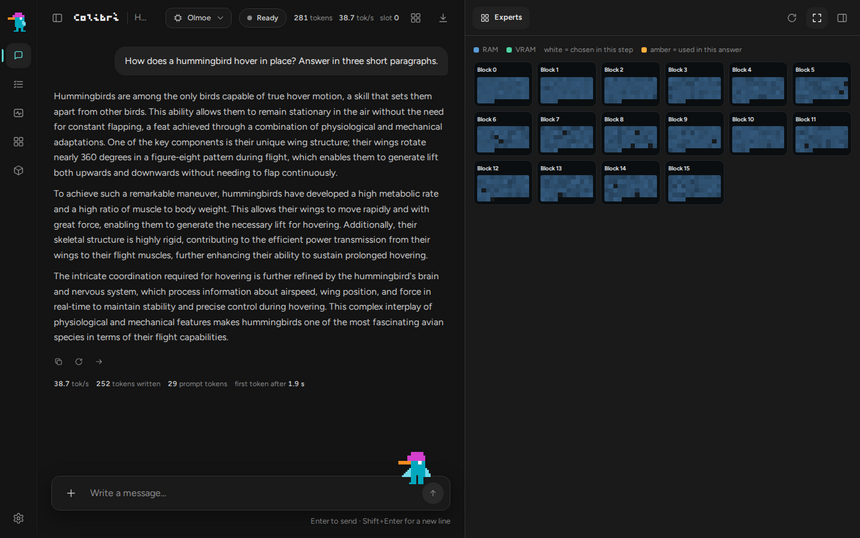
El panel (coli web) y la interfaz coli ui muestran un mapa de expertos: una celda por experto en cada bloque, blanca si se elige en el paso actual y ámbar si participó en la respuesta. La captura siguiente muestra OLMoE, el modelo pequeño de 7000 millones de parámetros que el proyecto recomienda para aprender las herramientas.
Una segunda pantalla, el monitor, indica el estado del modelo (inactivo, leyendo, escribiendo), la velocidad, la lectura del prompt, y la RAM y la CPU del motor.
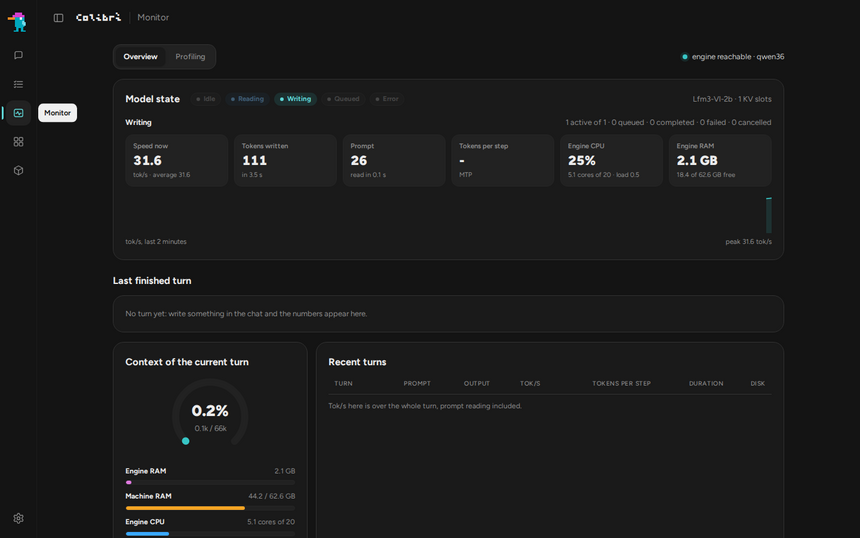
Ambas capturas salen del repositorio del proyecto (licencia Apache 2.0). No enseñan un modelo grande sufriendo, sino modelos pequeños a gusto. No las tomes como prueba de velocidad con 744 000 millones de parámetros.
Exponer y supervisar el servidor
coli serve arranca un servidor compatible con OpenAI (/v1/chat/completions) y con Anthropic (/v1/messages). Por defecto escucha en localhost. Según la documentación, hay que definir COLI_API_KEY antes de abrirlo a la red. Hazlo lo primero: un servidor de inferencia sin clave en una red corporativa es una puerta de entrada gratis.
Para la supervisión, la documentación de la API describe dos endpoints útiles. GET /health expone los contadores de peticiones activas, en cola, terminadas y rechazadas, responde 503 con {"status": "restarting"} mientras el motor se reinicia y cuenta los reinicios en engine_restarts. GET /metrics devuelve texto Prometheus cuyos nombres empiezan todos por colibri_scheduler_, con gauges (active, queued), contadores (completed_total, failed_total, rejected_total, timed_out_total) e histogramas (queue_wait_seconds, first_output_seconds, engine_call_seconds). Las métricas no incluyen ni prompts ni rutas de modelo.
Un Collector de OpenTelemetry puede recogerlas con el receptor de Prometheus. Ejemplo mínimo, para adaptar (el destino y el exportador son valores de ejemplo):
receivers:
  prometheus:
    config:
      scrape_configs:
        - job_name: colibri
          scrape_interval: 30s
          authorization:
            credentials: ${env:COLI_API_KEY}
          static_configs:
            - targets: ["127.0.0.1:8000"]
exporters:
  otlphttp:
    endpoint: ${env:OTLP_ENDPOINT}
service:
  pipelines:
    metrics:
      receivers: [prometheus]
      exporters: [otlphttp]
No he probado esta configuración con Colibri ni he comprobado la ingesta en Dynatrace, Managed o SaaS: es un Collector estándar. Las señales que merece la pena seguir: queue_wait_seconds para la contención, first_output_seconds para lo que espera el usuario, y failed_total junto con engine_restarts para detectar un motor abatido por el gestor de memoria. Si quieres profundizar en la supervisión de un motor local, mira nuestro artículo sobre Ollama y el de vLLM en producción.
Límites y asuntos abiertos
- El repositorio es joven y cambia rápido: 387 pull requests entre las versiones 2.0.0 y 2.1.0, según el CHANGELOG. Fija una versión.
- El propio proyecto guarda sus vías de optimización en una lista de hipótesis por reproducir, con fracasos publicados; por ejemplo, una especulación MTP que midió un 32 % más lenta con un acierto de caché cercano al 85 %. Buena señal de honestidad, pero también prueba de que los ajustes se miden máquina por máquina.
- Todas las velocidades vienen del proyecto: ninguna se ha reproducido aquí.
- Algunos modelos tienen licencia propia (Qwen-Image no comercial, Muse Spark Open bajo un acuerdo con Meta): la Apache 2.0 del motor no cubre los pesos.
- Compáralo con motores más extendidos antes de decidir: consulta la comparativa de Ollama, vLLM y llama.cpp y, para un modelo grande en GPU, el autoalojamiento de Mistral Large 4.
Buenas prácticas
- Empieza con un modelo pequeño (OLMoE o Qwen3.6) para validar toda la cadena antes de la descarga grande.
- Coloca los modelos en el NVMe más rápido, nunca en un montaje de red ni en
/mnt/cbajo WSL, algo que el README desaconseja. - Define
COLI_API_KEYy deja la escucha en localhost hasta que haya un proxy inverso con autenticación. - Recoge
/metricsdesde el primer día, con una alerta sobrefailed_totaly otra sobre la duración defirst_output_seconds. - Anota tus propias mediciones (hardware, comando, estado de la caché): el proyecto las pide, y son las que te darán un SLO creíble.
Preguntas frecuentes
¿Hace falta una GPU para un modelo MoE local con Colibri?
No, según el README: todos los motores funcionan en CPU. La GPU es solo un sitio más rápido donde guardar pesos. En los modelos grandes la velocidad la fija el disco; en los pequeños, la RAM.
¿Qué velocidad esperar en un equipo corriente?
Varía más de 100 veces según el modelo: de unos pocos tokens por segundo en uno de 35 000 millones de parámetros a menos de un token por segundo en los gigantes. Mide con coli tune en tu hardware en lugar de fiarte de una tabla.
¿Sirve Colibri para un equipo de trabajo?
El servidor gestiona una cola, huecos de caché y rechazos 429, pero no he comprobado cómo se comporta bajo carga. Prueba con tus casos de uso y vigila la cola antes de abrir el servicio.
Conclusión
Un modelo MoE local es realista porque solo una pequeña fracción de los parámetros trabaja en cada token. Colibri lleva esa idea hasta el final: la RAM guarda el núcleo del modelo y el disco guarda el resto. Antes de descargar, mira la fila de tu máquina en la tabla, ejecuta coli plan y conecta /metrics para que la velocidad anunciada pase a ser una velocidad medida.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Colibri es un proyecto de terceros; la información procede de su repositorio público y puede cambiar, así que compruébala antes de llevarla a producción.