

Avant de planifier une expérience de chaos engineering avec Dynatrace en production, une seule question compte : « si je coupe ou ralentis ce composant, comment saurai-je en dix minutes que l’expérience a réussi, ou qu’elle doit s’arrêter ? ». Sans réponse chiffrée, une panne volontaire n’est qu’une panne.
Cet article part de cette décision d’exploitation. Il ne décrit pas un outil d’injection : d’après la documentation et le billet de l’éditeur que j’ai lus, Dynatrace sert ici à mesurer (état de départ, effets, cause), pas à provoquer la panne. L’injection reste à votre outil habituel. Le billet d’origine (Build systems more reliably with Dynatrace: Chaos Engineering, août 2024, mis à jour en janvier 2025) défend la même idée générale ; le plan ci-dessous est le mien.
Périmètre : les applications Service-Level Objectives, Site Reliability Guardian (SRG) et Workflows de Dynatrace SaaS, qui reposent sur Grail et DQL. Je n’ai pas vérifié leur disponibilité sur Managed : ne supposez rien pour ce cas.
Le critère d’arrêt avant l’injection
Une expérience de chaos est un test d’hypothèse. Écrivez-la comme un contrat de trois lignes : ce que vous cassez, ce que vous attendez, et le seuil qui déclenche l’arrêt immédiat. Si vous ne pouvez pas chiffrer la deuxième et la troisième ligne, vous n’êtes pas prêt.
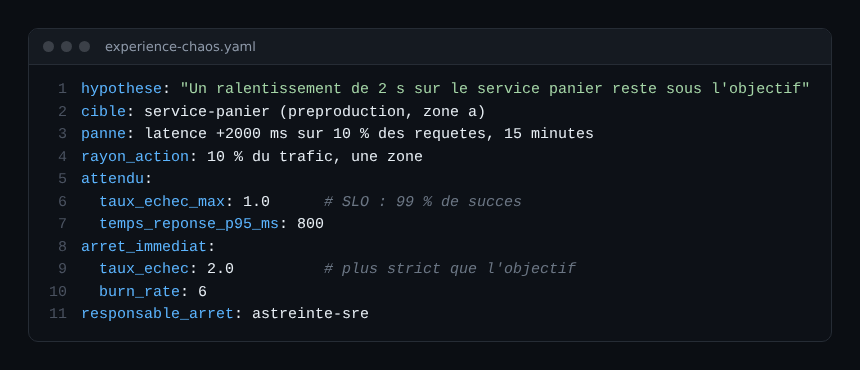
Trois choix sont dans ce fichier. Le rayon d’action est volontairement petit (une zone, une part du trafic). Le résultat attendu est exprimé comme un objectif de niveau de service. Les seuils d’arrêt sont plus stricts que l’objectif, pour pouvoir interrompre avant d’épuiser le budget d’erreur. Pour choisir les bons indicateurs, voir comment choisir ses SLI en DQL.
Mesurer l’état de départ avec DQL
Le point faible classique : une hypothèse bâtie sur une impression (« ce service est solide »). Relevez d’abord la ligne de base sur une période normale, par exemple sept jours, au même niveau de trafic que celui de l’expérience.
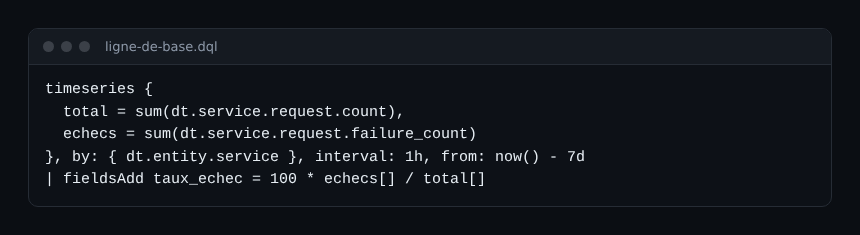
La requête est un exemple à adapter : vérifiez les clés de métriques et les dimensions dans votre environnement avant de l’utiliser, je ne l’ai pas exécutée sur un tenant. Retenez la méthode : un taux d’échec et un temps de réponse par service, sur une période comparable, notés avant toute injection. Ajoutez le nombre de problèmes ouverts et leur durée habituelle, pour savoir si votre système est déjà fragile ce jour-là. Si la ligne de base est déjà mauvaise, reportez l’expérience.
Traduire l’hypothèse en objectifs vérifiables
Deux briques de la plateforme servent à cela, et elles ne répondent pas à la même question.
- Un SLO : l’indicateur (SLI) est une série normalisée de 0 à 100 % calculée par une requête DQL, comparée à une cible sur une période d’évaluation. Le budget d’erreur est l’écart entre le statut et la cible ; le taux de consommation, ou burn rate, indique à quelle vitesse vous le brûlez. Pendant l’expérience, c’est le burn rate qui dit si le test coûte trop cher. Voir les alertes de burn rate.
- Un guardian SRG : un groupe d’objectifs, chacun alimenté par une requête DQL et jugé contre des seuils d’avertissement et d’échec. Le résultat global est le plus sévère des résultats individuels.
Pour une expérience, le guardian joue le rôle de juge de paix. Un objectif par ligne de votre fichier d’hypothèse : taux d’échec, temps de réponse, et un indicateur de capacité si vous touchez au CPU. Les seuils automatiques d’adaptation exigent au moins cinq validations passées et renvoient « info » avant : pour une première expérience, fixez des seuils statiques tirés de votre ligne de base.
Automatiser la validation avec un workflow
Un workflow peut appeler l’action du guardian après la fenêtre d’injection, avec un déclencheur sur événement ou un appel à la demande. Le résultat expose un statut de validation (info, pass, warning, fail ou error), un identifiant et un lien vers la validation. Vous pouvez en tirer une décision claire : pass, on élargit le rayon d’action ; warning, on répète à périmètre égal ; fail, on arrête et on ouvre le ticket. Cette logique est la même que celle d’une barrière de mise en production, décrite dans l’article sur SRG et les SLO de release, appliquée ici à une panne volontaire. Pour les bases des workflows, voir le module 7 de la formation SaaS.
Attention à un point de vocabulaire : la documentation de SRG appelle cette étape « Site Reliability Guardian » dans le choix d’action, « guardian validation action » ailleurs, et « run validation » dans les workflows générés. Cherchez la ressemblance, pas le libellé exact.
Un chaos engineering en six temps
- Relevez la ligne de base et notez l’heure de début.
- Créez le guardian et le workflow ; testez-les d’abord sans panne, le résultat doit être
pass. - Annoncez la fenêtre à l’astreinte et nommez la personne qui peut interrompre.
- Injectez la panne sur le plus petit périmètre, avec votre outil d’injection.
- Laissez la validation tourner et regardez le burn rate ; si le seuil d’arrêt est franchi, coupez sans discuter.
- Analysez : si un problème est ouvert, l’analyse de cause racine de Davis montre s’il a été attribué à la panne ou à autre chose ; corrigez, puis élargissez d’un cran.
Le billet de l’éditeur mentionne, sur sa démo, un ralentissement de requêtes et une contrainte de CPU suivis d’une analyse de cause racine. Je n’ai pas rejoué cette démonstration : traitez-la comme un exemple d’usage, pas comme un résultat mesuré chez vous.
Bonnes pratiques
- Commencez en préproduction, puis en production sur une part minime du trafic.
- Un seul changement à la fois : pas d’expérience pendant un déploiement.
- Gardez les seuils d’arrêt plus stricts que le SLO, sinon vous arrêtez trop tard.
- Gardez la trace de chaque expérience : hypothèse, ligne de base, résultat du guardian, correctif.
- Ton blameless : l’expérience teste le système, pas l’équipe.
Questions fréquentes
Dynatrace injecte-t-il les pannes ?
Dans les pages de documentation et le billet que j’ai lus, non : ils décrivent la mesure, l’analyse et l’automatisation de la décision. L’injection relève d’un autre outil. Vérifiez les nouveautés de votre version si vous cherchez une fonction native.
Faut-il un SLO ou un guardian ?
Les deux servent. Le SLO suit le service dans la durée et son budget d’erreur ; le guardian rend un verdict ponctuel sur une fenêtre précise, ce qui convient à une expérience.
Peut-on tester directement en production ?
Seulement avec un rayon d’action réduit, une ligne de base solide et un critère d’arrêt automatique. Dans le doute, commencez en préproduction.
Conclusion
Le chaos engineering avec Dynatrace commence par la mesure : une ligne de base, des seuils d’arrêt et un verdict automatisé. La panne vient ensuite. Pour aller plus loin, la logique de budget d’erreur est détaillée dans l’article sur le budget d’erreur comme barrière de release. Sources officielles : Site Reliability Guardian et Service-Level Objectives.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Dynatrace est une marque de Dynatrace LLC. Les fonctions évoluent : vérifiez-les dans la documentation officielle de votre environnement.