
Vous demandez à votre agent de code « qui appelle cette fonction ? » et il relit quarante fichiers pour répondre, en brûlant des jetons à chaque question. C’est le point de départ de codebase-memory-mcp : un projet qui garde en mémoire une carte du code plutôt que de laisser l’agent la reconstruire à chaque fois. Cet article regarde le codebase-memory-mcp serveur MCP comme un composant qu’on doit autoriser, installer et surveiller. Le dépôt est DeusData/codebase-memory-mcp.
Je pars de trois décisions d’exploitation plutôt que d’un inventaire des fonctions : que donner à l’agent à la place des fichiers bruts, ce qu’on laisse l’installeur écrire sur le poste, et comment vérifier que le gain existe chez vous.
Précision d’honnêteté : span.observer n’a pas installé ni lancé ce projet. Les faits viennent du README, de server.json et des fichiers du dépôt, lus le 11 novembre 2026. Le dernier commit lu date du même jour, et server.json indique la version 0.12.1. Le nombre d’étoiles n’a pas pu être relu à la source : je ne le cite pas. Les captures viennent du dépôt, sous licence MIT.
codebase-memory-mcp serveur MCP : une carte du code, pas une mémoire de conversation
Le mot « mémoire » trompe. Ici, rien ne retient vos échanges avec l’agent : le projet indexe le code, la documentation et les fichiers d’infrastructure dans un graphe de connaissances local. Pour la mémoire de conversation, voyez plutôt https://span.observer/fr/claude-mem-memoire-persistante-agents/ ou https://span.observer/fr/ai-memory-memoire-agents-de-code-rust/. Ici, on parle de structure : fonctions, appels, routes, dépendances.
D’après le README, le projet annonce :
- une licence MIT et un backend natif en C, sans Docker ni environnement de langage à installer ;
- 163 langages et formats pris en charge, avec une résolution de types supplémentaire (« Hybrid LSP ») pour certains ;
- 17 outils MCP, dont
search_graph,trace_path,detect_changesetget_architecture; - un index et des requêtes qui n’exigent ni service hébergé ni clé d’API ;
- 46 intégrations d’agents, automatiques ou conditionnelles, que l’installeur configure.
Le backend ne contient pas de modèle de langage. Selon le README, c’est votre client MCP qui traduit la question en appels d’outils : l’agent appelle par exemple trace_path avec la direction « inbound », le serveur interroge le graphe, et l’agent reformule la réponse.
Première décision : que donner à l’agent à la place des fichiers ?
La réponse du projet tient en une phrase : des requêtes ciblées sur un graphe, avec des résultats paginés et compacts. Un agent qui cherche les appelants d’une fonction n’a pas besoin du contenu de chaque fichier. Il a besoin de la liste des appelants, de leur chemin et, au besoin, d’un extrait de code.
Les outils se répartissent en deux familles. Pour l’indexation : index_repository, list_projects, index_status, check_index_coverage. Pour l’interrogation : recherche structurelle et sémantique, trace des appels, Cypher en lecture seule, extrait de code, plan d’un fichier, et detect_changes, qui relie un diff git aux symboles touchés. Le README conseille de lancer get_graph_schema en premier.
Le point d’exploitation à retenir concerne les grands dépôts. Une indexation synchrone peut dépasser le délai qu’un client accorde à un appel d’outil. Le README recommande alors le mode async: true, puis un sondage avec status: true jusqu’à l’état succeeded, failed ou cancelled.
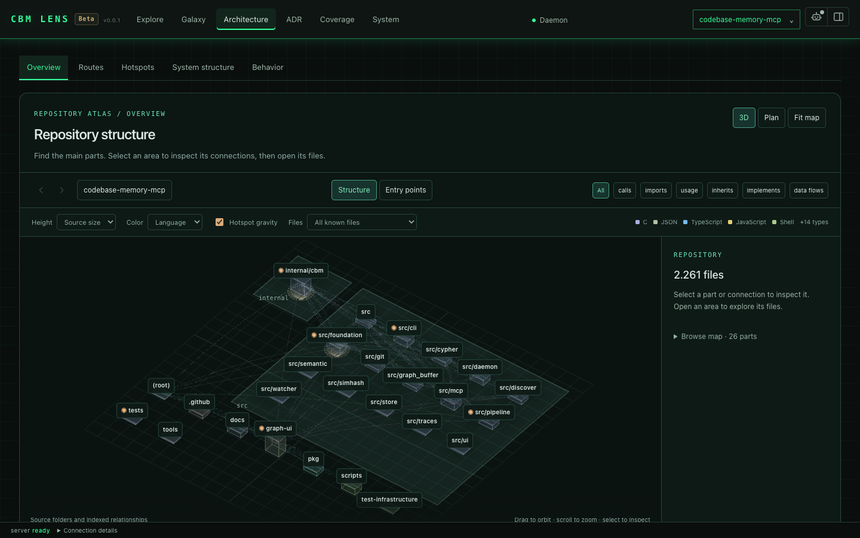
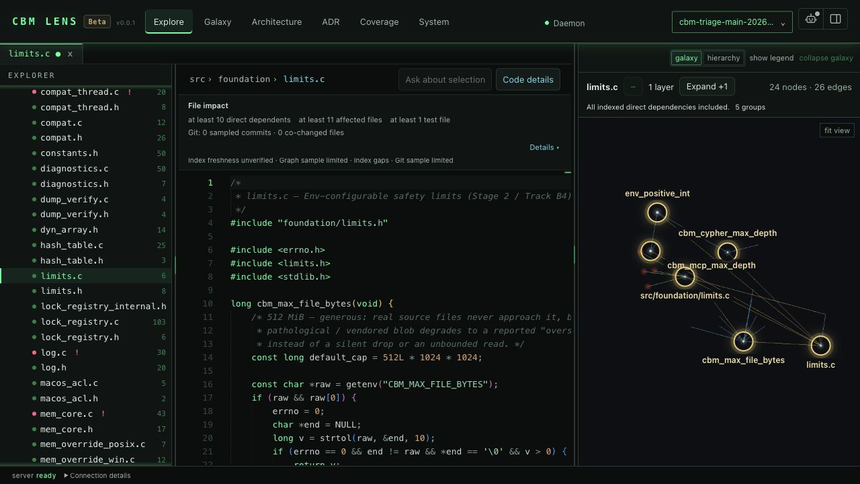
Le projet fournit aussi une interface visuelle en bêta, CBM Lens (version 0.0.1). La première capture montre la vue « Architecture » du dépôt lui-même : les dossiers deviennent des plateformes, les fichiers des blocs. La seconde montre le lecteur de source, avec l’impact d’un fichier et son graphe de dépendances à droite.
Deuxième décision : ce qu’on laisse l’installeur écrire
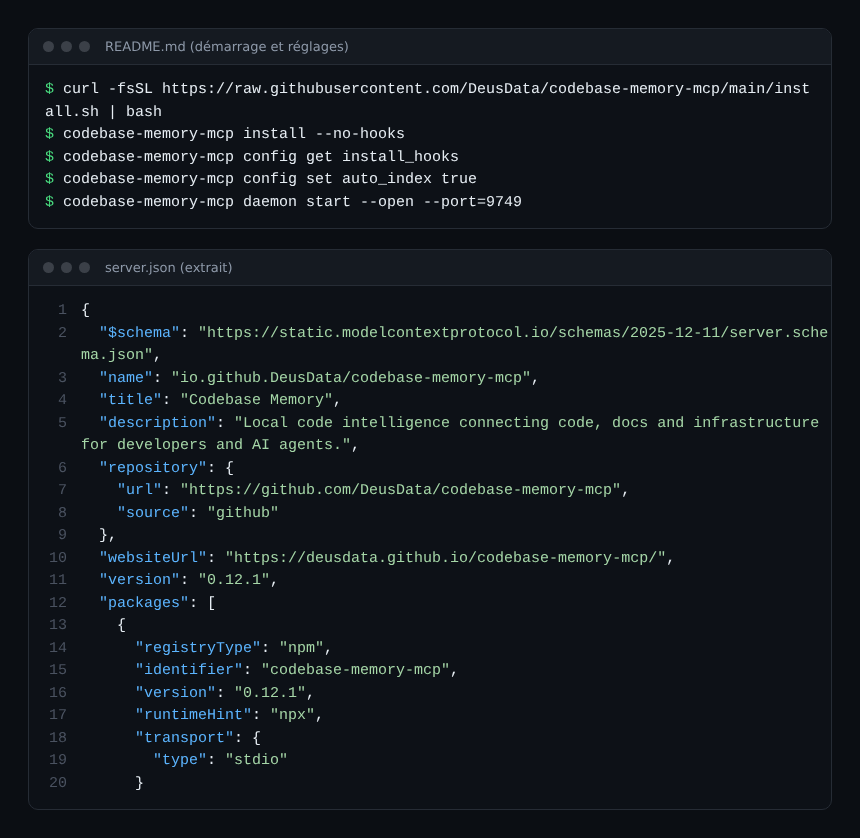
L’installation tient en une ligne, mais cette ligne mérite un temps d’arrêt. Le README propose, sous macOS et Linux, de télécharger install.sh depuis la branche principale et de l’exécuter. Sous Windows, il demande de télécharger install.ps1, de le relire (« optional but recommended »), de le débloquer puis de l’exécuter. Lisez le script avant de l’exécuter, y compris sous Linux : c’est le même réflexe que pour tout installeur qui écrit dans vos fichiers de configuration.
Car la commande install ne se contente pas de poser un binaire. Elle détecte vos clients et y ajoute la configuration MCP, des instructions, des « skills », des profils d’agent nommés Scout, Verify et Auditor, et des hooks. D’après le README, ces hooks ajoutent du contexte sans remplacer ni bloquer l’outil appelé (« context-only and fail-open »). Ils sont actifs par défaut : l’option install --no-hooks les retire, et config get install_hooks affiche le choix.
Autres réglages à décider avant de généraliser :
auto_indexest désactivé par défaut. Activé, il indexe chaque nouveau projet à la première connexion, dans la limite deauto_index_limit.auto_watchest actif par défaut : un projet indexé est resurveillé tant qu’une session le possède. Sousdaemon start, la surveillance continue après la fin de la session.- Les index vivent dans
~/.cache/codebase-memory-mcp/, en bases SQLite. Un index contient la structure de votre code : traitez ce dossier comme le code lui-même. CBM_CACHE_DIRdéplace ce dossier ;CBM_WORKERSetCBM_MEM_BUDGET_MBbornent le parallélisme et la mémoire, utile dans un conteneur.
Pour la sécurité de la chaîne de livraison, le README décrit des binaires scannés par VirusTotal, une provenance SLSA niveau 3, des signatures Sigstore cosign et des sommes SHA-256 vérifiées par les scripts d’installation. Il note aussi que Microsoft Defender peut signaler un faux positif. Ce sont des affirmations du projet : la commande gh attestation verify donnée dans le README permet de vérifier la provenance vous-même. Pour cadrer ce qu’un serveur MCP peut faire sur un poste, lisez https://span.observer/fr/securiser-serveur-mcp/ et https://span.observer/fr/auditer-serveurs-mcp-entreprise/.
Troisième décision : prouver le gain chez vous
Le README cite une étude du projet (un preprint sur arXiv, 31 dépôts) qui rapporte dix fois moins de jetons et 2,1 fois moins d’appels d’outils qu’une exploration fichier par fichier. Il cite aussi des temps d’indexation sur un Apple M3 Pro : le noyau Linux (28 millions de lignes) en 3 minutes, Django en environ 6 secondes. Tous ces chiffres viennent du projet. Je ne les ai pas reproduits, et ils ne disent rien de votre dépôt ni de votre agent.
Le projet le reconnaît dans docs/MEASURING_SAVINGS.md. Ce guide sépare trois questions : l’agent répond-il mieux, le serveur est-il rapide et stable, consomme-t-on moins de jetons ou d’appels. Une requête rapide ne prouve pas une réponse juste, et les compteurs du serveur ne voient pas les jetons du modèle. Le guide demande de figer l’expérience avant de commencer : le commit exact, le jeu de questions et la portée attendue des réponses.
Reprenez cette méthode telle quelle. Posez les mêmes dix questions à votre agent avec et sans le serveur, notez la justesse, le nombre d’appels et les jetons. Pour suivre ces mesures dans la durée, https://span.observer/fr/metriques-outils-mcp/ détaille les métriques d’outils MCP.
Observer un serveur MCP local
Ce serveur tourne sur le poste, pas dans votre production : il n’y a donc pas de service à superviser comme un service web. Trois points restent utiles. Sur stdio, la sortie standard est réservée au JSON-RPC du protocole, et les messages d’un client vont sur son flux d’erreur. Le démon écrit ses événements dans ${CBM_CACHE_DIR}/logs/cbm-daemon.log, et CBM_LOG_LEVEL règle le niveau (debug à error, ou none). Enfin, CBM_DIAGNOSTICS active un instantané périodique, à réserver au diagnostic.
Si vous exploitez une flotte d’agents, rattachez ces appels à vos traces : https://span.observer/fr/observer-agents-mcp-opentelemetry/ montre comment instrumenter les appels d’outils avec OpenTelemetry. Le README ne décrit pas d’export OpenTelemetry pour ce serveur : n’en supposez pas.
Limites à connaître
- Je n’ai ni installé ni testé le logiciel : tout est « selon le README ».
- Le nombre d’étoiles et l’adoption réelle n’ont pas pu être relus : je ne présente pas le projet comme une référence établie.
- CBM Lens est en bêta (0.0.1). Le README précise que le serveur MCP est le cœur du projet.
- Les chiffres de jetons et de temps sont ceux du projet, sur ses propres charges.
- Un résultat « propre » de
check_index_coveragesignifie seulement « aucun trou enregistré », pas « complet », dit le README. - Le mode asynchrone exige le serveur adossé au démon ; une commande CLI isolée avec
--asyncest refusée.
Bonnes pratiques
- Lisez le script d’installation, puis testez sur un dépôt sans secret.
- Gardez
auto_indexdésactivé tant que vous n’avez pas choisi les dépôts concernés. - Gardez les hooks seulement si vous avez relu ce qu’ils ajoutent au contexte de l’agent.
- Mesurez avec et sans le serveur, sur vos questions et votre commit figé.
- Traitez le dossier d’index comme du code source : droits, sauvegardes, suppression à la sortie d’un projet.
Questions fréquentes
codebase-memory-mcp envoie-t-il mon code dans le cloud ?
Selon le README, l’analyse du code et le stockage du graphe tournent sur votre machine, sans service hébergé ni clé d’API. Le chat local de CBM Lens peut en option télécharger un modèle, dont l’inférence reste dans le navigateur. Votre client MCP et son modèle, eux, voient les réponses du serveur.
Quelle différence avec un outil de mémoire comme claude-mem ?
Un outil de mémoire retient ce que l’agent a fait ou appris. Ce serveur décrit la structure du code : appels, dépendances, routes, infrastructure. Les deux se complètent, et ils ne se remplacent pas.
Quelle licence et quelle version ?
Le dépôt est sous licence MIT. Le fichier server.json indique la version 0.12.1 le jour de la lecture, et le projet est aussi publié sous forme de paquets npm et PyPI selon ce fichier.
Conclusion
codebase-memory-mcp pose une bonne question : pourquoi faire relire le code à chaque question alors qu’une carte locale existe ? Avant de l’adopter, relisez l’installeur, choisissez vos réglages d’indexation, puis mesurez le gain sur vos propres dépôts. Pour un autre projet du registre « Top repos », voir /?s=opensre+agent+sre+open+source.
Ce blog est indépendant et non affilié à Dynatrace LLC. codebase-memory-mcp est un projet tiers, non édité par Dynatrace.