
Un agent IA doit-il avoir le droit de lire vos logs de production et de pousser un correctif ? La question se pose dès qu’on regarde OpenSRE agent SRE : le dépôt Tracer-Cloud/opensre, sous licence Apache 2.0, affichait environ 12 800 étoiles le 11 novembre 2026, et son dernier commit date du même jour. Le projet est donc très actif, mais il se déclare lui-même en « public alpha ».
Cet article part de la décision d’exploitation plutôt que de la liste des fonctions : que faut-il accorder à l’agent, que doit-il lire, et comment surveiller l’agent à son tour ? Les faits viennent du README, du fichier LICENSE et de la documentation du dépôt, lus le 11 novembre 2026.
Précision d’honnêteté : span.observer n’a pas installé OpenSRE. Les captures ci-dessous viennent du dépôt du projet (Apache 2.0). Pour la vue d’ensemble de ce que promettent les agents SRE, voir notre analyse des promesses AIOps ; pour l’annonce côté Dynatrace, l’article sur les agents SRE autonomes.
OpenSRE agent SRE : ce que le dépôt affirme
- Positionnement : le titre du README parle d’un « agent open source pour la fiabilité CI/CD ». Il lit une exécution en échec, remonte à la cause et pousse un correctif que l’on relit. Le même README décrit aussi des alertes et des questions en langage naturel sur la production.
- Licence : Apache 2.0 (fichier LICENSE du dépôt).
- Maturité : un bandeau annonce « Public Alpha », avec des « workflows utilisables pour l’exploration, pas encore totalement stables ». Aucune release n’était affichée à la date de lecture.
- Modèles : auto-hébergé, avec vos propres modèles (Anthropic, OpenAI, Ollama, Gemini, OpenRouter, Bedrock et d’autres dans la liste du README). Un compte OpenSRE et un modèle hébergé sont aussi proposés au premier lancement.
- Intégrations : « plus de 60 outils », dont Grafana, Datadog, CloudWatch, Sentry, Splunk, Kubernetes, PagerDuty, Slack et le protocole MCP.
Je n’ai trouvé aucune mention de Dynatrace dans le dépôt. Un branchement passerait peut-être par MCP, mais je ne l’ai pas vérifié : ne le présumez pas.
La décision d’exploitation : quel périmètre accorder ?
Avant d’installer quoi que ce soit, trois choix déterminent le risque.
- Où tourne le modèle. Les logs de production partent vers un fournisseur externe, ou restent chez vous avec Ollama. Le README mentionne un masquage optionnel des identifiants sensibles avant les appels au modèle : activez-le, puis vérifiez-le sur un jeu de logs fictif.
- Ce qu’il lit. Un jeton en lecture seule par source. La documentation Grafana demande un jeton de compte de service « avec accès en lecture ».
- Ce qu’il écrit. Pousser sur la branche d’une pull request est une action relue par un humain. Exécuter des actions de remédiation est « optionnel » selon le README : laissez-le désactivé au départ.
C’est le même raisonnement que pour un agent de garde branché sur Dynatrace : le périmètre se négocie avant la première démonstration, pas après un incident.
Visite rapide et installation
Le README donne l’installation en une ligne, sans sudo, qui récupère la dernière build de la branche main. Sur macOS ou Linux :
curl -fsSL https://install.opensre.com | bash -s -- -gh
opensre
Sous Windows, le README fournit un équivalent PowerShell. Piper un script distant dans bash exige de la prudence : lisez install.sh dans le dépôt avant de l’exécuter, et testez sur une machine jetable.
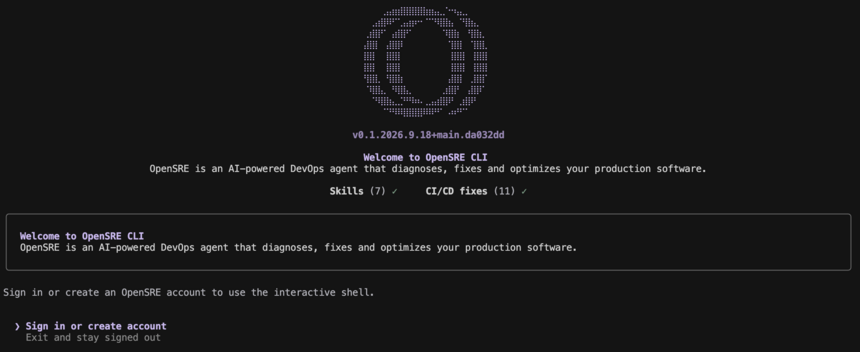
La capture montre l’écran d’accueil : à la première exécution, le shell interactif demande de se connecter ou de créer un compte, ou de rester déconnecté. Le README précise que le shell ne s’ouvre que pour un compte actif.
Brancher une source d’observabilité
Les intégrations se configurent avec opensre integrations setup. Pour Grafana, la documentation propose quatre voies : l’assistant interactif, des variables d’environnement, un magasin persistant ou, plus tard, l’application web hébergée, annoncée « coming soon ».
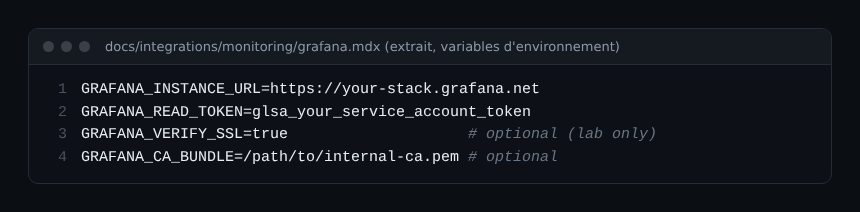
Deux détails comptent pour la sécurité. D’abord, GRAFANA_VERIFY_SSL=false est réservé aux labos ; pour une instance interne, la documentation recommande de fournir un bundle d’autorité de certification. Ensuite, le jeton reste un jeton d’exemple dans la capture : mettez le vôtre dans un gestionnaire de secrets, jamais dans un dépôt.
Interroger l’agent depuis un script
La commande opensre ask exécute un seul tour d’agent, affiche la réponse et se termine. Chaque exécution est enregistrée comme session reprenable, sauf avec --ephemeral.
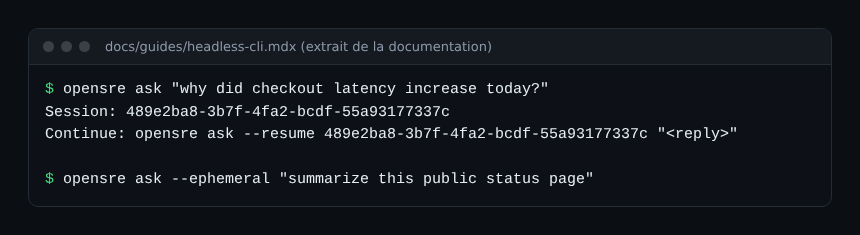
Si l’agent a besoin d’une décision, il sort avec le statut needs_input et propose des options numérotées. Pour un script ou une tâche CI, c’est un point d’arrêt utile : l’humain reste dans la boucle. Les sorties JSON et les entrées par stdin sont décrites dans la page « Headless CLI ».
Surveiller l’agent lui-même
Un agent qui lit votre production devient un composant de production. Quatre points se mesurent ou se règlent, d’après la documentation :
- Télémétrie du projet : l’analytique produit et les rapports d’erreurs Sentry sont activés par défaut (opt-out).
export OPENSRE_NO_TELEMETRY=1les désactive. - Journal des prompts :
OPENSRE_PROMPT_LOG_DISABLED=1le coupe, y compris pour les requêtes éphémères. - Coût et sessions : le shell propose les commandes
/costet/sessions. Je n’ai pas vérifié ce qu’elles affichent. - Échecs silencieux : une réponse sûre d’elle mais fausse ne déclenche aucune alerte. Détecter les échecs silencieux des agents détaille quoi mesurer.
Le dépôt contient aussi un pilote de triage sur le service de paiement de la démo OpenTelemetry : OpenSRE y lit les métriques, traces et logs stockés dans ClickHouse, et non le Collector. La distinction est utile : l’agent consulte un historique, il ne remplace ni la collecte ni le stockage.
Limites et points ouverts
- Alpha : API et intégrations peuvent changer, dit le README.
- Cible principale : le positionnement actuel est la fiabilité CI/CD ; l’investigation d’incidents de production y figure, mais je n’ai pas mesuré sa qualité.
- Aucune performance chiffrée citée : le projet évoque des tests de bout en bout dans
tests/e2e, pas de comparaison reproductible que je puisse rapporter. - Données : sans masquage, vos logs voyagent vers le modèle choisi.
- Dépôt actif, donc mouvant : le README signale d’ailleurs la suppression d’anciennes couches « graph et chain ». Une doc lue aujourd’hui peut vieillir vite.
Bonnes pratiques
- Commencez en lecture seule, sur un environnement de test et une seule source.
- Gardez la remédiation automatique désactivée tant que vous n’avez pas relu dix investigations.
- Comparez chaque conclusion de l’agent avec vos propres tableaux de bord, comme pour tout projet open source jeune : le dépôt n’est pas une garantie.
- Définissez qui reçoit les résumés Slack ou PagerDuty et qui répond.
Questions fréquentes
OpenSRE est-il gratuit et open source ?
Le code est sous licence Apache 2.0. Les modèles que vous appelez (API payantes) et l’éventuel modèle hébergé du compte OpenSRE ont leurs propres conditions, que je n’ai pas relues.
Peut-il remplacer une astreinte humaine ?
Rien dans le README ne le prétend : l’agent propose une réponse étayée de preuves et un correctif à relire. La décision reste humaine, et le statut alpha invite à la prudence.
Fonctionne-t-il avec Dynatrace ?
Dynatrace ne figure pas dans la liste d’intégrations du README. Le support de MCP laisse une porte ouverte, non vérifiée ici. Pour comparer, voyez l’annonce des agents SRE de Dynatrace.
Conclusion
OpenSRE vaut un essai encadré si vous voulez un agent auto-hébergé, branché sur des outils d’observabilité que vous exploitez déjà. Posez d’abord le périmètre, lecture seule et modèle choisi, puis mesurez l’agent comme un service. Dépôt et documentation : Tracer-Cloud/opensre.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni à Tracer. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans la documentation officielle.