Headroom, compression de contexte LLM pour agents de code : le projet se présente comme une couche qui compresse tout ce que lit un agent (sorties d’outils, journaux, extraits RAG, fichiers, historique) avant que cela n’atteigne le modèle. Le dépôt headroomlabs-ai/headroom affiche environ 77 500 étoiles à la fin octobre 2026, sous licence Apache-2.0.
Moins de tokens en entrée, c’est moins de coût et moins de compactions, mais seulement si la compression ne détruit pas l’information utile. Cet article résume ce que fait le projet d’après son README, montre son tableau de bord, détaille l’installation, puis explique comment mesurer vous-même les économies avec ses métriques Prometheus et OpenTelemetry. Précision d’honnêteté : span.observer n’a pas installé Headroom ; les commandes viennent du README et de la documentation du projet, et les captures viennent du dépôt.
Headroom : compression de contexte LLM, ce que dit le dépôt
- Qui : l’organisation
headroomlabs-ai; la documentation est hébergée sur docs.headroomlabs.ai. - Licence : Apache-2.0 (fichier LICENSE du dépôt).
- Chiffres relus le 22 octobre 2026 : environ 77 500 étoiles, environ 6 000 forks, 3 324 commits ; le
pyproject.tomlde la branche principale indique la version 0.41.0 du paquetheadroom-ai, qui demande Python 3.10 ou plus récent. - Quatre usages d’après le README : une bibliothèque (
compress(messages)en Python ou TypeScript), un proxy (headroom proxy --port 8787), l’enveloppe d’agent (headroom wrap claude,codex,cursor,aider,opencode…) et un serveur MCP.
Le mécanisme décrit : un routeur de contenu détecte le type de données et choisit un compresseur (JSON, code par arbre syntaxique, texte avec un modèle publié sur Hugging Face). Les originaux sont gardés en local (« CCR ») et le modèle peut les redemander via l’outil headroom_retrieve. Le projet affirme que la compression se fait sur votre machine, sans envoyer le contenu ailleurs pour le compresser. Cette idée est voisine de celle de context-mode, qui garde la sortie brute hors du contexte avec une autre mécanique et une autre licence.
Visite du tableau de bord
La commande headroom dashboard ouvre, proxy lancé, un tableau de bord. La capture ci-dessous vient du dépôt : elle montre l’état de santé, les requêtes terminées, échouées ou limitées, les tokens économisés, le coût, la surcharge ajoutée par le proxy (en millisecondes), l’usage par type de contenu supprimé (« JSON Bloat », « Repetition ») et l’impact sur le cache de préfixe du fournisseur.
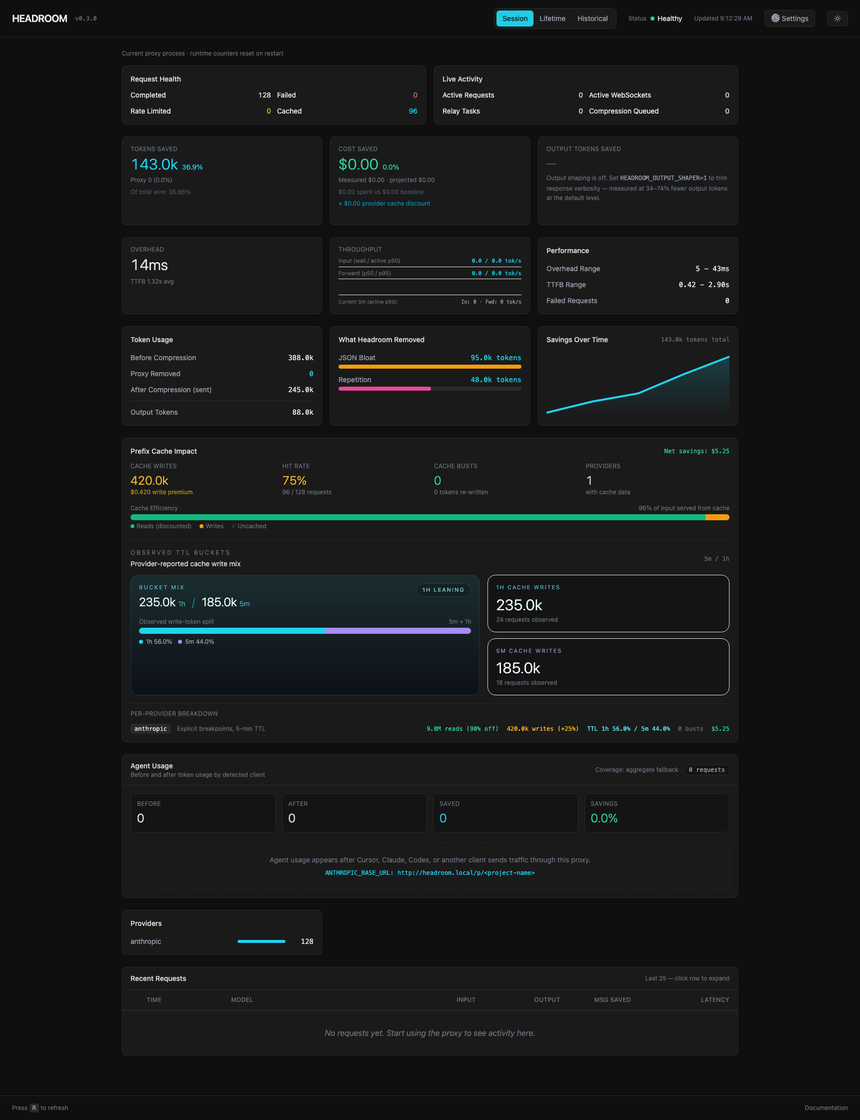
Ce sont des valeurs d’exemple du projet, pas des mesures de span.observer. Le tableau de bord prévoit aussi une sortie de tokens économisés estimée lorsque la mise en forme de la sortie est activée (HEADROOM_OUTPUT_SHAPER=1, désactivée par défaut).
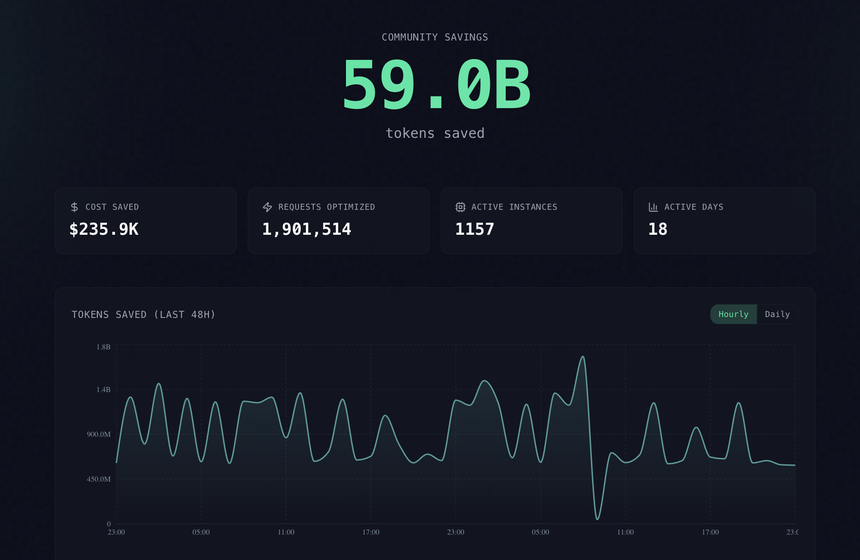
La deuxième image du dépôt montre un compteur « Community savings » agrégé. Le README ne détaille pas, dans le passage consulté, comment ce chiffre est collecté : prenez-le comme une donnée du projet, non vérifiée, et lisez la section Limites sur la balise de télémétrie.
Installation pas à pas
Étape 1 — Installer la CLI
Le README donne, au choix :
uv tool install --python 3.13 "headroom-ai[all]"
pip install "headroom-ai[all]"
npm install headroom-ai     # SDK TypeScript seulement, sans CLI
Une image Docker est aussi indiquée (ghcr.io/headroomlabs-ai/headroom:latest). Pour limiter la surface, le README liste des extras granulaires ([proxy], [mcp], [ml], [otel]…).
Étape 2 — Choisir un mode
headroom wrap claude          # enveloppe un agent de code
headroom proxy --port 8787    # proxy sans changer le code
headroom mcp install          # serveur MCP (headroom_compress, headroom_retrieve, headroom_stats)
Le README précise que headroom wrap démarre un proxy local, installe le serveur Serena pour la navigation de code et lance l’agent configuré pour passer par Headroom ; headroom unwrap annule. Lisez cette partie avant de l’utiliser : elle modifie la configuration de votre agent.
Étape 3 — Vérifier
headroom doctor      # contrôle de santé
headroom perf        # performances
headroom dashboard   # économies en direct (proxy lancé)
Limites et points ouverts
- Les chiffres sont ceux du projet : le README publie un tableau de quatre scénarios (de 21 % à 57 % d’économie) mesurés avec le tokenizer du fournisseur, reproductibles avec
benchmarks/index_proof_table.py --seed 20260902. Il précise lui-même que les gains dépendent de la répétitivité des données et que la prose ou les sorties déjà denses se compressent très peu. - Précision : les tests d’exactitude du README montrent, à N=100, un delta de ±0,03 qu’il juge dans l’intervalle de confiance. Rien ne remplace un essai sur vos tâches.
- Balise de télémétrie : la page « Limitations » de la documentation explique que
HEADROOM_BEACONest activée par défaut (désactivable) et envoie un résumé anonyme (compteurs, ratios, identifiants de fournisseur et de modèle, système et architecture), jamais les prompts ni le code. Elle se coupe avecHEADROOM_BEACON=off,HEADROOM_TELEMETRY=offouDO_NOT_TRACK=1. Documentez ce point dans votre revue de sécurité. - Un proxy sur le chemin des requêtes : il voit vos clés de fournisseur et vos prompts. Gardez-le en boucle locale et traitez-le comme un composant critique, comme un serveur MCP (voir sécuriser un serveur MCP).
Comment mesurer les économies et superviser le proxy
Headroom expose plusieurs sources, d’après sa page « Metrics & Monitoring » : le point d’accès /stats (JSON), l’historique /stats-history (avec export CSV), les métriques Prometheus sur /metrics (par exemple headroom_tokens_saved_total, headroom_requests_failed_total) et un export OpenTelemetry. La documentation avertit que headroom_requests_total ne compte que les requêtes terminées, et qu’il n’existe pas de buckets d’histogramme : on calcule des moyennes avec les paires _sum et _count.
Pour l’export OTLP, installez l’extra [proxy,otel] puis positionnez ces variables, tirées de la documentation :
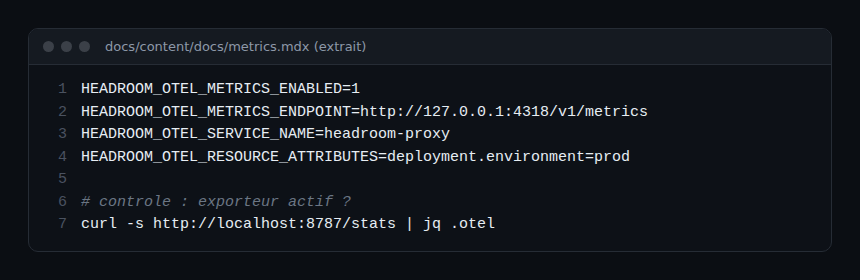
La documentation cite les compteurs headroom.proxy.requests, headroom.proxy.tokens.input, headroom.proxy.tokens.output et headroom.proxy.tokens.saved, et précise que l’endpoint doit être l’URL complète, sans ajout automatique de /v1/metrics. Pour Dynatrace SaaS, la page de Headroom indique un jeton avec le scope metrics.ingest et la variable OTEL_EXPORTER_OTLP_METRICS_TEMPORALITY_PREFERENCE=DELTA : la documentation OpenTelemetry de Dynatrace confirme que le backend n’ingère que des valeurs en temporalité delta. Le pas-à-pas OTLP est dans superviser un agent de code en entreprise. Sur Dynatrace Managed, vérifiez d’abord que l’ingestion OTLP est disponible sur votre version.
Pour un chiffre indépendant, comparez les tokens facturés côté agent avec et sans Headroom, comme dans le coût d’un agent IA en tokens avec OpenTelemetry, en additionnant tous les types de tokens, cache compris.
Comment vérifier que ça fonctionne
headroom doctorconfirme que le routage fonctionne.curl http://localhost:8787/healthrépond (commande de la page de dépannage de la documentation).curl -s http://localhost:8787/stats | jq .otelconfirme que l’exporteur OTLP est actif.
Bonnes pratiques
- Essayez sur une tâche de référence riche en sorties volumineuses, trois à cinq fois avec et sans proxy.
- Vérifiez la qualité des réponses, pas seulement les tokens : une compression trop agressive peut masquer une ligne utile.
- Fixez la version et relisez les variables de télémétrie à chaque mise à jour.
- Conservez l’accès local au proxy ; n’exposez pas son port.
Questions fréquentes
Headroom est-il open source ?
Oui, le dépôt est sous licence Apache-2.0. Vérifiez cependant les extras et modèles que vous installez, chacun ayant sa propre licence.
Headroom envoie-t-il mes prompts quelque part ?
D’après le README, la compression s’exécute localement. Le proxy transmet bien sûr la requête compressée à votre fournisseur de LLM, et la balise de télémétrie anonyme, active par défaut, est décrite dans la page « Limitations ».
Quelle économie attendre ?
Le projet publie de 21 % à 57 % sur quatre scénarios et prévient que les contenus répétitifs gagnent le plus. Mesurez sur vos propres charges de travail.
Conclusion
Headroom applique la compression de contexte LLM au plus près du proxy et fournit de quoi la mesurer, avec Prometheus et OpenTelemetry. Ses chiffres sont ceux de ses auteurs : à vous de les confirmer sur vos tâches. Sources : dépôt headroomlabs-ai/headroom et documentation de Headroom.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni aux projets cités. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans leur documentation officielle.