Cette nuit, votre load balancer tombe. Aucun client n’est connecté, donc vos métriques d’erreurs restent plates et aucune alerte ne part. Ce scénario est le point de départ de Gatus, et il explique pourquoi une Gatus page de statut a sa place à côté de vos tableaux de bord : le projet interroge vos services lui-même, au lieu d’attendre que du trafic réel révèle la panne. Le dépôt TwiN/gatus le décrit comme un tableau de bord de santé « orienté développeurs ».
Je pars donc de trois décisions d’exploitation, pas d’un inventaire de fonctions : qu’appelle-t-on un service sain, combien d’échecs avant de réveiller quelqu’un, et où garde-t-on l’historique. Tout se règle dans un seul fichier YAML.
Précision d’honnêteté : span.observer n’a pas installé ni lancé Gatus. Les faits viennent du README et de l’arborescence du dépôt, lus le 10 novembre 2026. Les images sont celles du dépôt (licence Apache 2.0) ou un rendu de son exemple de configuration. Le nombre d’étoiles n’a pas pu être relu à la source ce jour-là : je ne le cite pas.
Gatus page de statut : ce que dit le dépôt
- Licence : le fichier LICENSE est celui de l’Apache License 2.0.
- Langage : Go ; le fichier
go.moddemande Go 1.26.3. - Version : la plus récente étiquette Git lue après clonage est
v5.38.0. Le dernier commit de la branche principale date du 9 novembre 2026. - Sondes : requêtes HTTP, ICMP, TCP et DNS, d’après le README ; une section de la FAQ couvre aussi SSH, TLS, gRPC et WebSocket.
L’argument central du README est simple. Une métrique de trafic se tait quand le trafic disparaît, alors qu’une sonde active continue de poser la question. Les deux approches se complètent : la sonde dit « ça répond », la télémétrie dit « comment ça se comporte ».
Première décision : qu’est-ce qu’un service sain ?
Un code 200 ne prouve presque rien. Gatus l’admet : chaque endpoint porte une liste de conditions, et une seule condition fausse suffit à le déclarer malade. Voici l’exemple de départ du README :
endpoints:
  - name: website
    url: "https://twin.sh/health"
    interval: 5m
    conditions:
      - "[STATUS] == 200"
      - "[BODY].status == UP"
      - "[RESPONSE_TIME] < 300"
Trois conditions, trois questions différentes : le serveur répond-il, dit-il qu’il va bien, et répond-il assez vite ? Le tableau de conditions du README en liste d’autres, comme [CERTIFICATE_EXPIRATION] > 48h, [CONNECTED] == true, len([BODY].data) < 5 ou [BODY].name == pat(john*). Mon conseil : écrivez la condition que votre utilisateur ressentirait, pas celle qui est facile à vérifier. Un contrôle de certificat à 48 heures évite une panne bête un dimanche.
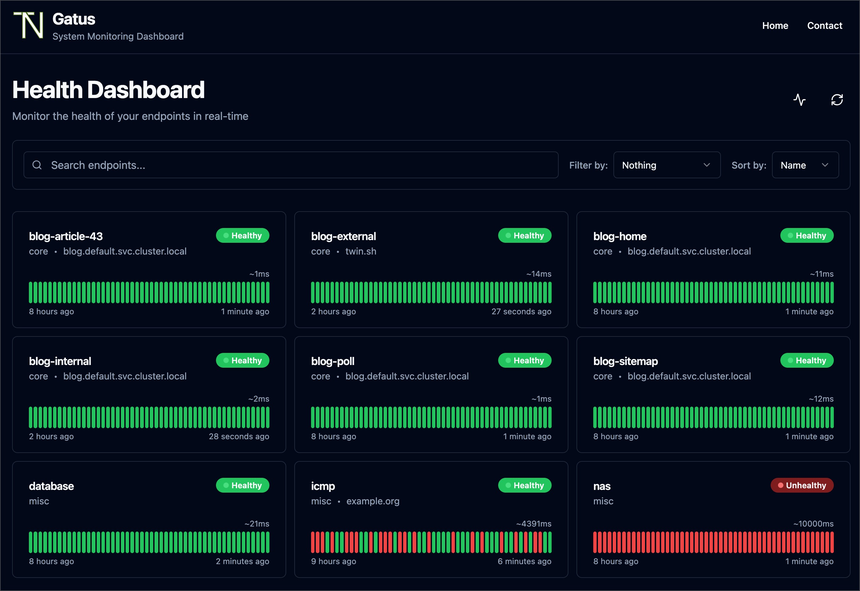
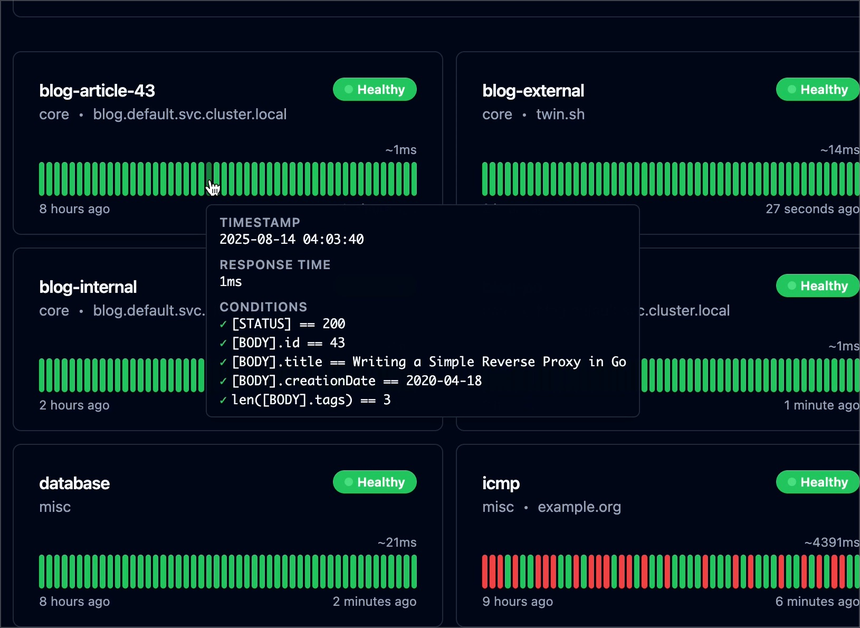
La carte de l’endpoint conserve les conditions évaluées à chaque passage. En survolant une barre de l’historique, le tableau de bord affiche l’horodatage, le temps de réponse et chaque condition cochée.
Deuxième décision : combien d’échecs avant l’alerte ?
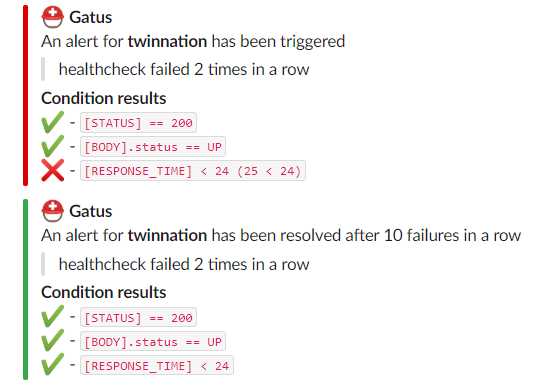
Une alerte au premier échec réveille toute l’équipe pour un paquet perdu. Le README fixe donc des valeurs par défaut prudentes pour chaque alerte :
failure-threshold: 3 échecs consécutifs avant de déclencher ;success-threshold: 2 succès consécutifs avant de clore l’incident ;send-on-resolved: faux par défaut, donc pas de message de fin sans le demander ;minimum-reminder-interval: désactivé par défaut, et jamais inférieur à 5 minutes.
Ces réglages traduisent une politique de bruit. Plus le seuil monte, moins vous êtes dérangé, mais plus l’utilisateur subit la panne avant vous. Le README illustre le compromis avec deux alertes sur le même endpoint : l’une au troisième échec, l’autre au cinquième, pour une escalade en deux temps. Le fournisseur se déclare une fois, au niveau global, puis chaque endpoint y fait référence :
alerting:
  slack:
    webhook-url: "https://hooks.slack.com/services/**********/**********/**********"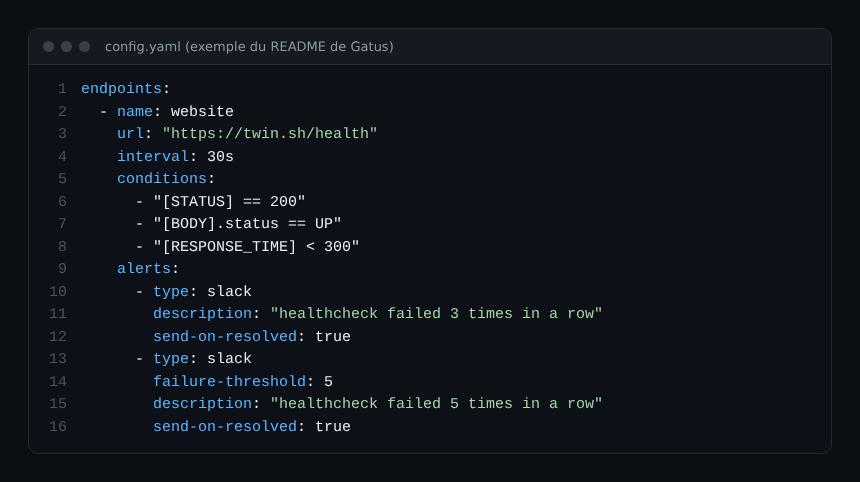
Le dépôt prend en charge de nombreux fournisseurs (Slack, Teams, PagerDuty, Discord, Telegram, ntfy, Opsgenie, e-mail et d’autres, d’après l’arborescence du dossier alerting/provider). Attention : certains portent dans le README un avertissement « pas encore testé », par exemple Squadcast. Vérifiez le vôtre avant de lui confier vos astreintes. Pour une méthode de tri des signaux, voir /?s=alerter+sur+les+symptomes+pas+causes ; pour la même logique de seuils côté Dynatrace, https://span.observer/fr/reduire-bruit-alertes-davis/.
Troisième décision : où garder l’historique ?
Par défaut, le stockage est en mémoire : un redémarrage efface l’historique et l’uptime affichés. Le README propose sqlite (avec un chemin de fichier) ou postgres (avec une URL de connexion).
storage:
  type: sqlite
  path: data.db
Deux autres leviers touchent à l’exploitation. Les fenêtres de maintenance (maintenance.start, duration, timezone, every) évitent les alertes pendant un déploiement planifié. Les « external endpoints » inversent le sens : un agent poussé depuis un réseau privé envoie son état à Gatus avec un jeton, et un heartbeat.interval crée un échec si aucun message n’arrive à temps. C’est la réponse du projet au cas où Gatus ne peut pas atteindre le service.
Mise en route et vérification
Le README donne une commande Docker ; la version avec fichier monte votre configuration dans /config/config.yaml :
docker run -p 8080:8080 --name gatus ghcr.io/twin/gatus:stable
docker run -p 8080:8080 --mount type=bind,source="$(pwd)"/config.yaml,target=/config/config.yaml --name gatus ghcr.io/twin/gatus:stable- Écrivez un
config.yamlavec un seul endpoint et ses conditions. - Lancez la seconde commande et ouvrez
http://localhost:8080: la carte doit apparaître. - Cassez volontairement une condition (par exemple
[STATUS] == 201) : la carte doit passer en « Unhealthy ». - Attendez trois échecs : l’alerte doit partir. Rétablissez la condition : elle doit se résoudre après deux succès si
send-on-resolvedest actif.
Gatus recharge le fichier à chaud. Si la nouvelle version est invalide, il quitte, sauf si skip-invalid-config-update vaut true. Le README déconseille ce réglage, et signale que la détection peut échouer si l’on monte le fichier au lieu du dossier. Surveillez le journal après chaque modification.
Limites à connaître
- Les « suites » portent la mention ALPHA, et les instances distantes (« remote ») sont qualifiées d’expérimentales, avec risque de changement incompatible.
- L’exécution est limitée par
concurrency(3 par défaut) : de nombreux endpoints lents, avec un délai maximal par défaut de 10 s, peuvent retarder les autres. L’intervalle ne compte pas la durée de la requête elle-même. - Gatus dit si un service répond. Il n’explique pas pourquoi : il ne remplace ni les traces ni les logs.
- Je n’ai pas mesuré de performances : aucun chiffre de charge n’est avancé ici.
Relier Gatus à votre observabilité
Avec metrics: true, Gatus expose des métriques au format Prometheus sur /metrics, sur le port de l’application. Le README cite par exemple gatus_results_total, gatus_results_duration_seconds, gatus_results_certificate_expiration_seconds et gatus_results_endpoint_success (0 en échec, 1 en succès). Vous pouvez donc alerter sur la durée d’un certificat avec votre moteur habituel, voir https://span.observer/fr/alerting-rules-prometheus-promtool-ci/. Leur collecte par un autre outil (Collector OpenTelemetry, Dynatrace) n’est pas vérifiée ici. Pour un autre projet du même registre, voir https://span.observer/fr/argo-cd-gitops-kubernetes/.
Bonnes pratiques
- Sondez le chemin utilisateur (connexion, API clé), pas seulement une page d’accueil.
- Gardez
failure-thresholdà 3 au départ, puis ajustez avec l’historique des fausses alertes. - Passez en
sqliteoupostgresdès que l’historique compte. - Ne mettez jamais le jeton d’un webhook dans un dépôt public : le README prévoit l’usage de variables d’environnement dans le fichier.
- Placez Gatus hors de l’infrastructure qu’il surveille, sinon il tombe avec elle.
Questions fréquentes
Gatus remplace-t-il Prometheus ou Dynatrace ?
Non. Gatus répond à « le service répond-il comme promis ? ». Les métriques, traces et logs expliquent les causes. Les deux approches se complètent.
Quelle est la licence de Gatus ?
Le dépôt contient le texte de l’Apache License 2.0. Relisez le fichier LICENSE avant toute redistribution.
Comment éviter une alerte pendant une maintenance ?
Définissez maintenance globalement, ou maintenance-windows sur un endpoint, avec une heure de début, une durée et un fuseau horaire.
Conclusion
Gatus tient en un fichier YAML et une question utile : saurais-je que ça casse avant mes clients ? Les trois décisions (conditions, seuils, stockage) font l’essentiel du travail. Gardez la sonde active en complément de votre télémétrie, et testez-la en la cassant exprès.
Ce blog est indépendant et non affilié à Dynatrace LLC. Gatus est un projet tiers, non édité par Dynatrace.