Graphify graphe de connaissances : le dépôt Graphify-Labs/graphify transforme un projet (code, documents, PDF, images, vidéo) en graphe que l’on interroge au lieu de parcourir les fichiers avec grep. On l’appelle par la commande /graphify depuis un assistant de code. Il affichait environ 132 100 étoiles en octobre 2026, avec une double licence Apache-2.0 et MIT.
Pour un ingénieur ou un SRE qui reprend un code inconnu (un service sans documentation, un monorepo, un dépôt d’incident), l’idée est de voir quels composants dépendent de quoi, sans lire cent fichiers. Cet article présente ce que dit le dépôt, l’installation d’après le README, ce que l’outil produit, et les points à surveiller : confidentialité, journal des requêtes, offre commerciale voisine.
Les informations viennent du README et de la documentation du projet. span.observer n’a pas installé Graphify : la capture et la sortie de commande ci-dessous viennent du README du dépôt (exemple du code de FastAPI).
Graphify graphe de connaissances : ce que dit le dépôt
- Qui : Graphify Labs, qui se présente comme titulaire du nom et du logo. Le README affiche un badge Y Combinator S26. Le fichier
LICENSE-MITporte « Copyright (c) 2026 Safi Shamsi ». - Licence : le dépôt contient un fichier
LICENSE(Apache-2.0, repris par le badge du README) et un fichierLICENSE-MIT. Le README ne dit pas quelle partie relève de laquelle : lisez les deux fichiers avant un usage commercial. - Version : le paquet PyPI
graphifyyétait en 0.9.93, publié le 20 octobre 2026. La branche par défaut du dépôt estv8. - Entrées : environ 40 langages de programmation analysés avec tree-sitter ; documents, PDF, images, audio et vidéo via une passe sémantique ; schémas SQL et configurations avec des extras optionnels.
- Sorties : un dossier
graphify-out/avecgraph.html(graphe interactif),GRAPH_REPORT.md(concepts centraux, liens surprenants, questions suggérées) etgraph.json(graphe complet, interrogeable ensuite). - Principe : chaque lien est étiqueté
EXTRACTED(explicite dans la source) ouINFERRED(déduit). Le README précise que ce n’est pas un index vectoriel : pas d’embeddings, un vrai graphe que l’on parcourt.
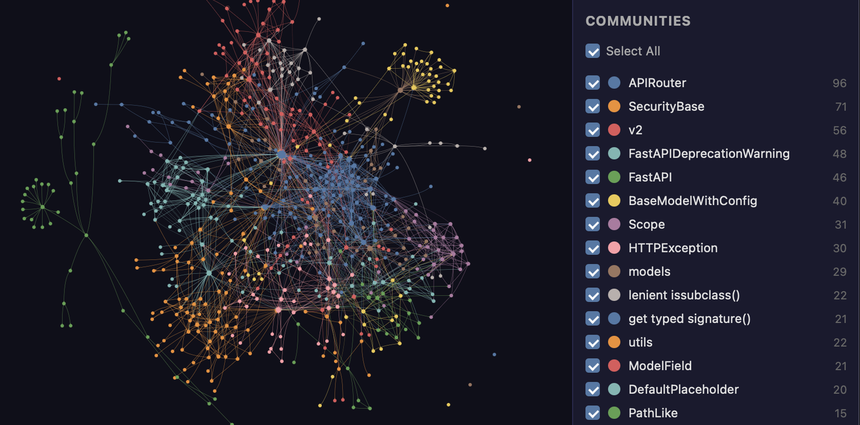
La capture montre le graph.html produit sur le code de FastAPI : chaque couleur est une communauté détectée, c’est-à-dire un sous-système du code.
Installer Graphify d’après le README
Étape 1 — Prérequis
Python 3.10 ou plus récent, et uv (recommandé) ou pipx. Le README fournit des commandes d’installation pour macOS (brew install [email protected] uv), Windows (winget install astral-sh.uv) et Debian ou Ubuntu.
Étape 2 — Installer la commande et l’enregistrer dans votre assistant
uv tool install graphifyy      # ou : pipx install graphifyy
graphify install               # détecte votre assistant et enregistre le skill
Attention au nom : le paquet PyPI officiel s’écrit graphifyy avec deux « y ». Le README prévient que d’autres paquets graphify* ne sont pas affiliés. La commande, elle, reste graphify.
Étape 3 — Construire le graphe
Dans votre assistant de code (Claude Code, Cursor, Gemini CLI, GitHub Copilot et une vingtaine d’autres, selon le README), tapez :
/graphify .Avec Codex, la syntaxe est $graphify. Pour installer le skill dans le dépôt courant plutôt que dans votre profil : graphify install --project. Pour reconstruire automatiquement à chaque commit : graphify hook install.
Interroger le graphe
Une fois le graphe construit, le README décrit trois gestes : graphify query "question", graphify path A B et graphify explain "Nom". Voici la sortie d’exemple publiée par le projet sur le code de FastAPI :
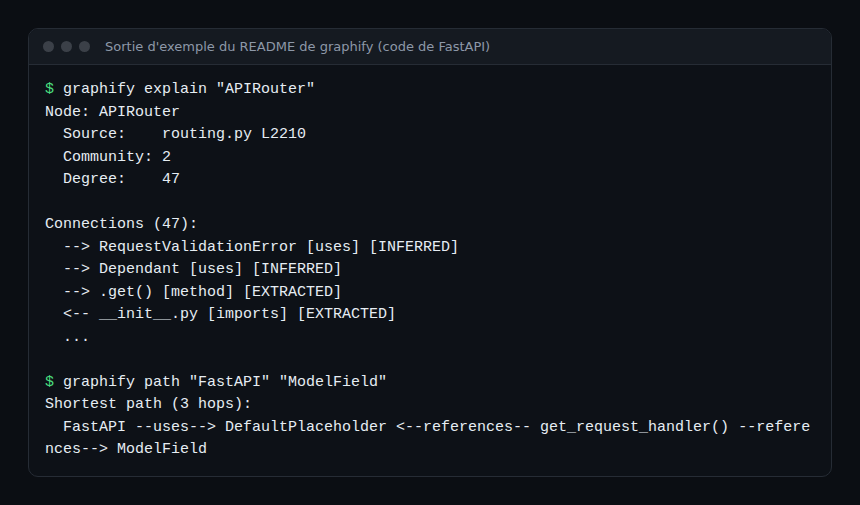
On lit ici l’intérêt pour l’exploitation : la commande explain donne le fichier source, la communauté et le degré d’un composant ; la commande path montre le chemin le plus court entre deux composants. Les étiquettes INFERRED sont des hypothèses : vérifiez-les dans le code avant de conclure.
Confidentialité et observabilité de l’outil
- Code : analysé localement par tree-sitter, sans modèle de langage, selon le README ; un corpus de code seul se construit sans clé d’API.
- Documents, PDF, images : envoyés à votre assistant ou à un fournisseur configuré (variables d’environnement pour Gemini, Claude, OpenAI, Ollama, Bedrock…).
GRAPHIFY_BACKEND=nonedésactive les modèles,GRAPHIFY_BACKEND=ollamagarde tout en local. - Télémétrie : le README affirme qu’il n’y en a aucune.
- Journal des requêtes : activé par défaut, chaque
query,path,explainet appel MCPquery_graphest ajouté à~/.cache/graphify-queries.logau format JSON Lines (horodatage, question, corpus, nombre de nœuds, durée). Les réponses complètes ne sont pas stockées. Désactivation :GRAPHIFY_QUERY_LOG_DISABLE=1.
Pour un outil local, ce journal est la seule trace d’usage documentée : il permet de voir la durée de chaque requête. Le README mentionne aussi un extra mcp (uv tool install "graphifyy[mcp]") qui sert le graphe par un serveur MCP en stdio ; sur ce type de serveur, voir l’observation des agents MCP avec OpenTelemetry. Je n’ai pas trouvé d’export OpenTelemetry documenté.
Comment vérifier que ça fonctionne
- Après
/graphify ., le dossiergraphify-out/contient biengraph.html,GRAPH_REPORT.mdetgraph.json. - Ouvrez
graph.html: les communautés correspondent-elles aux sous-systèmes que vous connaissez ? - Lancez
graphify explainsur un composant connu et comparez les liensEXTRACTEDavec le code.
Limites et points ouverts
- Chiffres du projet : le README publie des résultats (LOCOMO, LongMemEval-S, ERPNext) en précisant qu’ils viennent du projet lui-même ; ils ne sont pas reproduits ici. L’accroche « réduire de 80 % la dépense en tokens des agents » concerne l’offre cloud et reste une affirmation commerciale.
- Offre cloud : « Graphify Cloud », payant, est promu dans tout le README. L’outil local reste utilisable seul, mais lisez la page avant de dépendre d’une fonction.
- Dépendances optionnelles : certaines options exigent un compilateur C ou une version précise de Python ; Codex demande
multi_agent = truepour l’extraction parallèle. - Jeunesse : plus de 130 000 étoiles, des versions fréquentes, un numéro de version inférieur à 1.0 : attendez-vous à des changements.
Bonnes pratiques
- Commencez par un dépôt non sensible, avec
--code-onlysi vous ne voulez rien envoyer à un modèle. - Excluez les secrets et les données personnelles du corpus avant la passe sémantique.
- Relisez les liens
INFERREDavant de les citer dans une revue. - Décidez de la conservation du journal
~/.cache/graphify-queries.log, qui contient vos questions. - Complétez avec une mémoire d’agent ou une compression de contexte : voir context-mode et la fenêtre de contexte des agents.
Questions fréquentes
Graphify envoie-t-il mon code à un service ?
Selon le README, le code est analysé localement. Seuls les documents, PDF et images passent par votre assistant ou le fournisseur que vous configurez.
Quelle différence avec une recherche vectorielle ?
Le projet affirme n’utiliser ni embeddings ni base vectorielle : il construit un graphe de relations que l’on parcourt (query, path, explain).
Graphify fonctionne-t-il avec le serveur MCP de GitHub ?
Ce sont deux outils distincts : l’un cartographie un projet, l’autre expose l’API GitHub à un agent. Voir le serveur MCP officiel de GitHub.
Conclusion
Graphify propose une façon concrète de comprendre un code inconnu : un graphe local, des liens explicités et trois commandes d’interrogation. Testez-le sur un dépôt non sensible, lisez les deux fichiers de licence, désactivez le journal si besoin, et tenez les chiffres du README pour des affirmations du projet.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni aux projets cités. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans leur documentation officielle (docs.graphify.com).