Vendredi, la question tombe en réunion d’équipe : peut-on héberger un gros modèle ouvert sur la machine de bureau, sans serveur à huit GPU ? Pour un modèle MoE local, la réponse dépend moins de la puissance de calcul que d’un arbitrage entre RAM, disque et patience. Colibri, un dépôt GitHub d’inférence en C, propose précisément de faire cet arbitrage à votre place.
Je pars de la décision d’exploitation, pas de l’installation : que faut-il savoir avant de télécharger 400 Go ? Cadre de lecture : je n’ai pas lancé Colibri. Tout vient du dépôt JustVugg/colibri, lu le 10 novembre 2026 (README, CHANGELOG, documentation de l’API). Les vitesses citées sont celles du projet, sur ses propres machines.
Le dépôt est sous licence Apache 2.0. La version 2.1.0 date du 31 octobre 2026 et l’activité est quotidienne. GitHub affichait environ 49 500 étoiles et 5 800 forks (valeurs arrondies par la page, non exactes). Le projet est jeune et rapide : traitez ses chiffres comme des mesures à reproduire.
Modèle MoE local : pourquoi la RAM n’est plus le seul verrou
Un modèle MoE (mixture of experts) est énorme sur disque mais frugal par token. D’après le README, GLM-5.2 compte 744 milliards de paramètres, en active environ 40 milliards par token (5,4 %), et seuls 11 Go environ changent d’un token au suivant : les experts routés.
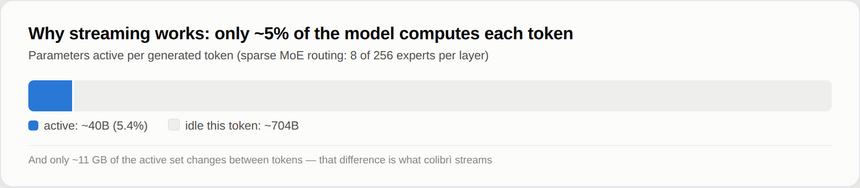
La conséquence pratique est simple. Le modèle n’a pas besoin de tenir en mémoire rapide : il doit être placé. Colibri garde en RAM la partie dense (attention, experts partagés, embeddings) et lit les experts sur le disque à la demande, à travers un cache qui apprend ceux que votre usage sollicite. Un GPU, s’il existe, accueille les experts les plus chauds.
Le projet insiste sur un point : l’emplacement d’un poids ne change que la vitesse, pas le résultat. Moins de mémoire rapide peut coûter du temps, jamais la précision du modèle, dit le README. C’est une promesse du projet, que je ne peux pas confirmer sans mesure.
Combien de tokens par seconde : lire le tableau avant de rêver
Le README donne, par modèle, un seuil de RAM sous lequel rien ne démarre et un second seuil à partir duquel la vitesse mesurée est atteinte. Quelques lignes, telles que publiées :
- Qwen3.6-35B-A3B (23 Go à télécharger) : 6,0 tokens/s sur CPU, 30,0 avec CUDA sur une RTX 3070 ;
- DeepSeek V4 Flash (167 Go) : 0,93 token/s avec 32 Go de RAM, CPU seul ;
- GLM-5.2 (429 Go, 16 Go de RAM minimum) : de 0,05 à 0,1 token/s à froid sur un portable de 25 Go, 1,83 sur une machine à 128 Go, 9,0 à 9,2 sur six RTX 5090 ;
- Kimi K3 (1,56 To) : environ 9,4 secondes par token.
Lisez cela comme un SRE lit un SLO : un portable qui sort un token toutes les dix à vingt secondes répond « correctement », mais il ne sert aucun utilisateur. Pour du batch de nuit, de l’évaluation ou un assistant solitaire, une vitesse inférieure à un token par seconde peut suffire. Pour une équipe qui discute en direct, visez les petits modèles ou un GPU.
Le disque est le facteur décisif pour les gros modèles. Le projet indique qu’un NVMe rapide aide le plus, et que deux NVMe sur des contrôleurs indépendants ont mesuré +37,5 % de débit de génération. Un seul disque lent n’est pas un détail : c’est votre plafond.
Installer Colibri : ce que dit le README
Matériel minimal annoncé : 8 Go de RAM (16 Go ou plus conseillés), 22 Go libres pour le plus petit modèle, une connexion internet. Le GPU est facultatif ; Vulkan, CUDA et Metal sont pris en charge selon les moteurs. Le parcours en une étape, sous Linux :
sudo apt install git python3 build-essential
git clone https://github.com/JustVugg/colibri
cd colibri
./start-here.sh
Sous Windows, on décompresse l’archive et on lance START-HERE.bat ; sous macOS, on installe Xcode CLT, libomp, git et python avec Homebrew, puis on lance le même script. Le programme inspecte la machine, recommande le modèle le plus capable qui tient en RAM, construit le moteur, télécharge avec reprise, puis ouvre le tableau de bord. Les options utiles : --list compare tous les modèles à votre machine, --model ID en impose un, --dir change le disque cible.
Avant d’engager 400 Go, trois commandes du lanceur sont faites pour décider, toujours selon le README : coli plan montre où le modèle vivra (VRAM, RAM, disque), coli doctor vérifie sans rien modifier, coli tune mesure et enregistre les réglages les plus rapides sûrs pour la machine.
Voir les experts travailler
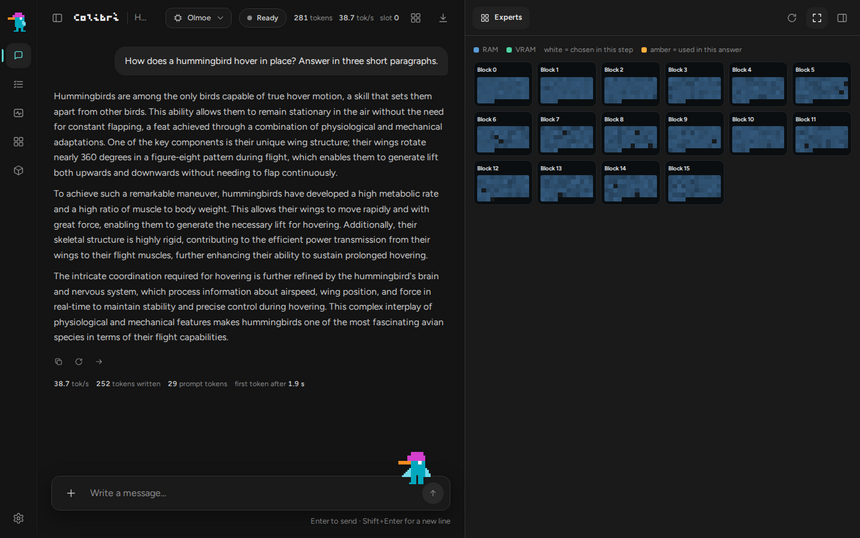
Le tableau de bord (coli web) et l’interface coli ui affichent une carte des experts : une cellule par expert dans chaque bloc, blanche quand elle est choisie à l’étape courante, ambre quand elle a servi dans la réponse. La capture ci-dessous montre OLMoE, le petit modèle de 7 milliards de paramètres que le projet conseille pour apprendre les outils.
Un deuxième écran, le moniteur, donne l’état du modèle (inactif, lecture, écriture), la vitesse, la lecture du prompt, la RAM et le CPU du moteur.
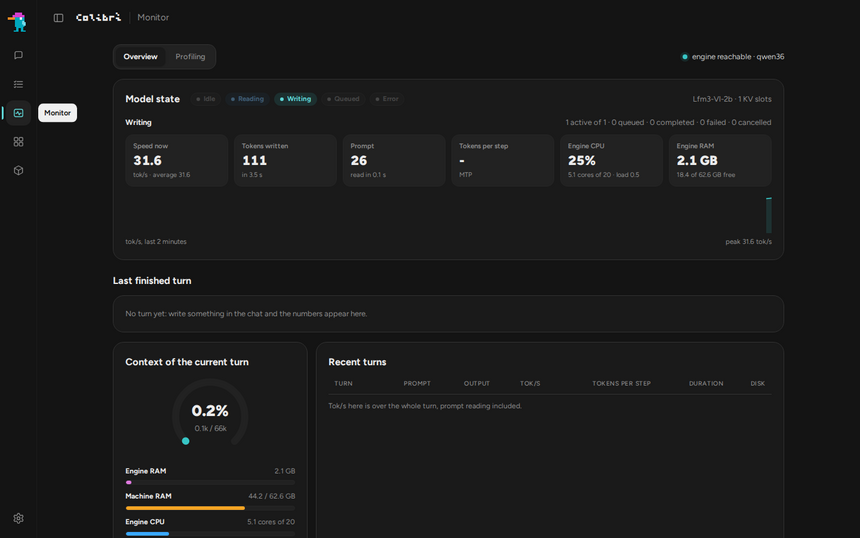
Ces deux captures viennent du dépôt du projet (licence Apache 2.0) ; elles ne montrent pas un gros modèle en difficulté, mais de petits modèles confortables. Ne les prenez pas pour une preuve de vitesse sur du 744 milliards.
Exposer et superviser le serveur
coli serve lance un serveur compatible OpenAI (/v1/chat/completions) et Anthropic (/v1/messages). Par défaut il écoute sur localhost. Selon la documentation, il faut définir COLI_API_KEY avant de l’ouvrir au réseau. Faites-le avant toute chose : un serveur d’inférence sans clé sur un réseau d’entreprise est un point d’entrée gratuit.
Côté supervision, la documentation de l’API décrit deux points utiles. GET /health expose les compteurs actifs, en file, terminés et rejetés, répond 503 avec {"status": "restarting"} pendant le redémarrage du moteur et compte les redémarrages dans engine_restarts. GET /metrics sert du texte Prometheus dont tous les noms commencent par colibri_scheduler_, avec des jauges (active, queued), des compteurs (completed_total, failed_total, rejected_total, timed_out_total) et des histogrammes (queue_wait_seconds, first_output_seconds, engine_call_seconds). Les métriques ne contiennent ni prompt ni chemin de modèle.
Un Collector OpenTelemetry peut les récupérer avec le récepteur Prometheus. Exemple minimal, à adapter (cible et exporteur sont des valeurs d’exemple) :
receivers:
  prometheus:
    config:
      scrape_configs:
        - job_name: colibri
          scrape_interval: 30s
          authorization:
            credentials: ${env:COLI_API_KEY}
          static_configs:
            - targets: ["127.0.0.1:8000"]
exporters:
  otlphttp:
    endpoint: ${env:OTLP_ENDPOINT}
service:
  pipelines:
    metrics:
      receivers: [prometheus]
      exporters: [otlphttp]
Je n’ai pas testé cette configuration avec Colibri ni vérifié l’ingestion côté Dynatrace, Managed ou SaaS : c’est du Collector standard. Les signaux à suivre : queue_wait_seconds pour la contention, first_output_seconds pour l’attente de l’utilisateur et failed_total avec engine_restarts pour détecter un moteur tué par le gestionnaire de mémoire. Pour aller plus loin sur la supervision d’un moteur local, voir notre article sur Ollama et celui sur vLLM en production.
Limites et points ouverts
- Le dépôt est jeune et évolue vite : 387 pull requests entre les versions 2.0.0 et 2.1.0, selon le CHANGELOG. Épinglez une version.
- Le projet range lui-même ses pistes d’optimisation dans une liste d’hypothèses à reproduire, avec des échecs publiés, par exemple une spéculation MTP mesurée 32 % plus lente vers 85 % de réussite du cache. Bon signe d’honnêteté, mais aussi preuve que les réglages se mesurent machine par machine.
- Toutes les vitesses viennent du projet : aucune n’a été reproduite ici.
- Certains modèles ont leur propre licence (Qwen-Image non commerciale, Muse Spark Open sous accord Meta) : l’Apache 2.0 du moteur ne couvre pas les poids.
- Comparez à des moteurs plus répandus avant de choisir : voir le comparatif Ollama, vLLM et llama.cpp et, pour un gros modèle sur GPU, l’auto-hébergement de Mistral Large 4.
Bonnes pratiques
- Commencez par un petit modèle (OLMoE ou Qwen3.6) pour vérifier la chaîne complète avant le gros téléchargement.
- Mettez les modèles sur le NVMe le plus rapide, jamais sur un montage réseau ou
/mnt/csous WSL, que le README déconseille. - Définissez
COLI_API_KEYet gardez l’écoute sur localhost tant qu’un reverse proxy authentifié n’est pas en place. - Collectez
/metricsdès le premier jour, avec une alerte surfailed_totalet sur la durée defirst_output_seconds. - Notez vos propres mesures (matériel, commande, état du cache) : le projet les réclame, et ce sont elles qui vous donneront un SLO crédible.
Questions fréquentes
Faut-il un GPU pour un modèle MoE local avec Colibri ?
Non, selon le README : chaque moteur tourne sur CPU. Le GPU est un endroit plus rapide pour garder des poids. Pour les gros modèles, c’est le disque qui fixe la vitesse ; pour les petits, la RAM.
Quelle vitesse espérer sur une machine ordinaire ?
Elle varie de plus de 100 fois selon le modèle : de quelques tokens par seconde pour un modèle de 35 milliards, à moins d’un token par seconde pour les très gros. Mesurez avec coli tune sur votre matériel plutôt que de vous fier à un tableau.
Colibri est-il adapté à une équipe ?
Le serveur gère une file, des emplacements de cache et des refus 429, mais je n’ai pas vérifié son comportement sous charge. Testez avec vos usages et surveillez la file avant d’ouvrir le service.
Conclusion
Un modèle MoE local devient réaliste parce que seule une petite fraction des paramètres travaille à chaque token. Colibri pousse cette idée jusqu’au bout : la RAM garde le cœur du modèle, le disque garde le reste. Avant de télécharger, regardez le tableau de votre machine, lancez coli plan, et branchez /metrics pour que la vitesse annoncée devienne une vitesse mesurée.
Ce blog est indépendant et non affilié à Dynatrace LLC. Colibri est un projet tiers ; les informations viennent de son dépôt public et peuvent évoluer, vérifiez-les avant toute mise en production.