
La facture du cloud a grimpé de 20 % après un déploiement, et personne ne sait quelle équipe en est responsable. C’est le scénario qui justifie de regarder OpenCost Kubernetes : un projet open source, sous licence Apache 2.0 d’après le fichier LICENSE du dépôt opencost/opencost, qui répartit la dépense d’un cluster entre namespaces, contrôleurs et pods.
Cet article part d’une question d’exploitation, « quel changement a fait bouger le coût, et où le voir ? », plutôt que d’un tour des fonctions. Les faits viennent du README du dépôt et de la documentation sur opencost.io, lus le 11 novembre 2026. span.observer n’a pas déployé OpenCost pour cet article : les extraits ci-dessous reprennent des commandes et formules de la documentation, avec des valeurs d’exemple.
Le sujet est distinct de notre article sur les requêtes CPU effectives, qui règle les ressources d’un pod. Ici, on traduit ces ressources en monnaie.
OpenCost Kubernetes : ce que le projet fait et ne fait pas
- Licence et statut : Apache 2.0 ; le site opencost.io le présente comme un projet « incubating » de la Cloud Native Computing Foundation.
- Origine : développé puis ouvert par Kubecost, selon le README. Le dépôt combine une spécification et une implémentation en Go ; l’interface web vit dans un dépôt séparé,
opencost/opencost-ui. - Périmètre : répartition des coûts par cluster, nœud, namespace, type de contrôleur, contrôleur, service ou pod, pour le CPU, le GPU, la mémoire et les volumes persistants. Les coûts cloud d’AWS, Azure et GCP sont aussi couverts, et le CSV de prix sert aux clusters sur site.
- Ce que le README ajoute : un export Prometheus sur
/metrics, des coûts carbone, un serveur MCP et un suivi du coût d’inférence pour les déploiements vLLM. Je n’ai testé aucune de ces fonctions.
Limite à garder en tête : OpenCost estime et répartit une dépense. Il ne remplace ni la facture du fournisseur ni une analyse de performance.
Comment OpenCost calcule un coût
Pour savoir si un chiffre est crédible, il faut connaître la recette. La spécification découpe le coût total d’un cluster en deux familles : les actifs (nœuds, volumes, disques, répartiteurs de charge, trafic réseau) et les frais généraux, comme les frais de gestion du cluster.
Un actif coûte soit une allocation (on paie le temps réservé, quelle que soit l’utilisation), soit un usage (on paie à l’unité, par exemple l’octet sortant). La documentation donne les formules.
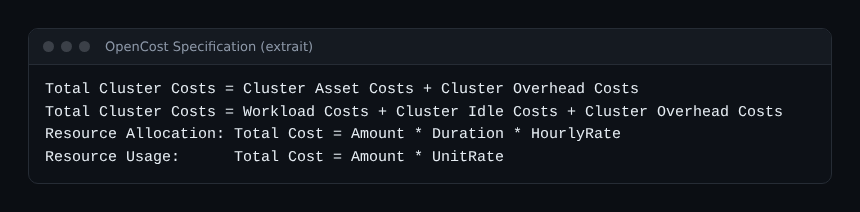
La seconde ligne compte le plus pour la décision. Les coûts des charges de travail plus le coût inactif (« idle ») plus les frais généraux égalent le coût total. Le coût inactif est la part de ressources allouées qu’aucune charge de travail ne réclame. Un cluster surdimensionné ne devient donc pas « gratuit » : sa dépense réapparaît dans cette ligne.
Installer sans se tromper de prérequis
Le README indique une installation par le chart Helm officiel uniquement, sur Kubernetes 1.20 ou plus ; les manifestes autonomes ont été retirés :
helm repo add opencost https://opencost.github.io/opencost-helm-chart
helm repo update
helm install opencost opencost/opencost
Attention à une nuance de la documentation. La page d’installation dit que Prometheus est un prérequis pour le stockage et la collecte, avec une variable PROMETHEUS_SERVER_ENDPOINT pour pointer vers votre serveur. La page d’intégration précise, elle, qu’un client Prometheus n’est pas nécessaire pour émettre les métriques de coût. Les deux énoncés se concilient ainsi : OpenCost lit ses données d’entrée dans Prometheus et peut ensuite exposer ses propres métriques. Je ne l’ai pas vérifié sur un cluster.
Les entrées attendues viennent de node-exporter (par exemple node_cpu_seconds_total) et de kube-state-metrics (par exemple kube_pod_container_resource_requests). Si votre Prometheus collecte déjà kube-state-metrics, la documentation prévient d’un risque de métriques en double. Un Prometheus partitionné demande un point d’entrée global, de type Thanos Query ou Mimir ; voir notre article sur Mimir pour ce stockage.
Interroger l’API de coûts
L’API écoute par défaut sur le port 9003 du service. La documentation montre comment l’atteindre en local, puis trois requêtes types :
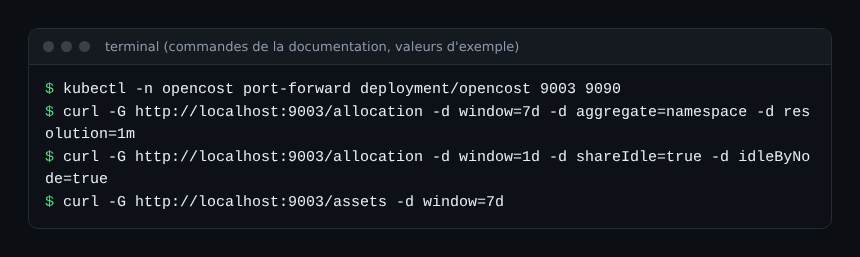
Trois paramètres déterminent la lecture du résultat :
windowfixe la période :7d,today, une paire de dates RFC3339 ou des horodatages Unix.aggregatechoisit la clé de répartition : namespace, contrôleur, pod, mais aussi une étiquette (label:app) ou une annotation.shareIdle=truerépartit le coût inactif au prorata des coûts non inactifs de chaque allocation.idleByNode=truele calcule par nœud plutôt que pour le cluster entier.
Le paramètre resolution règle l’arbitrage entre précision et mémoire : 1 minute par défaut, plus fin pour les pods de courte durée, moins coûteux en requêtes avec une valeur plus grande. Pour un job de dix minutes, évitez une résolution large.
Relier le coût à l’observabilité
C’est le point où le sujet quitte la finance. OpenCost expose ses résultats comme des métriques Prometheus. Une configuration de scrape suffit à les mettre à côté de vos latences et de vos taux d’erreur.
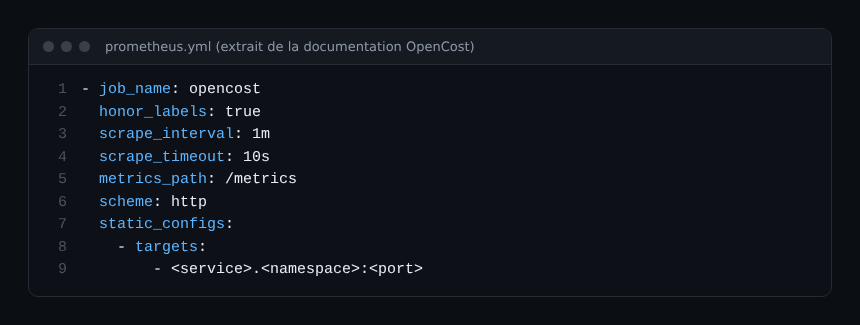
La documentation propose aussi des requêtes de départ, par exemple sum(node_total_hourly_cost) * 730 pour le coût mensuel de tous les nœuds, ou sum(kubecost_load_balancer_cost) by (namespace) pour les répartiteurs de charge par namespace. Le préfixe kubecost_ de certaines métriques est un héritage du projet d’origine.
Concrètement, trois usages se tirent de cette jonction :
- Annoter un déploiement : superposer le coût horaire d’un namespace à la courbe des déploiements. Si la ligne monte avec la version 42, vous tenez votre suspect.
- Comparer coût et trafic : un service dont le coût monte alors que ses requêtes par seconde stagnent mérite une revue de ses requêtes et limites de ressources.
- Alerter sur une dérive : une règle sur un namespace, sur le modèle de nos recording rules Prometheus, vaut mieux qu’une surprise en fin de mois.
Attention à la cardinalité : chaque étiquette ajoutée aux métriques multiplie les séries. Relisez l’article sur la cardinalité des métriques Kubernetes avant de filtrer sur des étiquettes de pod éphémères.
Pour la place de Prometheus face à OpenTelemetry, voir notre comparaison. Ce que j’ai lu sur OpenCost passe par Prometheus ; je n’ai pas vérifié d’export OpenTelemetry natif.
Le serveur MCP : à activer en connaissance de cause
Le README décrit un serveur MCP, désactivé par défaut et activable avec --set opencost.mcp.enabled=true, qui écoute sur le port 8081. Il expose notamment get_allocation_costs, get_asset_costs, get_cloud_costs et get_efficiency (recommandations de dimensionnement). Un agent pourrait donc répondre à « quel namespace a le plus augmenté cette semaine ? ». Comme pour tout agent, cadrez son accès avant de l’ouvrir : voir notre analyse des promesses des agents SRE.
Limites et points non vérifiés
- Prix de liste : l’API d’allocation se base sur les tarifs à la demande ; les remises et engagements apparaissent via les coûts cloud, si vous les branchez.
- Nombre d’étoiles, version courante, trafic réel : non relevés, donc non cités.
- Prérequis Prometheus : formulation ambiguë dans la documentation, à valider sur votre version.
- Dynatrace : aucun lien officiel entre OpenCost et Dynatrace n’a été lu pour cet article. Ne présumez pas d’intégration.
Bonnes pratiques
- Standardisez les étiquettes
teametappavant l’installation : sans elles, l’agrégation par étiquette reste vide. - Démarrez sur un seul cluster et comparez le total avec la facture du mois écoulé.
- Gardez le serveur MCP désactivé tant qu’aucun besoin n’est écrit.
- Suivez le coût inactif comme un indicateur de capacité, pas comme une faute d’équipe.
Questions fréquentes
OpenCost est-il gratuit ?
Le code est sous licence Apache 2.0 et la documentation sous CC BY 4.0. Le coût du cluster qui l’héberge et de Prometheus reste à votre charge.
OpenCost remplace-t-il la facture du fournisseur cloud ?
Non. Il répartit et estime la dépense à partir de tarifs et de métriques. Rapprochez toujours son total de la facture.
Faut-il Prometheus pour utiliser OpenCost ?
La documentation d’installation le décrit comme un prérequis, avec un point d’accès configurable. Celle de l’intégration précise qu’un client Prometheus n’est pas nécessaire pour émettre les métriques de coût.
Conclusion
OpenCost vaut un essai si la question « qui coûte quoi » revient à chaque revue de facture. Commencez par un cluster, une fenêtre de sept jours et une agrégation par namespace, puis superposez le résultat à vos déploiements. Sources : documentation OpenCost et dépôt opencost/opencost.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni au projet OpenCost. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans la documentation officielle.