Pour observer l’eBPF Kubernetes au niveau réseau, Cilium et Hubble forment la combinaison la plus documentée du projet open source. Cilium s’appuie sur eBPF, une technologie du noyau Linux, pour appliquer des politiques réseau. Hubble, construit dessus, rend visibles les flux entre pods, sans modifier les applications.
Ce guide montre comment activer Hubble, lire les flux avec la CLI, puis exporter des métriques vers Prometheus. Il s’adresse aux équipes SRE et plateforme qui doivent répondre à une question simple : qui parle à qui dans le cluster, et pourquoi cela échoue ? Les commandes viennent de la documentation officielle de Cilium (page « stable », chart 1.20.4 au moment de la lecture).
eBPF Kubernetes : ce que Cilium et Hubble observent
Selon la documentation Cilium, eBPF permet d’insérer dynamiquement de la logique de visibilité et de contrôle dans le noyau. Les politiques s’appliquent donc sans changer le code applicatif ni la configuration des conteneurs. Cilium raisonne par identités de charges de travail plutôt que par adresses IP, ce qui reste lisible quand les pods changent d’adresse.
Hubble est la couche d’observabilité de Cilium. D’après la documentation, il décrit quatre usages :
- les dépendances entre services, avec une carte des communications, y compris les appels HTTP ;
- la surveillance réseau : échecs de communication, problèmes de résolution DNS, connexions TCP interrompues, requêtes SYN sans réponse ;
- la surveillance applicative : taux de réponses HTTP 4xx et 5xx, percentiles de latence ;
- l’observabilité de sécurité : connexions bloquées par une politique réseau, accès venus de l’extérieur du cluster.
Ce sont des flux réseau, pas des traces distribuées. Un flux Hubble indique qu’un pod a contacté un autre pod et que le trafic a été transmis ou bloqué. Il ne remplace pas un span OpenTelemetry, qui décrit le travail d’un service. Les deux se complètent, comme l’explique notre article sur OpenTelemetry et Prometheus.
Deux niveaux de visibilité : nœud et cluster
Par défaut, l’API Hubble tourne sur chaque nœud où s’exécute l’agent Cilium. La documentation précise que cela limite la vision au trafic observé par l’agent local. On l’interroge alors avec la CLI hubble par un socket Unix local ; la CLI est installée par défaut dans les pods de l’agent.
Pour une vue du cluster entier, il faut déployer Hubble Relay. Il étend la visibilité à tout le cluster, voire à plusieurs clusters en ClusterMesh. La CLI ou l’interface Hubble UI s’y connectent ensuite. Cette interface web découvre automatiquement le graphe de dépendances entre services (L3/L4 et L7) et affiche les flux sous forme de carte filtrable.
Prérequis
- Cilium installé et fonctionnel dans le cluster (
cilium statusle confirme). - Le port TCP 4244 ouvert sur tous les nœuds qui exécutent Cilium, exigence explicite de la documentation.
- La CLI
hubbleinstallée sur le poste ; le port local 4245 libre pour le port-forward de Relay.
Activer Hubble et lire les premiers flux
La commande d’activation est courte. D’après la documentation, cilium hubble enable modifie la ConfigMap cilium-config, redémarre les pods Cilium, génère les certificats de Relay et déploie Relay.
- Vérifier l’état avec
cilium status, puis lancercilium hubble enable. - Installer la CLI
hubbleen suivant la page de la documentation (téléchargement de l’archive, contrôle de la somme SHA-256, copie dans/usr/local/binsous Linux). - Ouvrir le port-forward de Relay avec
cilium hubble port-forward. L’équivalent kubectl estkubectl -n kube-system port-forward service/hubble-relay 4245:80. - Contrôler l’accès avec
hubble status, puis afficher les flux avechubble observe.
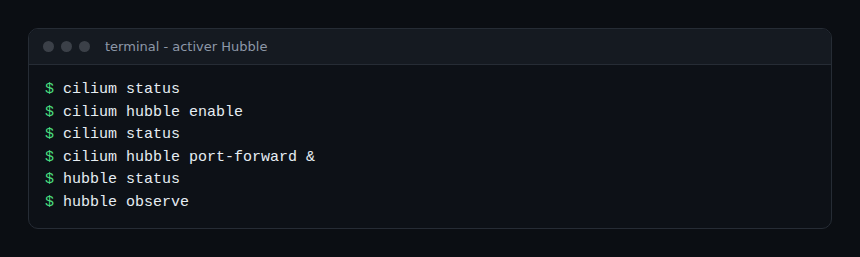
Le drapeau -P ouvre le port-forward de Relay automatiquement sur le port 4245 : hubble status -P et hubble observe -P. Si le port local diffère, la documentation indique de fixer l’adresse avec --server ou la variable d’environnement HUBBLE_SERVER.
Pour une installation par Helm, la documentation donne l’activation de Relay avec helm upgrade cilium cilium/cilium --namespace kube-system --reuse-values --set hubble.relay.enabled=true, en précisant la version du chart. Hubble y est activé par défaut, d’après la même page.
Filtrer les flux avec hubble observe
Un cluster produit énormément de flux. Les filtres sont donc indispensables. La page de la CLI Hubble en donne plusieurs :
hubble observe --pod deathstar --protocol http
hubble observe --pod deathstar --verdict DROPPED
hubble observe --encrypted
hubble observe --reply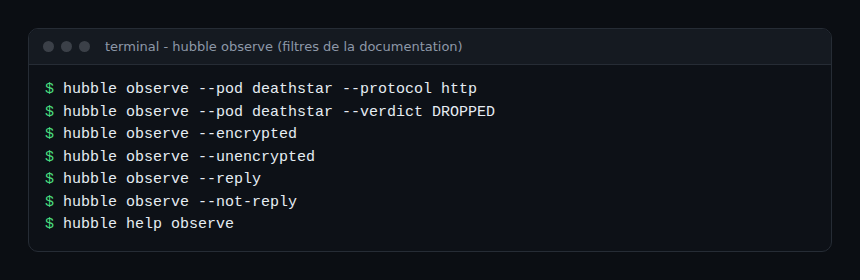
Le premier isole le trafic HTTP (L7) vers un pod. Le deuxième liste le trafic refusé, c’est-à-dire le verdict DROPPED. Les lignes de sortie présentent l’horodatage, la source et la destination (espace de noms, pod, port), le type d’événement, le verdict (FORWARDED ou DROPPED) et, quand ils existent, les détails de la requête L7. Les autres options sont listées par hubble help observe.
Côté fiabilité, le verdict DROPPED sert de point de départ à un diagnostic de politique réseau. Un service qui répond en timeout n’a pas forcément un problème applicatif : une politique peut bloquer son trafic. Hubble tranche en quelques secondes, ce qui réduit le MTTR.
Exporter les métriques Hubble vers Prometheus
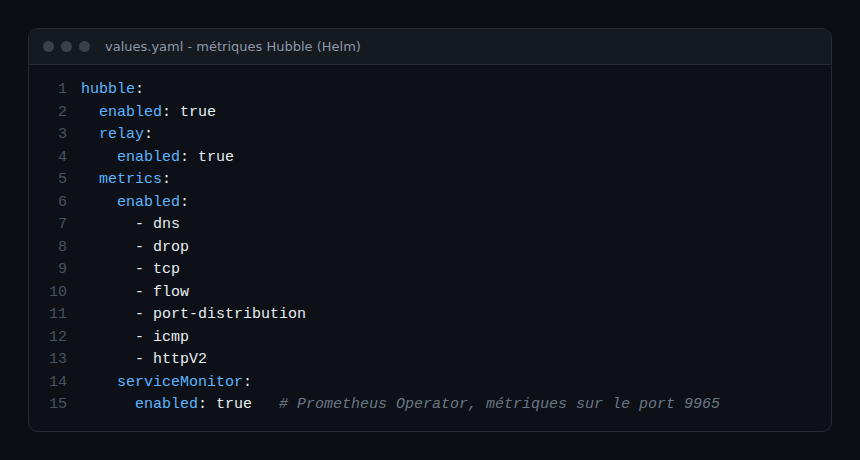
La CLI sert au diagnostic ponctuel. Pour le suivi continu, Hubble expose des métriques au format Prometheus. D’après la documentation, la liste des métriques activées se fixe dans hubble.metrics.enabled, par exemple dns, drop, tcp, flow, port-distribution, icmp et httpV2.
Le chart crée un service headless hubble-metrics avec les annotations prometheus.io/scrape: true et prometheus.io/port: 9965. Le port se règle avec hubble.metrics.port. Avec le Prometheus Operator, hubble.metrics.serviceMonitor.enabled=true crée un ServiceMonitor (les annotations sont alors omises).
Parmi les métriques citées par la documentation figurent hubble_flows_processed_total, hubble_drop_total, hubble_tcp_flags_total et hubble_dns_queries_total. Deux réserves à retenir : les métriques L7 comme HTTP ne sortent que pour les pods dont la visibilité du protocole L7 est activée, et http et httpV2 ne peuvent pas être actifs ensemble.
Place dans une stratégie d’observabilité
Hubble couvre la couche réseau. Les équipes ont encore besoin des métriques de nœuds et de pods, des traces et des logs. Notre guide sur le Collector OpenTelemetry sur Kubernetes décrit la collecte côté plateforme, et celui sur Prometheus et Dynatrace explique comment des métriques Prometheus rejoignent Dynatrace. Les métriques Hubble étant au format Prometheus, ce chemin est envisageable. Une intégration dédiée Cilium vers Dynatrace n’a pas été vérifiée pour cet article et n’est donc pas affirmée.
Pour situer ces outils, voir aussi la comparaison Dynatrace et Grafana.
Bonnes pratiques
- Ouvrir le port 4244 avant l’activation, sinon Relay ne joindra pas les agents.
- Activer seulement les métriques utiles : chaque famille ajoute des séries à stocker.
- Utiliser le verdict
DROPPEDcomme premier réflexe quand un service est injoignable. - Ne pas exposer Relay hors du cluster sans contrôle d’accès : il donne une vue de tout le trafic.
- Relire la page de la version installée : les valeurs du chart évoluent.
Questions fréquentes
Hubble remplace-t-il les traces distribuées ?
Non. Hubble observe des flux réseau et, pour L7, des requêtes. Une trace décrit le parcours d’une requête à travers le code des services. Les deux angles se complètent.
Faut-il modifier les applications pour utiliser Hubble ?
Non. La documentation Cilium indique que Hubble donne de la visibilité sans changer les charges de travail, grâce à eBPF dans le noyau.
Quelle différence entre Hubble sur un nœud et Hubble Relay ?
Sans Relay, la vue se limite au trafic vu par l’agent du nœud. Avec Relay, la CLI et Hubble UI voient le cluster entier, voire plusieurs clusters en ClusterMesh.
Conclusion
Activer Hubble prend quelques commandes, et hubble observe répond vite aux questions de connectivité. Les métriques Prometheus prolongent ce diagnostic dans le suivi continu. Reste à relier ces signaux réseau aux traces et aux logs de l’application.
Sources
- Setting up Hubble Observability, documentation Cilium
- Inspecting Network Flows with the CLI, documentation Cilium
- Monitoring and Metrics, documentation Cilium
- Introduction to Cilium and Hubble, documentation Cilium
span.observer est un blog indépendant, non affilié à Dynatrace LLC ni au projet Cilium. Les noms de produits cités appartiennent à leurs propriétaires respectifs. Les captures sont des rendus de commandes et de configuration tirés de la documentation officielle.