Les recording rules Prometheus précalculent une expression PromQL à intervalle régulier et enregistrent le résultat comme une nouvelle série. Un tableau de bord ou une alerte lit alors cette série prête à l’emploi, au lieu de recalculer une agrégation coûteuse à chaque affichage. Cet article montre comment écrire ces règles, les nommer selon la convention level:metric:operations, les tester avec promtool et les relire dans une démarche SRE.
Le besoin apparaît vite : un SLI de taux d’erreur calculé sur des centaines d’instances, affiché sur dix tableaux de bord et évalué par trois alertes, refait dix fois le même travail. Une règle d’enregistrement le fait une seule fois, avec un nom que toute l’équipe comprend. Le sujet complète la récupération de métriques Prometheus sur Kubernetes, qui traite de l’ingestion plutôt que du calcul.
En bref
- Une recording rule est une paire
record(nom de la nouvelle série) etexpr(expression PromQL), rangée dans un groupe évalué à intervalle fixe. - La convention officielle de nommage est
level:metric:operations: niveau d’agrégation, métrique d’origine, opérations appliquées. - On agrège toujours le numérateur et le dénominateur séparément, puis on divise ; on ne moyenne jamais un ratio.
promtool check rulesvalide la syntaxe,promtool test rulesvérifie les résultats sur des séries fabriquées.
Pourquoi des recording rules Prometheus
Une requête comme sum(rate(http_requests_total[5m])) parcourt toutes les séries concernées à chaque exécution. Sur un cluster Kubernetes chargé, quelques dizaines de panneaux qui la répètent suffisent à ralentir l’interface. Précalculer une fois par minute déplace le coût vers un point unique, prévisible et mesurable.
Le bénéfice est aussi organisationnel. Un nom stable comme path:http_requests:rate5m devient un contrat : les alertes, les tableaux de bord et les rapports de SLO s’appuient sur la même définition du trafic. Cela réduit le toil de relecture et les écarts entre deux écrans qui n’affichent pas le même chiffre. Pour situer Prometheus par rapport à OpenTelemetry, voir OpenTelemetry vs Prometheus.
La structure d’un fichier de règles
Selon la documentation Prometheus, les fichiers de règles sont en YAML et chargés par le champ rule_files de la configuration. Un groupe porte un name obligatoire et unique dans le fichier, un interval facultatif (par défaut global.evaluation_interval) et une liste rules. Une recording rule contient record, un nom de métrique valide, expr, une expression PromQL, et des labels facultatifs ajoutés ou écrasés sur chaque résultat stocké.
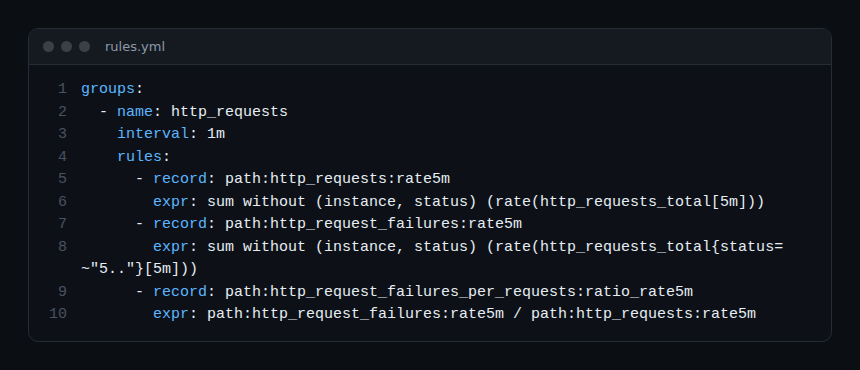
Voici un fichier de trois règles qui calcule le trafic, les échecs et le ratio d’échecs par chemin.
groups:
  - name: http_requests
    interval: 1m
    rules:
      - record: path:http_requests:rate5m
        expr: sum without (instance, status) (rate(http_requests_total[5m]))
      - record: path:http_request_failures:rate5m
        expr: sum without (instance, status) (rate(http_requests_total{status=~"5.."}[5m]))
      - record: path:http_request_failures_per_requests:ratio_rate5m
        expr: path:http_request_failures:rate5m / path:http_requests:rate5m
Les métriques http_requests_total et leurs labels (instance, path, status) sont ici un exemple de l’article, pas une métrique imposée par Prometheus. Le ratio réutilise les noms des deux premières règles, ce qui garde son expression lisible.
Nommer avec level:metric:operations
La page Recording rules des bonnes pratiques Prometheus décrit la forme générale level:metric:operations.
- level : le niveau d’agrégation, c’est-à-dire les labels de la sortie. Ici
path. - metric : le nom de la métrique, inchangé, sauf que
_totalest retiré des compteurs utilisés avecrate()ouirate(). Icihttp_requests_totaldevienthttp_requests. - operations : la liste des opérations appliquées, la plus récente d’abord. Ici
rate5m.
La même page ajoute quelques règles : sans opération évidente, utiliser sum ; pour un ratio, séparer les deux métriques par _per_ et nommer l’opération ratio, d’où path:http_request_failures_per_requests:ratio_rate5m. Les opérations associatives peuvent être fusionnées : min_min s’écrit min.
Agréger avec without plutôt que by
La documentation recommande de toujours utiliser une clause without listant les labels retirés, afin de conserver des labels comme job. Le niveau de sortie ne doit différer du niveau d’entrée que par les labels supprimés : si les niveaux ne correspondent pas, c’est un signe d’erreur. Le préfixe path du nom de la règle rappelle quels labels subsistent à côté de job.
Ne jamais moyenner un ratio
Selon la même page, il faut agréger numérateur et dénominateur séparément, puis diviser. Faire la moyenne de ratios ou de moyennes n’est pas statistiquement valide, car une instance qui reçoit peu de trafic pèserait autant qu’une instance très sollicitée. C’est exactement ce que fait le fichier ci-dessus.
Tester les règles avec promtool
Avant tout déploiement, validez le fichier sans démarrer de serveur :
promtool check rules rules.ymlSelon la documentation, la commande affiche les règles analysées et retourne le code 0 en cas de succès ; sur une erreur de syntaxe, elle écrit sur stderr et retourne 1. Ce code de retour se branche directement dans une étape d’intégration continue.
Pour vérifier les valeurs, la page Unit testing for rules décrit promtool test rules test.yml. Le fichier de test déclare les règles à charger, des séries d’entrée et les échantillons attendus. La notation 0+90x10 génère une série qui démarre à 0 puis augmente de 90 à chacun des 10 pas.
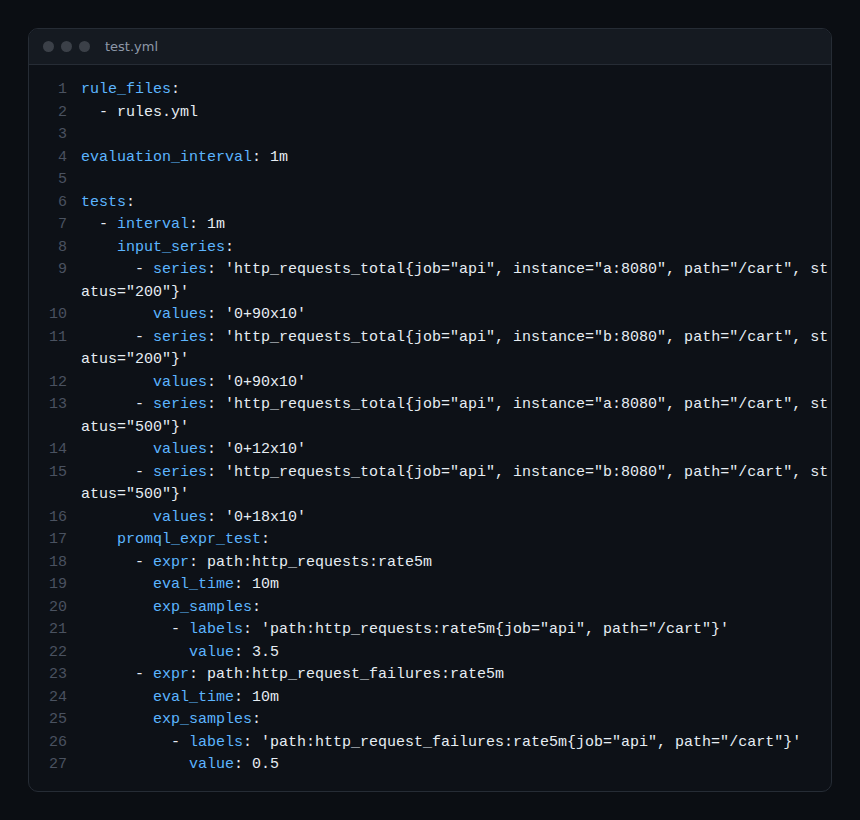
Les valeurs attendues (3,5 requête par seconde au total, 0,5 en échec) résultent d’un calcul à la main : 90 requêtes par minute par instance en succès, soit 1,5 par seconde, deux instances, plus 12 et 18 par minute en erreur. Ce fichier n’a pas été exécuté pour cet article : lancez-le chez vous et corrigez la valeur attendue si votre version de Prometheus extrapole autrement.
Recharger et surveiller les règles
Pour recharger les fichiers à chaud, la documentation indique d’envoyer SIGHUP au processus Prometheus ; les changements ne s’appliquent que si tous les fichiers de règles sont bien formés. Il existe un point de vigilance de fiabilité : si un groupe n’a pas fini son évaluation avant la suivante, celle-ci est sautée et la série enregistrée présente un trou. Le compteur rule_group_iterations_missed_total augmente à chaque itération manquée. Alertez dessus, car un SLI avec des trous fausse la consommation d’error budget. Pour les SLO, voir le comparatif SLO avec Prometheus.
Bonnes pratiques
- Un groupe par thème (trafic, latence, saturation) et un
intervaladapté à la fenêtre de la requête. - Un nom conforme à
level:metric:operationspour chaque règle, sans abréviation maison. - Des tests
promtool test rulesdans le dépôt, exécutés en CI aveccheck rules. - Peu de règles, ciblées sur les requêtes lourdes et réutilisées : chaque règle crée de nouvelles séries à stocker.
- Une alerte sur les évaluations manquées.
Questions fréquentes
Quelle est la différence entre recording rule et alerting rule ?
Les deux vivent dans un groupe de règles. La recording rule stocke le résultat d’une expression dans une nouvelle série ; l’alerting rule évalue une condition et déclenche des alertes. Une alerte peut s’appuyer sur une série enregistrée.
Dois-je respecter la convention de nommage ?
Prometheus ne l’impose pas : record accepte tout nom de métrique valide. La convention vient des bonnes pratiques officielles et rend les séries lisibles d’un coup d’œil, ce qui compte en astreinte.
Ces séries sont-elles utilisables avec OpenTelemetry ou Dynatrace ?
Une série enregistrée reste une métrique Prometheus ordinaire. Pour la transporter vers une autre plateforme, suivez la méthode décrite dans cet article sur Prometheus et Kubernetes et vérifiez dans la documentation de la plateforme cible le traitement des compteurs et des jauges. Les règles elles-mêmes restent évaluées par Prometheus.
Conclusion
Les recording rules Prometheus déplacent les agrégations coûteuses hors des tableaux de bord et donnent aux SLI un nom stable. Appliquez level:metric:operations, agrégez avec without, divisez après avoir agrégé, testez avec promtool et surveillez les itérations manquées. La différence entre observabilité et simple supervision, qui motive ce travail sur les SLI, est détaillée dans cet article.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Dynatrace est une marque de son propriétaire. Prometheus est un projet de la Cloud Native Computing Foundation. Les procédures évoluent : vérifiez toujours la documentation officielle avant un changement en production.