PdfCraft, lecteur éditeur PDF open source écrit en Rust, est développé par l’équipe ArtCraft (organisation GitHub « storytold »). Le projet se décrit comme une réimplémentation « clean-room » d’Adobe Acrobat, construite d’après la norme ISO 32000 et l’observation du comportement, et précise ne pas être affilié à Adobe. Ces affirmations sont celles du projet, et span.observer ne les garantit pas.
Chiffres lus sur la page du dépôt à la mi-octobre 2026 : environ 14 900 étoiles et 5 800 forks, double licence MIT ou Apache-2.0 (au choix), dernière version v0.8.0 publiée le 14 octobre, code en Rust d’après le README (qui demande Rust 1.95 ou plus récent pour compiler). span.observer n’a pas installé le logiciel : cet article s’appuie sur le README, la documentation du dépôt et ses captures.
Dans la même famille, WordCraft exporte déjà vers PDF, et PhotoCraft traite les images. Côté agents, le README décrit une CLI et un serveur MCP facultatif : lisez d’abord le Model Context Protocol expliqué.
PdfCraft, lecteur éditeur PDF open source : visite
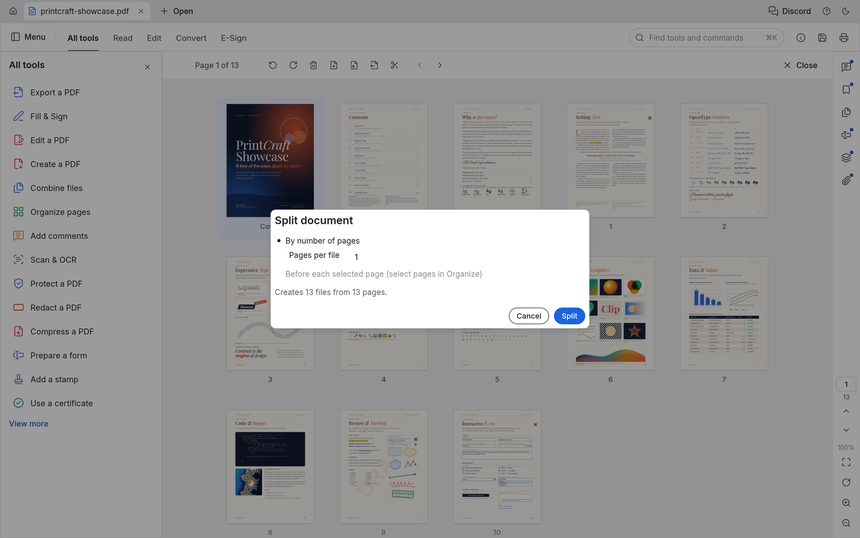
La fenêtre combine des onglets de documents, des modes (All tools, Read, Edit, Convert, E-Sign), un catalogue d’outils à gauche et un panneau de commentaires à droite. La capture ci-dessous montre le document de démonstration que le dépôt génère lui-même (cargo xtask demo-pdf).
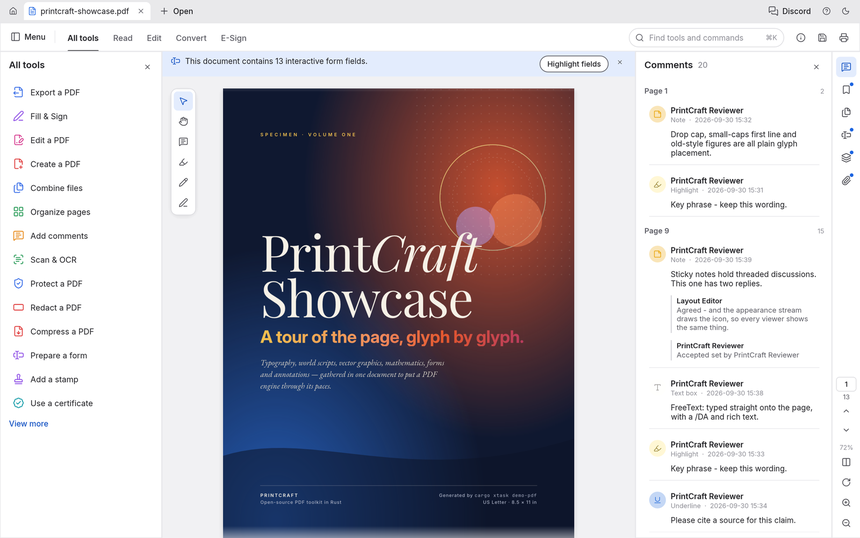
Le README met en avant une lecture soignée : crénage et ligatures, écritures de droite à gauche, CJK vertical, rendu par tuiles pour que le texte reste net en zoom profond, thèmes clair et sombre. Il précise que les pages sont encore dessinées par la bibliothèque hayro, en attendant le moteur de rendu du projet.
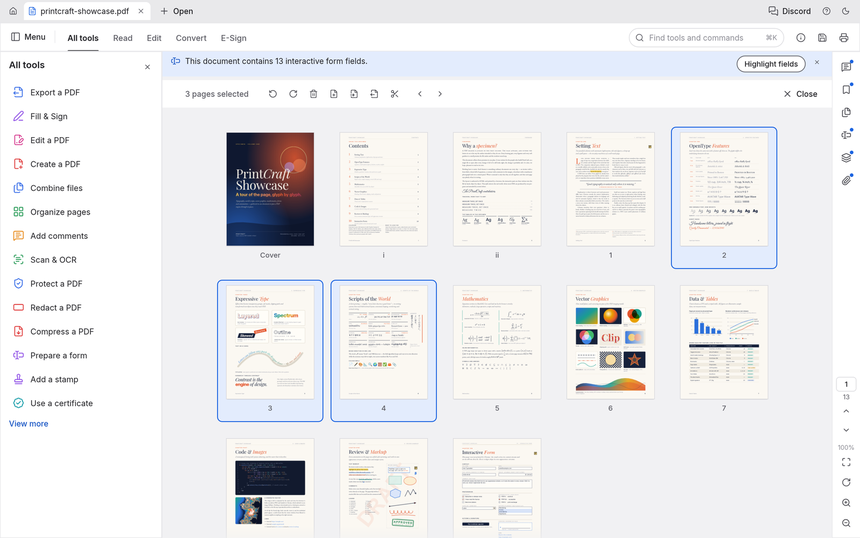
L’organisation des pages (pivoter, supprimer, insérer, déplacer, avec annulation profonde) se fait sur une grille de vignettes. Les enregistrements sont incrémentaux et atomiques : enregistrer au même emplacement ajoute une mise à jour au fichier, sans toucher aux octets d’origine.
Installer PdfCraft : commandes du README
git clone https://github.com/storytold/pdfcraft
cd pdfcraft
cargo xtask models                                # modèles OCR pour Scan & OCR
cargo run --release -p pdfcraft -- some.pdf       # application de bureau
La commande cargo xtask models récupère les modèles OCR ; le README précise que les builds publiés les incluent. Sans compiler, prenez un paquet sur les releases GitHub : macOS, Windows (x64, x86, ARM64), Linux (AppImage, Flatpak, .deb, .rpm, archives), FreeBSD et une version web WebAssembly. Pour automatiser sans interface, le README cite pdfcraft-cli :
pdfcraft-cli combine report.pdf appendix.pdf --out combined.pdf
pdfcraft-cli extract report.pdf --pages 1,3,5-8 --out highlights.pdf
pdfcraft-cli split   report.pdf --every 10 --out-dir parts/
Limites et points ouverts
- Alpha : le projet estime être à environ 55 % du chemin pour remplacer Acrobat dans le travail courant, et 49 % face à Acrobat Pro entier (estimations du projet, octobre 2026).
- Édition du texte existant : le README la range parmi les points « minces ou manquants », surtout pour le CJK et l’écriture de droite à gauche. Même constat pour l’OCR hors écriture latine, l’import ou l’export Office, PDF/X et PDF/UA, les formulaires XFA.
- Robustesse : sur le corpus de tests de pdf.js (983 fichiers), le README annonce 963 fichiers ouverts et rendus proprement et 0 plantage. Il reconnaît que le fuzzing trouve encore des plantages et des blocages sur des fichiers hostiles : méfiez-vous des PDF de provenance inconnue.
- Confidentialité : le README affirme l’absence de compte, de télémétrie et de traitement dans le cloud.
Mesurer PdfCraft sur un poste de travail
PdfCraft est une application de bureau : rien à superviser côté serveur, et aucune fonction de télémétrie à inventer, puisque le projet dit ne pas en avoir. Ce qui se mesure, c’est le comportement local. Le journal pdfcraft.log se trouve sous ~/.local/share/pdfcraft/logs/ (Linux et FreeBSD), ~/Library/Application Support/PdfCraft/logs/ (macOS) ou %APPDATA%\PdfCraft\data\logs\ (Windows). Chaque lancement archive le précédent (pdfcraft.1.log, .2.log), le fichier est plafonné à 16 Mio, et le jeton du canal de contrôle comme les mots de passe de documents n’y sont jamais écrits.
Le niveau se règle avec RUST_LOG (par exemple RUST_LOG=warn,pdfcraft_render=trace), et WGPU_POWER_PREF oriente le choix du GPU ; le journal indique la carte retenue. Le README ajoute que l’enregistrement automatique se fait chaque minute, avec une offre de récupération après une fermeture inattendue : un plantage laisse donc une trace dans le journal et un document récupérable. Pour le reste, utilisez les outils du système : durée de démarrage, mémoire résidente sur un gros PDF, nombre de sessions sans panique. Un seuil de type « 99 % des sessions sans panique sur un mois » est un SLI simple à tenir sur un parc de postes.
Bonnes pratiques
- Ouvrez les PDF douteux dans un environnement isolé tant que le projet est en alpha.
- Travaillez sur des copies avant tout enregistrement, même si les écritures sont atomiques.
- Le canal de contrôle et le serveur MCP sont facultatifs : le README demande de garder le fichier de contrôle dans un dossier que vous seul pouvez écrire. Voir sécuriser un serveur MCP et les garde-fous des agents IA.
- Joignez
pdfcraft.logà vos rapports de bogue.
Questions fréquentes
PdfCraft est-il un lecteur PDF gratuit et open source ?
Oui : double licence MIT ou Apache-2.0 au choix. Les noms et logos ArtCraft sont des marques exclues de cette licence, selon le README.
PdfCraft sait-il fusionner et scinder des PDF ?
Oui d’après le README : fusion, extraction et découpage, avec liens, champs de formulaire, calques et pièces jointes conservés.
PdfCraft gère-t-il les PDF protégés par mot de passe ?
Le README indique la prise en charge complète du gestionnaire de sécurité standard, du RC4 40 bits à AES-256, avec mots de passe utilisateur et propriétaire.
Conclusion
PdfCraft est déjà solide pour lire, organiser, fusionner et commenter, et honnête sur ce qui manque. Sources : le dépôt storytold/pdfcraft et getartcraft.com. Les captures viennent du dépôt, sous licence MIT ou Apache-2.0.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni à ArtCraft. Les marques citées appartiennent à leurs propriétaires. Les chiffres datent de la mi-octobre 2026 et évoluent vite : vérifiez-les sur le dépôt.