Beaucoup d’équipes SRE ont commencé avec Prometheus et Grafana, puis ont ajouté Loki pour les logs et Tempo pour les traces. Le jour où la plateforme grandit, la question arrive : Dynatrace vs Grafana, faut-il continuer à exploiter cette stack open source ou passer à une plateforme intégrée ?
La comparaison est piégeuse, car on ne compare pas deux produits du même type. D’un côté, quatre projets open source que vous assemblez, configurez et exploitez (ou que vous consommez via l’offre managée Grafana Cloud). De l’autre, une plateforme unique avec agent, stockage, analyse de causes et interface. Le vrai sujet n’est pas « lequel affiche les plus beaux graphiques », mais combien coûte, en temps d’équipe, chaque minute gagnée sur un incident.
Cet article donne une grille de comparaison factuelle et un POC OpenTelemetry qui alimente les deux mondes avec les mêmes traces, métriques et logs. Côté Dynatrace, le POC vise Dynatrace SaaS ; les points propres à Dynatrace Managed sont signalés. Côté Grafana, il vise la stack auto-hébergée.
Dynatrace vs Grafana : ce que l’on compare vraiment
| Critère | Dynatrace | Stack Grafana |
|---|---|---|
| Composants | Une plateforme : OneAgent, Dynatrace Operator, Grail (SaaS), interface et analyse de causes | Prometheus (métriques), Loki (logs), Tempo (traces), Grafana (visualisation et alertes) |
| Licence | Commerciale | Grafana, Loki et Tempo sous AGPLv3 ; Prometheus sous Apache 2.0 |
| Langages | DQL pour tous les signaux (SaaS) | PromQL (métriques), LogQL (logs), TraceQL (traces) |
| Corrélation | Topologie Smartscape et analyse causale (Dynatrace Intelligence en SaaS, Davis AI en Managed) | Liens entre sources de données configurés dans Grafana, labels communs |
| Hébergement | SaaS, ou Managed dans votre centre de données | Auto-hébergé, ou Grafana Cloud (managé) |
| Exploitation | Mises à jour de la plateforme par l’éditeur (SaaS) ou via la CMC (Managed) | Dimensionnement, stockage, rétention, haute disponibilité et mises à jour à votre charge (en auto-hébergé) |
Les SLO sont un cas particulier, déjà traité dans le comparatif des SLO Dynatrace, Grafana et Prometheus. Pour la même méthode appliquée à un éditeur SaaS, voir Dynatrace vs Datadog.
Prérequis du POC
- Un tenant Dynatrace SaaS d’essai et un token d’accès avec les scopes
openTelemetryTrace.ingest,metrics.ingestetlogs.ingest. - Prometheus, Loki, Tempo et Grafana déployés dans un cluster de test (charts Helm officiels ou manifestes de votre choix).
- Un OpenTelemetry Collector (distribution contrib), déployé comme dans notre guide du Collector sur Kubernetes.
- Une application de démonstration instrumentée en OpenTelemetry.
Étape 1 : ouvrir les points d’entrée OTLP de la stack Grafana
Les trois backends savent recevoir de l’OTLP, à condition de l’activer :
- Prometheus : le récepteur OTLP est désactivé par défaut. Démarrez Prometheus avec
--web.enable-otlp-receiver; il sert alors le chemin/api/v1/otlp/v1/metrics. - Loki : la documentation Loki indique d’exporter les logs vers
http://<loki-addr>/otlpavec l’exporteurotlphttp. - Tempo : activez le récepteur
otlpdans la sectiondistributor.receivers, avec les protocolesgrpc(4317 par défaut) ethttp(4318 par défaut).
prometheus --config.file=prometheus.yml --web.enable-otlp-receiverÉtape 2 : un Collector, deux destinations
Le Collector reçoit la télémétrie de l’application et la duplique : une copie vers Dynatrace, une copie vers chaque backend Grafana.
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317
      http:
        endpoint: 0.0.0.0:4318

processors:
  batch: {}

exporters:
  otlphttp/dynatrace:
    endpoint: https://${env:DT_ENV_ID}.live.dynatrace.com/api/v2/otlp
    headers:
      Authorization: "Api-Token ${env:DT_API_TOKEN}"
  otlphttp/prometheus:
    endpoint: http://prometheus.monitoring.svc:9090/api/v1/otlp
  otlphttp/loki:
    endpoint: http://loki.monitoring.svc:3100/otlp
  otlp/tempo:
    endpoint: tempo.monitoring.svc:4317
    tls:
      insecure: true

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlphttp/dynatrace, otlp/tempo]
    metrics:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlphttp/dynatrace, otlphttp/prometheus]
    logs:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlphttp/dynatrace, otlphttp/loki]
Lignes critiques :
otlphttp/prometheus: l’exporteur ajoute/v1/metricsà l’URL de base ; ne l’écrivez pas vous-même. Adaptez le nom de service et le port à votre déploiement.otlphttp/loki: l’adresse de Loki dépend de votre chart (mode monolithique ou distribué) ; vérifiez le service exposé.tls.insecure: acceptable pour un trafic interne au cluster de test, jamais vers l’extérieur.- En Managed, l’URL Dynatrace devient
https://{votre-domaine}/e/{id-environnement}/api/v2/otlp.
Un point mérite attention sur les métriques : Dynatrace attend des sommes OTLP en temporalité delta, alors que le modèle de Prometheus est cumulatif. Avec un seul flux, ajoutez le processeur cumulativetodelta dans un pipeline dédié à Dynatrace. Le sujet est détaillé dans la temporalité des métriques OTLP. Notez aussi que Tempo écoute par défaut sur localhost : configurez une adresse d’écoute joignable depuis le Collector. Si vous gardez Prometheus pour le scraping, l’intégration Prometheus de Dynatrace est une alternative.
Étape 3 : comparer le diagnostic et l’effort d’exploitation
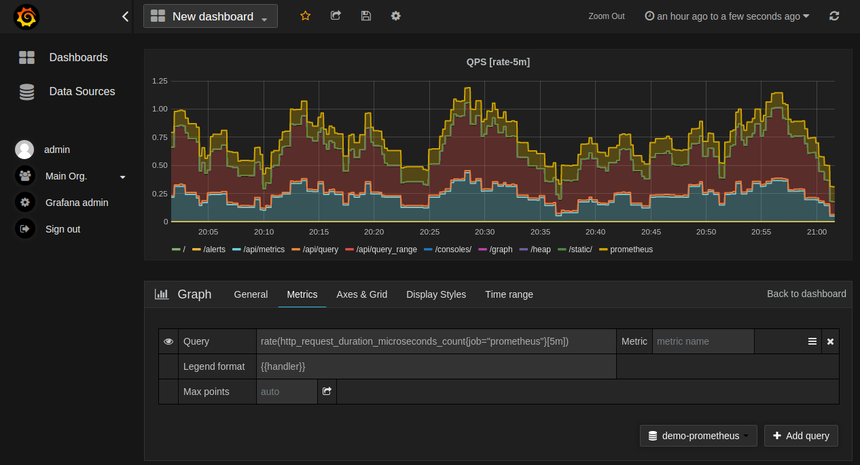
Dans Grafana, chaque panneau repose sur une requête écrite dans le langage de sa source, comme la requête PromQL ci-dessus. Dans Dynatrace SaaS, la même vue s’écrit en DQL :
fetch spans, from: now() - 1h
| filter service.name == "checkout"
| summarize p95 = percentile(duration, 95), appels = count(), by:{span.name}
Notez ensuite chaque plateforme sur ces critères, preuves à l’appui :
- Temps de diagnostic : trois pannes injectées, chronométrées par une personne qui ne connaît pas le scénario.
- Navigation entre signaux : passer d’une métrique dégradée à la trace, puis aux logs, sans copier d’identifiant à la main.
- Toil d’exploitation : heures par mois passées sur les mises à jour, le stockage, la rétention et les pannes de la stack d’observabilité elle-même.
- Couverture : ce qui remonte sans code (agent, auto-instrumentation) et ce qui exige une configuration par service.
- Compétences : trois langages (PromQL, LogQL, TraceQL) à maîtriser d’un côté, un seul (DQL) de l’autre.
Comment vérifier que ça fonctionne
- Dynatrace :
fetch spans, from: now() - 15m | filter service.name == "checkout" | summarize count()renvoie des spans. - Grafana : l’Explore de la source Tempo retrouve des traces du service ; la source Loki renvoie des logs ; une requête PromQL sur une métrique de l’application renvoie des séries.
- Collector :
kubectl logs deploy/otel-collector | grep -i errorne montre aucune erreur d’export.
Bonnes pratiques
- Chiffrez le temps d’exploitation de la stack open source : c’est un coût réel, même sans licence.
- Gardez OpenTelemetry comme couche d’instrumentation : vous pourrez changer de backend sans toucher au code.
- Comparez à périmètre égal : même échantillonnage (voir le tail sampling), même rétention.
- Impliquez l’astreinte : ce sont elles et eux qui vivront avec l’outil à trois heures du matin.
Questions fréquentes
La stack Grafana est-elle gratuite ?
Les logiciels sont open source, mais l’infrastructure, le stockage et le temps d’exploitation ne le sont pas. En auto-hébergé, vous payez en heures d’équipe ; avec Grafana Cloud, vous payez un service managé. Comparez ces coûts réels à une offre Dynatrace écrite.
Peut-on afficher des données Dynatrace dans Grafana ?
Le Collector permet d’envoyer les mêmes données aux deux, comme dans ce POC. C’est utile pendant une migration, mais maintenir deux sources de vérité finit par coûter cher.
Dynatrace Managed change-t-il la comparaison ?
Oui sur l’hébergement : Managed permet, comme la stack Grafana auto-hébergée, de garder les données chez vous. En revanche, DQL et Grail sont propres à Dynatrace SaaS ; Managed utilise le sélecteur de métriques et ses propres écrans.
Conclusion
Dynatrace vs Grafana oppose surtout deux modèles d’exploitation : assembler et opérer des briques open source, ou consommer une plateforme intégrée. Un POC alimenté par le même Collector, avec le toil mesuré au même titre que le temps de diagnostic, permet de trancher sur des chiffres plutôt que sur des préférences.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni à Grafana Labs. Dynatrace, Grafana, Loki, Tempo et Prometheus sont des marques de leurs propriétaires respectifs. Vérifiez les options dans la documentation officielle (Prometheus et OpenTelemetry, Loki et OpenTelemetry, API OTLP Dynatrace).