Un solo Collector muestrea sin problemas, pero en cuanto añades réplicas, las decisiones se vuelven incoherentes. El balanceo de carga por trace ID resuelve este punto: un primer nivel de Collectors reparte los spans según su traceID, de modo que todos los spans de una misma traza acaban en la misma instancia del segundo nivel, la que lleva el procesador tail_sampling.
Objetivo: montar esta arquitectura de dos niveles con el exportador load_balancing del repositorio OpenTelemetry Collector contrib, validarla y conocer sus límites (alta o baja de pods, pérdida de datos). El principio es independiente del backend: vale tanto para Dynatrace SaaS como para Dynatrace Managed, ya que todo ocurre en el Collector, antes de la exportación OTLP.
Este artículo complementa el tutorial sobre el tail sampling de OpenTelemetry, que detalla las políticas de muestreo. Aquí el énfasis está en el enrutamiento que las hace fiables.
Por qué el balanceo de carga por trace ID es necesario para el tail sampling
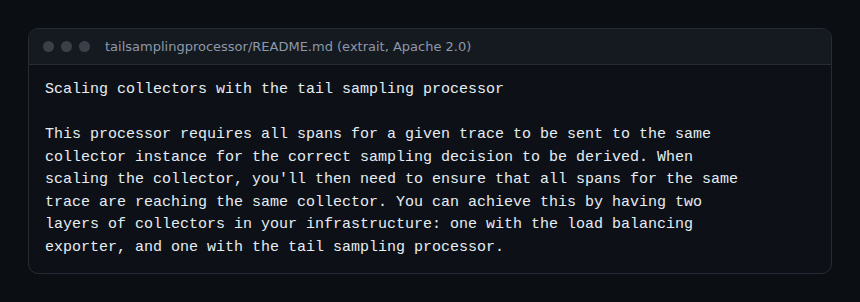
Según el README del procesador tail_sampling, todos los spans de una traza deben ser recibidos por la misma instancia del Collector para obtener una decisión correcta. El procesador guarda los spans en memoria, agrupados por trace_id, y luego evalúa sus políticas. Si dos réplicas se reparten los spans de una traza, cada una decide con una vista parcial: una conserva la parte con error, la otra descarta el resto. Resultado: trazas truncadas, sin span raíz, que el equipo de guardia no sabe aprovechar.
Un balanceador de carga de red clásico (round-robin en el puerto 4317) no resuelve nada: reparte conexiones o peticiones, no trazas. Hace falta un enrutamiento determinista sobre el identificador de traza. El README del exportador describe exactamente este caso de uso: un enrutamiento coherente que permite un procesamiento posterior con estado, entre ellos el tail sampling.
Cómo funciona el exportador load_balancing
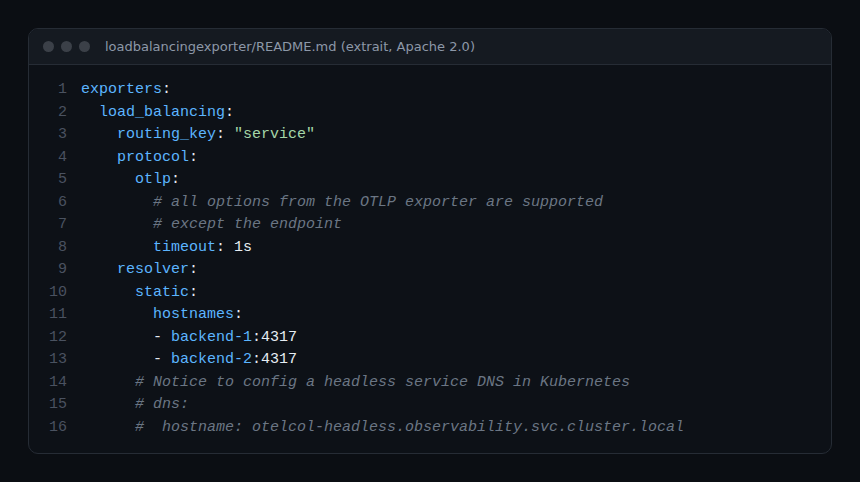
El exportador lee la clave de enrutamiento (routing_key) de cada lote, calcula a qué backend debe ir y crea un exportador OTLP por endpoint. Algunos hechos tomados de su README:
- Los valores posibles de
routing_keysonservice,traceID,metric,resource,streamID,attributesyrandomness. Para las trazas,traceIDes el valor por defecto; indicarlo sigue siendo una buena práctica de legibilidad. - La fuente de los backends es un resolvedor:
static(lista fija),dns(un nombre que resuelve a todas las direcciones, por ejemplo un servicio de Kubernetes headless),k8s(un servicio de Kubernetes) oaws_cloud_map. - La elección del backend depende solo del identificador, no de la carga real. El README anuncia un reparto cercano al equilibrio, con una desviación estándar inferior al 5 % en la configuración actual.
- Estabilidad declarada: beta para trazas y logs, alpha para métricas.
- El tipo de exportador se ha renombrado a
load_balancing; el nombre antiguoloadbalancingse sigue aceptando como alias obsoleto.
Este es el extracto del README que muestra la estructura de la configuración, con el resolvedor estático y, en comentario, el equivalente DNS para Kubernetes:
Puesta en marcha paso a paso
Paso 1: el primer nivel, que enruta por traceID
# collector-routing.yaml
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317
      http:
        endpoint: 0.0.0.0:4318

exporters:
  load_balancing:
    routing_key: traceID
    protocol:
      otlp:
        timeout: 1s
        tls:
          insecure: true
    resolver:
      dns:
        hostname: otel-sampler-headless.observability.svc.cluster.local
        port: 4317

service:
  pipelines:
    traces:
      receivers: [otlp]
      exporters: [load_balancing]
Líneas críticas: routing_key: traceID garantiza un mismo backend por traza; el resolvedor dns apunta a un servicio headless para que cada pod del segundo nivel aparezca como una dirección distinta. El resolvedor DNS vuelve a consultar el nombre periódicamente (5 s por defecto según el README). La opción tls.insecure: true sirve para una prueba; en producción, usa TLS entre los dos niveles.
Si prefieres el resolvedor k8s, el README indica que el pod del primer nivel debe usar una cuenta de servicio autorizada a leer (get, list, watch) los objetos EndpointSlice del namespace de destino; sin ello, la caché del resolvedor queda vacía y el exportador registra un error.
Paso 2: el segundo nivel, que muestrea
# collector-sampler.yaml
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317

processors:
  memory_limiter:
    check_interval: 1s
    limit_percentage: 80
    spike_limit_percentage: 20
  tail_sampling:
    decision_wait: 10s
    num_traces: 100000
    policies:
      - name: erreurs
        type: status_code
        status_code:
          status_codes: [ERROR]
      - name: lentes
        type: latency
        latency:
          threshold_ms: 1000
      - name: echantillon-normal
        type: probabilistic
        probabilistic:
          sampling_percentage: 5
  batch: {}

exporters:
  otlphttp/dynatrace:
    endpoint: "https://<environment-id>.live.dynatrace.com/api/v2/otlp"
    headers:
      Authorization: "Api-Token ${env:DT_API_TOKEN}"

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, tail_sampling, batch]
      exporters: [otlphttp/dynatrace]
Despliega este nivel como StatefulSet o Deployment, detrás del servicio headless citado en el paso 1, con al menos dos réplicas. El token de Dynatrace necesita el scope openTelemetryTrace.ingest; en Managed, el endpoint tiene la forma https://<votre-domaine>/e/<environment-id>/api/v2/otlp. Para el despliegue del Collector en Kubernetes, consulta el Collector de OpenTelemetry en Kubernetes.
¿Por qué dos niveles y no dos pipelines en la misma instancia? El README del procesador lo dice: es técnicamente posible, pero separar las capas da un mejor aislamiento de fallos. Describe la misma arquitectura, un nivel con el exportador de balanceo de carga y otro con el procesador de tail sampling:
Paso 3: ajustar la resiliencia
Por defecto, según el README, el exportador no intenta reenrutar los datos a un backend sano en caso de fallo: la cola de espera, los reintentos y el timeout están desactivados en el propio exportador. Existen dos niveles de ajuste:
- Bajo
protocol.otlp(opciones 2):timeout,retry_on_failureysending_queuepara incidentes puntuales en un backend, por ejemplo un corte de red breve. Activado por defecto. - Directamente en la sección
load_balancing(opciones 1): los mismos parámetros, útiles en un entorno elástico como Kubernetes, donde la lista de endpoints cambia en cada despliegue. Desactivado por defecto.
El README precisa también que sigue siendo posible perder datos si todos los destinos permanecen no disponibles una vez agotados los reintentos. Prevé por tanto colas dimensionadas y una alerta sobre los fallos de exportación.
Qué ocurre cuando cambia el número de pods
Cuando cambia la lista de backends, una parte de las rutas se reasigna: aproximadamente R/N, donde R es el número de rutas (aquí de trace IDs) y N el número de backends. Cuantos más backends, menor es la perturbación. Para una traza en curso durante un despliegue, sus spans pueden acabar en dos instancias y producir una traza incompleta. El README señala que los resolvedores dns y k8s reflejan los cambios con retraso, siendo el resolvedor k8s más rápido que dns.
Consecuencias para un equipo de plataforma:
- Evita reiniciar todo el segundo nivel de golpe: procede con un despliegue progresivo y vigila la tasa de trazas sin raíz.
- Si la lista de backends cambia constantemente y la estabilidad importa, el README sugiere considerar el procesador
groupbytraceaguas arriba, que envía las trazas de forma atómica al exportador. - Prevé un
decision_waitsuperior a la duración de tus trazas largas. Las decisiones ya tomadas pueden conservarse en las cachés de decisión (decision_cache), desactivadas por defecto.
Cómo comprobar que funciona
- Una prueba local: el README del exportador propone una configuración en la que el balanceador y cuatro backends se ejecutan en la máquina, y cada backend exporta al exportador
debug. Envía trazas con varios spans y comprueba que cadatraceIDaparece en un solo backend. - Los logs del primer nivel: un error del tipo couldn’t find the exporter for the endpoint señala, según el README, un resolvedor
k8ssin permisos RBAC. - Las métricas internas del Collector: sigue, en el segundo nivel, los contadores del procesador de tail sampling. Los nombres exactos varían según la versión; lístalos en el endpoint de telemetría interna en lugar de copiarlos de un tutorial.
- Dynatrace SaaS: busca trazas sin span raíz, señal de spans dispersos o de un
decision_waitdemasiado corto:fetch spans, from: now() - 1h | summarize spans = count(), racines = countIf(isNull(span.parent_id)), by: {trace.id} | filter racines == 0 | limit 20 - Dynatrace Managed: en la vista de trazas distribuidas, filtra por las peticiones fallidas y comprueba que las trazas no estén truncadas (las consultas DQL no se aplican a Managed).
Para correlacionar logs y trazas tras el muestreo, consulta los logs de OpenTelemetry y el trace ID. El enrutamiento por traceID vale también para los logs: el README precisa que los logs sin identificador de traza se reparten al azar.
Buenas prácticas
- Separa los dos niveles: el primero no tiene estado, el segundo guarda las trazas en memoria.
- Usa un servicio headless y un resolvedor
dnsok8sen lugar de una lista estática, que expone a pérdidas si un backend cae. - Dimensiona la memoria del segundo nivel según el caudal,
decision_waitynum_traces, y colocamemory_limiteren primer lugar. - Calcula las métricas RED antes del muestreo, en el primer nivel; con un enrutamiento por
traceID, cada Collector ve todas las combinaciones de servicio y operación, lo que puede crear colisiones de labels (el README aconseja el enrutamiento porservicepara este caso). - Trata una traza truncada como un defecto de configuración, nunca como culpa de un equipo.
Preguntas frecuentes
¿Hace falta balanceo de carga por trace ID con un solo Collector?
No. Con una sola instancia que recibe todos los spans, el procesador ve cada traza completa. El enrutamiento pasa a ser obligatorio en cuanto varias réplicas muestrean.
¿Qué diferencia hay entre routing_key traceID y service?
Con traceID, todos los spans de una traza van al mismo backend, lo que exige el tail sampling. Con service, todos los spans de un servicio van al mismo backend, lo que conviene a las métricas calculadas por servicio.
¿Basta un balanceador de carga ordinario de Kubernetes?
No: un Service clásico reparte las conexiones, sin relación con el traceID. Hace falta el exportador load_balancing y un servicio headless para que cada pod sea direccionable individualmente.
Conclusión
El tail sampling solo es fiable a escala si cada traza llega entera a una única instancia. El exportador load_balancing con routing_key: traceID es la condición, a costa de un nivel adicional de Collectors y de algunas precauciones durante los despliegues. Para continuar, consulta la propagación de contexto con Kafka, que evita otras trazas cortadas aguas arriba. Referencias: el README del exportador load_balancing y el del procesador tail_sampling.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a los proyectos citados. Dynatrace es una marca de Dynatrace LLC. Las marcas citadas pertenecen a sus propietarios. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.