vLLM inférence LLM : le dépôt vllm-project/vllm est une bibliothèque Python et un serveur pour faire tourner des modèles de langage sur vos propres GPU, avec une API compatible OpenAI. Il affichait environ 95 100 étoiles en octobre 2026, sous licence Apache-2.0. Le README le résume en « Easy, fast, and cheap LLM serving for everyone ».
Pour une équipe d’exploitation, la question n’est pas seulement de le lancer, mais de savoir ce qu’il se passe quand dix utilisateurs arrivent en même temps : combien de requêtes attendent, à quelle vitesse sort le premier token, où le cache mémoire sature. Cet article présente le projet, l’installation d’après la documentation, et surtout les signaux à surveiller. Pour le déploiement de base et un premier tableau de bord, voir notre article sur vLLM en production : ici, l’angle est le fonctionnement interne et la lecture des métriques de service.
Les informations viennent du README et de la documentation officielle du projet. span.observer n’a pas installé vLLM : les schémas ci-dessous viennent de la documentation du projet.
vLLM inférence LLM : ce que dit le dépôt
- Origine : d’après le README, vLLM a été développé à l’origine au Sky Computing Lab de l’université de Californie à Berkeley, et il est aujourd’hui maintenu par une communauté de « plusieurs dizaines d’institutions académiques et d’entreprises », avec plus de 2 000 contributeurs.
- Licence : Apache-2.0 (fichier LICENSE du dépôt).
- Version : 0.32.0 sur PyPI, publiée le 18 octobre 2026.
- Techniques mises en avant : gestion de la mémoire clé-valeur par PagedAttention, traitement continu des requêtes (continuous batching), prefill par morceaux, cache de préfixes, nombreuses quantifications (FP8, INT8, INT4, GPTQ, AWQ, GGUF…), décodage spéculatif, parallélisme tensoriel, pipeline, données, experts et contexte.
- Interfaces : serveur compatible OpenAI, avec en plus l’API Anthropic Messages et gRPC selon le README.
- Matériel : GPU NVIDIA, AMD et Intel, processeurs x86, ARM et PowerPC, plus des plugins matériels (TPU, Gaudi, Ascend, Apple Silicon…).
Le README annonce un « débit de service à l’état de l’art » : c’est une affirmation du projet, que nous ne chiffrons pas. Mesurez sur votre matériel et vos modèles.
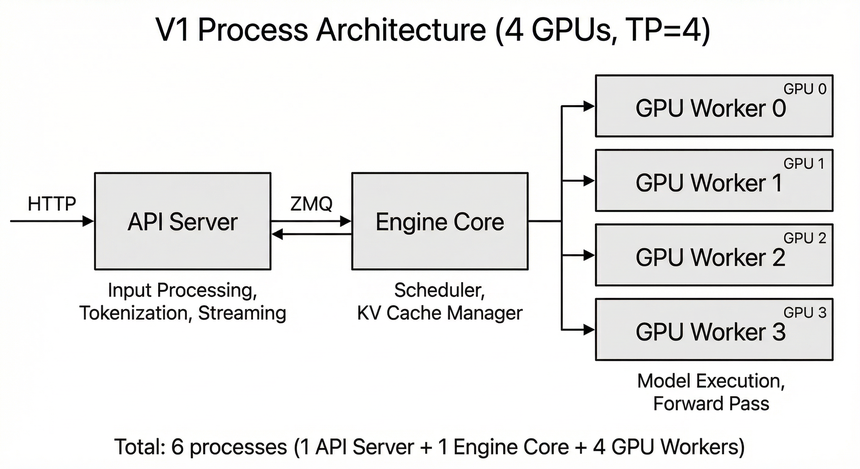
La documentation d’architecture décrit ainsi la version V1 : un serveur d’API (traitement des entrées, tokenisation, flux de sortie), un cœur de moteur (planificateur et gestionnaire de cache KV) relié par ZMQ, et un processus de travail par GPU. Pour superviser, c’est utile : une file qui s’allonge vient du planificateur, pas du modèle.
Installer vLLM d’après la documentation
Étape 1 — Prérequis
Le guide de démarrage indique : système Linux, Python 3.11 à 3.14. Sur Mac avec puce Apple, le même guide renvoie vers le projet distinct vLLM-Metal. Les pages consultées ne décrivent pas d’installation native sous Windows.
Étape 2 — Installer
uv venv --python 3.12 --seed
source .venv/bin/activate
uv pip install vllm --torch-backend=auto
vllm download-kernels
Le README donne la forme courte uv pip install vllm suivie de vllm download-kernels : cette commande installe des noyaux précompilés qui, sinon, sont téléchargés et compilés au démarrage, ce qui peut ajouter plusieurs minutes sur les GPU Hopper et plus récents. Les variantes AMD ROCm, Intel, TPU et Ascend ont leurs propres instructions dans la documentation.
Étape 3 — Lancer le serveur
vllm serve Qwen/Qwen2.5-1.5B-InstructPar défaut, le serveur écoute sur http://localhost:8000 (options --host et --port) et héberge un seul modèle à la fois, selon le guide.
Superviser vLLM : les métriques de service
Le serveur expose des métriques au format Prometheus sur le point /metrics. La documentation montre la requête :
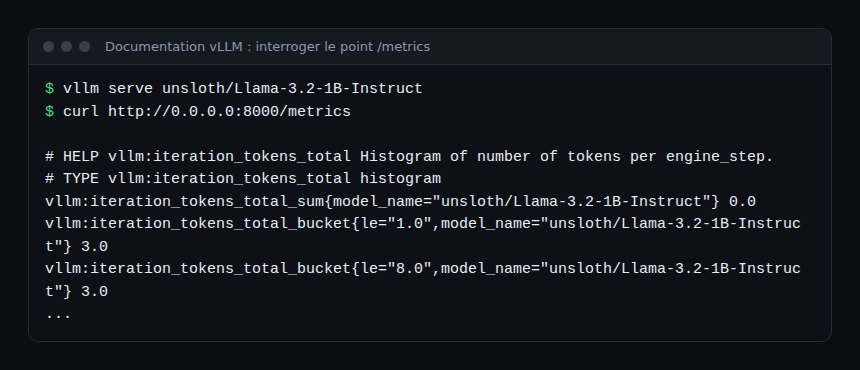
Les noms ci-dessous figurent dans la page « Production Metrics » de la documentation en développement ; vérifiez-les contre la version que vous déployez, car le projet applique une politique de dépréciation (une métrique dépréciée en X.Y est masquée en X.Y+1, supprimée en X.Y+2).
- File et charge :
vllm:num_requests_runningetvllm:num_requests_waiting. - Mémoire :
vllm:kv_cache_usage_perc(occupation du cache clé-valeur) etvllm:num_preemptions. - Latence :
vllm:time_to_first_token_seconds,vllm:inter_token_latency_seconds,vllm:e2e_request_latency_seconds, ainsi que les temps de file, de prefill et de décodage par requête. - Volume :
vllm:prompt_tokens,vllm:generation_tokensetvllm:request_success.
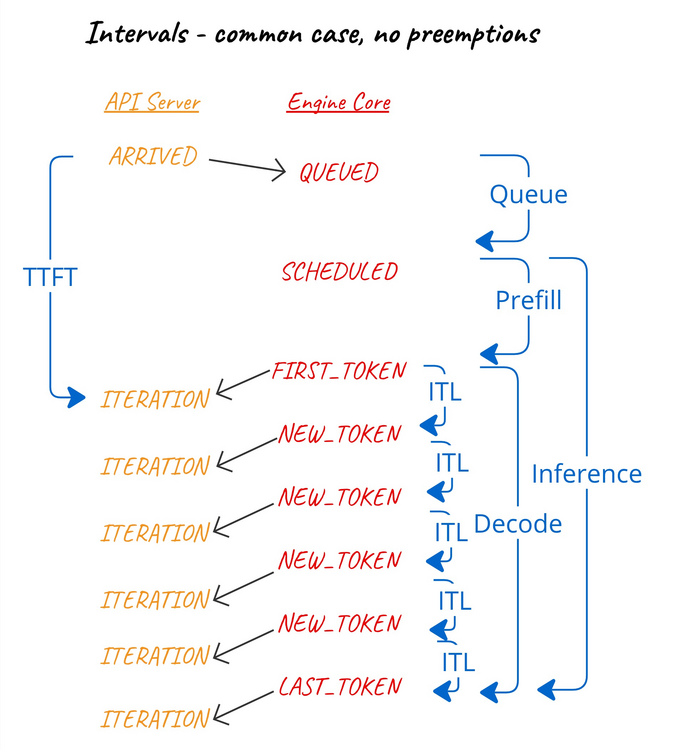
Le schéma de conception du projet aide à lire ces histogrammes : le TTFT (temps jusqu’au premier token) couvre l’attente en file puis le prefill ; l’ITL (délai entre tokens) mesure le rythme du décodage. Un TTFT qui monte avec une file qui grandit signale une saturation ; un ITL qui monte avec un cache KV plein signale de la pression mémoire.
Ajuster les buckets d’un SLO
La documentation précise que le plus petit seuil par défaut des histogrammes de phases de requête est 0,3 s. Pour suivre un objectif de latence plus bas, l’option --custom-histogram-buckets remplace les seuils d’une famille :
vllm serve Qwen/Qwen3-0.6B \
    --custom-histogram-buckets '{"request_latency": [0.01, 0.05, 0.1, 0.25, 0.5, 1.0, 5.0, 30.0]}'
Chaque seuil ajoute une série temporelle par métrique et par combinaison d’étiquettes : gardez des listes courtes. La documentation signale aussi l’option --enable-mfu-metrics pour des métriques d’utilisation des flops du modèle.
Traces OpenTelemetry
Ne confondez pas métriques et traces. vLLM prend en charge le traçage OpenTelemetry via --otlp-traces-endpoint et --collect-detailed-traces. L’exemple de la documentation utilise Jaeger, OTEL_SERVICE_NAME et OTEL_EXPORTER_OTLP_TRACES_ENDPOINT ; le protocole par défaut est gRPC, et OTEL_EXPORTER_OTLP_TRACES_PROTOCOL=http/protobuf bascule en HTTP. Un Collector placé devant permet ensuite de router vers votre outil ; voir le Collector OpenTelemetry vers Dynatrace.
Comment vérifier que ça fonctionne
curl http://localhost:8000/metricsrenvoie des lignesvllm:….- Envoyez quelques requêtes à l’API, puis constatez que
vllm:request_successet les compteurs de tokens augmentent. - Avec le traçage activé, chaque requête produit une trace visible dans votre backend sous le nom de service choisi.
Limites et points ouverts
- Matériel : le projet vise surtout des GPU ; pour un poste sans GPU, des outils comme llama.cpp ou Ollama sont plus simples.
- Statistiques d’usage : la documentation indique que vLLM collecte par défaut des données d’usage anonymes (matériel, architecture du modèle, configuration). Désactivation :
VLLM_NO_USAGE_STATS=1ouDO_NOT_TRACK=1, ou un fichier~/.config/vllm/do_not_track. Décidez-en avant la mise en production. - Un modèle par serveur ; les noms de métriques peuvent changer d’une version à l’autre (politique de dépréciation du projet).
- Cardinalité : buckets et parallélisme de données multiplient les séries Prometheus.
Bonnes pratiques
- Fixez la version de vLLM et relisez les notes de version avant chaque mise à jour.
- Alertez sur la file d’attente et le TTFT plutôt que sur le seul débit.
- Surveillez l’occupation du cache KV et les préemptions avant d’ajouter des GPU.
- Gardez des listes de buckets courtes et alignées sur vos SLO.
- Ne placez pas le port 8000 sur Internet sans authentification ni proxy.
Questions fréquentes
vLLM est-il gratuit ?
Le code est sous licence Apache-2.0. Le matériel GPU et l’exploitation restent à votre charge.
vLLM remplace-t-il Ollama ?
Ce sont deux approches : vLLM cible le service multi-utilisateurs sur serveur, Ollama le confort sur poste local. Voir la pile IA open source auto-hébergée.
Où trouver la liste exacte des métriques ?
Dans la page « Production Metrics » de la documentation, ou directement sur le point /metrics de la version que vous exécutez.
Conclusion
vLLM est un moteur d’inférence très actif, qui expose de quoi mesurer file, mémoire et latences. Installez-le d’après la documentation, activez les métriques dès le premier jour, ajoutez les traces si vous en avez besoin, et décidez de la collecte d’usage avant de passer en production.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni aux projets cités. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans leur documentation officielle (docs.vllm.ai).