
Votre Jaeger v1 tourne depuis des années, et la question revient à chaque revue d’architecture : faut-il migrer Jaeger v2 maintenant, ou attendre ? La réponse tient moins à une date qu’à ce que vous exploitez aujourd’hui : combien de binaires, quels flags, quelle chaîne de collecte devant le stockage.
Ce guide part de cette décision d’exploitation. Les faits viennent de la documentation de jaegertracing.io (version 2.23 affichée comme dernière) et du dépôt jaegertracing/jaeger, lus le 11 novembre 2026. Je n’ai pas migré de production pour cet article : les extraits de configuration sont ceux du dépôt, pas un test de span.observer.
Pour situer le Collector lui-même, voir les composants du Collector Contrib ; pour surveiller le vôtre, la supervision du Collector.
Pourquoi migrer Jaeger v2 : ce qui change vraiment
La documentation date la sortie de Jaeger v2 de novembre 2024 et la décrit comme bâtie sur le framework du Collector OpenTelemetry. Page d’architecture : Jaeger est « une distribution personnalisée du Collector OpenTelemetry avec différents rôles ». Un seul binaire, jaeger, remplit ces rôles selon sa configuration.
- Collector : reçoit les traces des applications et les écrit dans un stockage.
- Ingester : lit les spans dans Kafka et les écrit dans un stockage.
- Query : sert l’interface et l’API de lecture.
- Agent : la documentation recommande désormais d’utiliser à la place le Collector OpenTelemetry standard.
Autrement dit, ce qui se réglait par flags en v1 devient un fichier YAML au format du Collector. Le README du dépôt (Apache 2.0, environ 23 400 étoiles affichées à la date de lecture) annonce « Jaeger v2 is out ».
La question de la fin de vie de la v1
Honnêteté sur ce point : je n’ai trouvé aucune date de fin de vie de la v1 dans les pages d’architecture, de déploiement et de migration, ni dans le README. La page de migration se limite à renvoyer vers un document Google partagé, que je n’ai pas pu exploiter ici. Les pages de documentation ne listent plus que des versions 2.x.
Ne décidez donc pas sur une date supposée. Cherchez la politique de support dans les notes de version du dépôt avant de fixer votre calendrier, et gardez en tête que chaque mois passé sur la v1 est un mois sans les correctifs de la branche principale.
Cartographier votre v1 avant de toucher à rien
Une migration réussie commence par un inventaire, pas par un fichier YAML. Notez pour chaque composant v1 :
- quel stockage il utilise (mémoire, Elasticsearch, Cassandra, Kafka en tampon) ;
- quels protocoles les applications lui envoient (OTLP, Jaeger gRPC ou Thrift, Zipkin) ;
- quelle stratégie d’échantillonnage il sert aux SDK ;
- quels flags personnalisés vivent dans vos manifestes ou vos charts.
Cet inventaire dit surtout où le risque se cache : un service resté sur un protocole ancien, ou une stratégie d’échantillonnage servie à distance et oubliée.
Lire le fichier de configuration v2
Le fichier se lance avec jaeger --config config.yaml. Il suit la structure du Collector : un bloc service relie des composants définis plus bas. L’exemple du dépôt le montre bien.
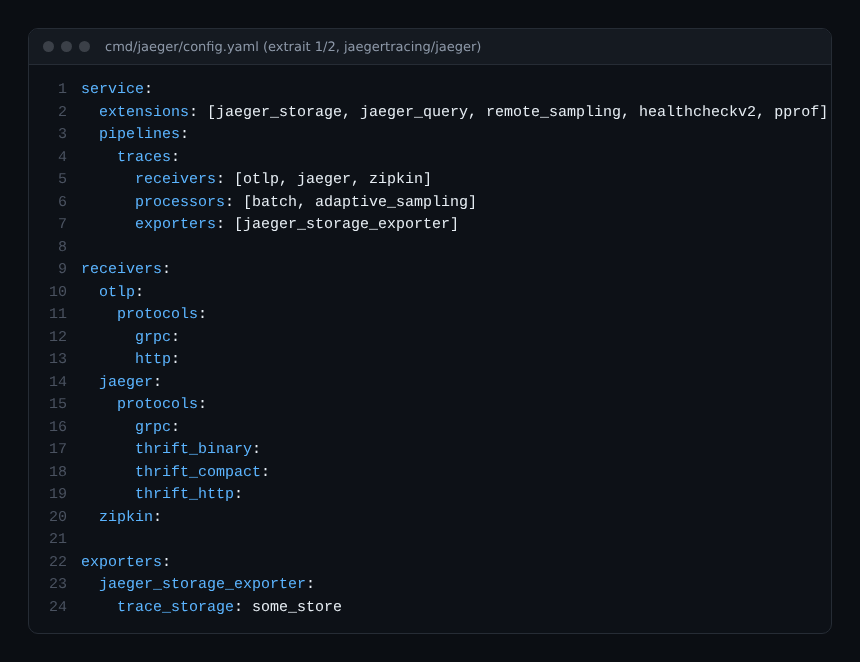
Trois choses à retenir :
- le pipeline
tracesa des récepteurs (OTLP, protocoles Jaeger, Zipkin), des processeurs et un exporteur ; - l’exporteur
jaeger_storage_exporterécrit vers un stockage nommé, icisome_store; - la liste
extensionsactive les fonctions propres à Jaeger : stockage, requêtes, échantillonnage distant.
La seconde moitié du fichier définit ces extensions.
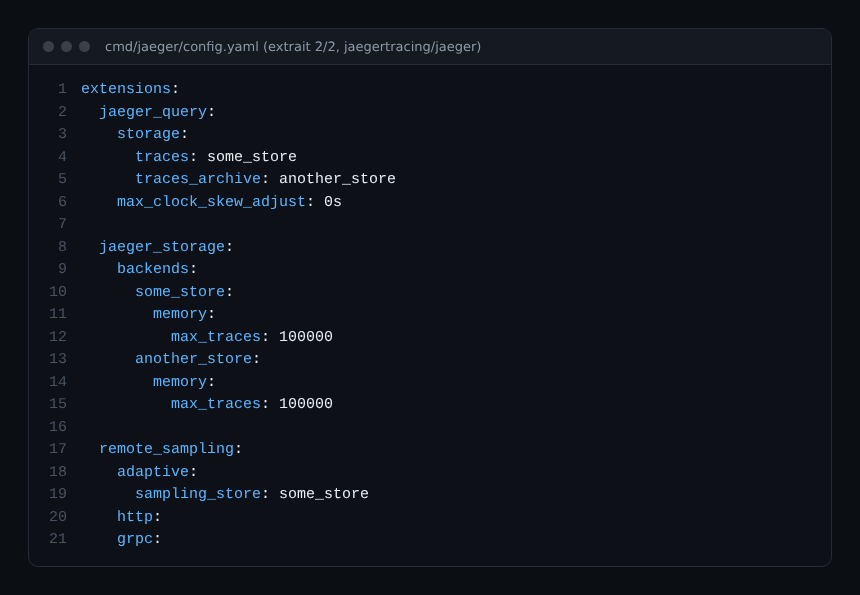
L’extension jaeger_storage déclare les backends une seule fois, sous un nom. jaeger_query et l’exporteur y font référence par ce nom. C’est un changement de logique utile : changer de stockage revient à modifier une entrée, pas plusieurs flags dispersés. Le backend memory de l’exemple sert à tester, pas à la production.
Étapes d’une migration prudente
- Démarrer en parallèle. Lancez un Jaeger v2 à côté de la v1, avec un stockage de test, et envoyez-lui une copie du trafic.
- Traduire la configuration. Reprenez votre inventaire : un récepteur par protocole utilisé, un backend nommé par stockage.
- Vérifier les données. Comparez des traces connues entre les deux instances dans l’interface.
- Basculer les écritures, puis les lectures.
- Éteindre la v1 une fois la fenêtre de rétention écoulée.
Pour une mise à jour entre versions 2.x, la documentation indique l’ordre : d’abord query, puis l’ingester si Kafka est utilisé, puis le collector. Ce n’est pas écrit pour la migration v1 vers v2, mais le principe (lecture avant écriture) est un bon réflexe.
Le piège de la file d’attente de l’exporteur
La documentation signale un point fin : si la file de l’exporteur acquitte les spans dès leur mise en file, une panne du stockage peut faire perdre des données. Pour l’éviter, elle indique de régler wait_for_result: true et de ne pas utiliser le processeur batch. Le même exporteur peut aussi servir de connecteur et renvoyer les spans définitivement refusés vers un autre pipeline, qui joue le rôle de boîte de rebut. À relire avant la mise en production, surtout si votre SLO porte sur la complétude des traces.
Bonnes pratiques
- Versionnez le YAML et relisez-le en revue comme du code.
- Ne gardez des récepteurs que pour les protocoles réellement utilisés : chaque port ouvert est une surface en plus.
- Mesurez avant et après : latence d’écriture, spans rejetés, durée d’une requête type.
- Si vous échantillonnez, voyez aussi les règles de tail sampling pour ne pas perdre les traces utiles.
- Gardez la v1 en lecture seule jusqu’à la fin de la rétention.
Questions fréquentes
Faut-il un Collector OpenTelemetry devant Jaeger v2 ?
Non. La documentation précise qu’il n’est pas nécessaire de l’utiliser pour exploiter Jaeger. Elle indique qu’une équipe qui en a déjà un peut le placer devant Jaeger pour d’autres types de télémétrie.
Mes applications doivent-elles changer ?
Le fichier d’exemple garde des récepteurs Jaeger et Zipkin à côté d’OTLP : les clients existants peuvent donc continuer à écrire. Vérifiez-le dans votre propre configuration.
Et avec Dynatrace ?
Cet article ne traite que de Jaeger. Pour envoyer des traces OpenTelemetry à Dynatrace, voir le Collector OpenTelemetry avec Dynatrace ; la documentation Dynatrace distingue SaaS et Managed, ce que je ne détaille pas ici.
Conclusion
Migrer vers Jaeger v2, c’est accepter un fichier YAML de Collector à la place de flags : un gain de lisibilité, au prix d’un inventaire sérieux. Commencez en parallèle, vérifiez les traces, puis basculez. Sources : documentation Jaeger et dépôt jaegertracing/jaeger.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni au projet Jaeger. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans la documentation officielle.