
La cardinalité des métriques ne se voit pas dans un tableau de bord : elle se voit sur la facture du mois suivant, ou dans la mémoire d’un Prometheus qui redémarre en boucle. Ce guide part d’une décision d’exploitation très concrète : avant qu’une équipe déploie une nouvelle métrique, que vérifier, et comment repérer une série qui explose quand elle est déjà en production ?
La méthode tient en quatre gestes : chiffrer une métrique avant de la livrer, auditer un bloc de données avec promtool, alerter sur le rythme de création de séries, puis plafonner à la source dans le SDK OpenTelemetry. Elle complète le guide sur la cardinalité des métriques Kubernetes, centré sur l’API TSDB et kube-state-metrics, et ne le répète pas.
En bref
- Le nombre de séries d’une métrique est au plus le produit du nombre de valeurs de chaque label : on le calcule avant la mise en production.
promtool tsdb analyzeaudite un bloc hors ligne et classe les labels les plus gourmands.scrape_series_addedpermet d’alerter sur les séries nouvelles, etpromtool test rulesteste l’alerte sans serveur.- Le SDK OpenTelemetry sait filtrer les attributs (
attribute_keys) et plafonner les points, avec un point de débordement.
Chiffrer la cardinalité des métriques avant la revue de code
La documentation Prometheus sur les bonnes pratiques d’instrumentation conseille de garder la cardinalité d’une métrique sous 10 et, au-delà, de la limiter à une poignée de métriques dans tout le système. Elle propose de chercher une autre solution quand une métrique dépasse 100. Ce sont des repères, pas des interdits, mais ils donnent un ordre de grandeur utile en revue.
Le calcul est simple. Une métrique avec les labels route (4 valeurs), status (3 valeurs) et user_id (1 000 valeurs) peut atteindre 4 × 3 × 1 000 = 12 000 séries. Le troisième label fait tout le coût. Posez donc une question dans le modèle de pull request : quelles sont les valeurs possibles de chaque label, et qui en borne le nombre ?
La page de nommage de Prometheus est explicite : ne stockez pas dans des labels des dimensions à forte cardinalité, comme des identifiants d’utilisateur ou des adresses e-mail. Un identifiant se met dans une trace ou un log, pas dans une métrique.
Auditer un bloc avec promtool tsdb analyze
L’API de statut de la TSDB interroge le serveur en marche. L’outil promtool offre l’autre option : analyser un répertoire de données, par exemple une copie d’un bloc récupéré sur un serveur ou un instantané, sans charger la production. La commande s’appelle tsdb analyze et sa description officielle est « Analyze churn, label pair cardinality and compaction efficiency ».
Pour que l’exemple soit reproductible, j’ai fabriqué un jeu de données de laboratoire : une métrique http_requests_total avec 12 séries légitimes (4 routes, 3 statuts) et 400 séries portant en plus un label user_id. Le fichier OpenMetrics est converti en blocs, puis analysé.
promtool tsdb create-blocks-from openmetrics m.om ./db
promtool tsdb analyze ./db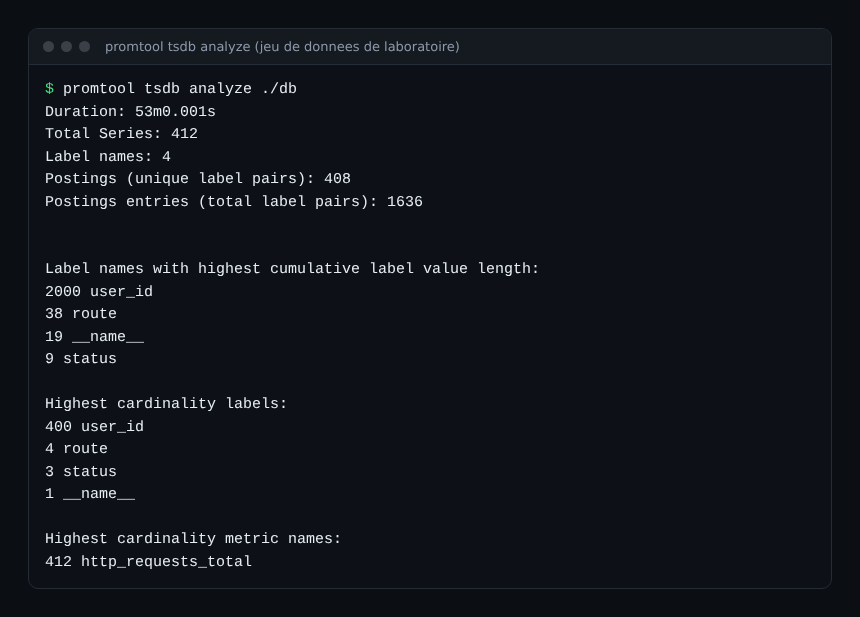
La lecture se fait de bas en haut. « Highest cardinality metric names » désigne la métrique coupable, « Highest cardinality labels » le label (ici user_id, 400 valeurs contre 4 pour route), et « Label names with highest cumulative label value length » indique où part la mémoire, car la longueur des valeurs compte. La même sortie contient aussi « Label pairs most involved in churning », utile pour repérer des valeurs qui naissent et meurent sans cesse. Dans mon jeu, tout vaut 0 : les données sont stables, ce qui n’est pas le cas d’un cluster qui redéploie.
Repérer les séries qui explosent avec scrape_series_added
Un audit ponctuel ne suffit pas : l’explosion arrive après un déploiement, un jeudi à 17 h. Prometheus génère pour chaque scrape des séries de diagnostic. D’après la documentation « Jobs and instances », scrape_series_added est le nombre approximatif de nouvelles séries dans ce scrape, scrape_samples_scraped le nombre d’échantillons exposés par la cible, et scrape_samples_post_metric_relabeling ceux qui restent après le relabeling.
Un job sain crée peu de nouvelles séries à chaque scrape, hormis lors des redéploiements. Une alerte sur ce signal prévient avant que la mémoire ne sature :
groups:
  - name: cardinalite
    rules:
      - alert: SeriesNouvellesParScrape
        expr: scrape_series_added > 500
        for: 10m
        labels:
          severity: warning
Le seuil de 500 est un exemple : mesurez le niveau normal de vos jobs avant de le fixer. Testez ensuite la règle sans serveur avec un fichier de test qui injecte des valeurs :
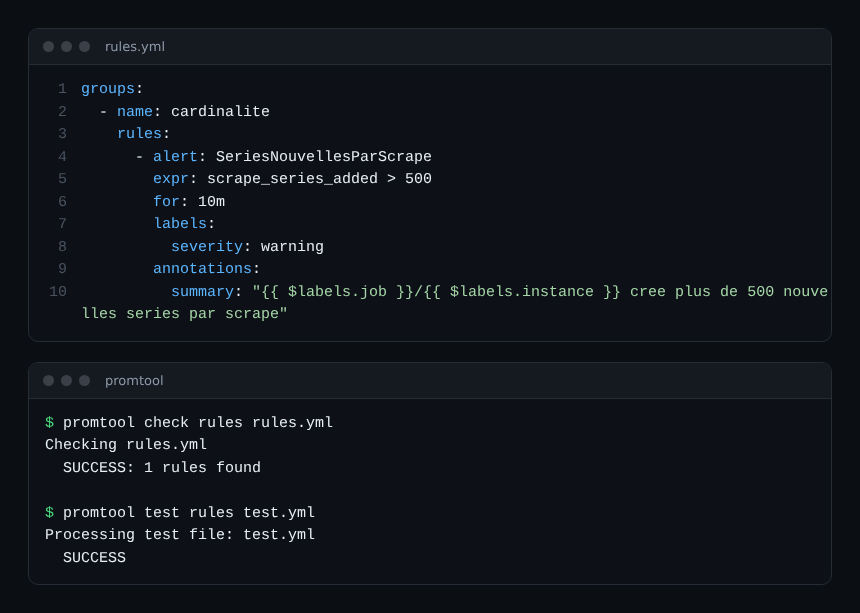
Le test injecte la série scrape_series_added à 10 pendant cinq minutes, puis à 900, et vérifie que l’alerte est bien active au bout de 30 minutes. Une alerte qui n’a jamais été testée est un pari, surtout avec une clause for.
Plafonner la cardinalité des métriques à la source avec OpenTelemetry
Corriger dans Prometheus, c’est réagir. Le SDK OpenTelemetry permet de décider avant l’export. La spécification du SDK de métriques définit une limite de cardinalité d’agrégation : à défaut d’autre valeur, 2 000 est utilisé. Au-delà, les mesures vont dans un jeu de débordement portant l’attribut booléen otel.metric.overflow à true. Une View peut aussi fixer aggregation_cardinality_limit pour un instrument, ou filtrer les attributs avec attribute_keys. Selon la spécification, la limite s’applique après le filtrage : filtrer d’abord évite d’atteindre le plafond.
J’ai vérifié le comportement avec le SDK Python (opentelemetry-sdk 1.45.2) : un compteur reçoit 3 000 mesures, chacune avec un attribut user.id différent.
View(instrument_name="app.requests", attribute_keys={"http.route"})
View(instrument_name="app.requests", aggregation_cardinality_limit=100)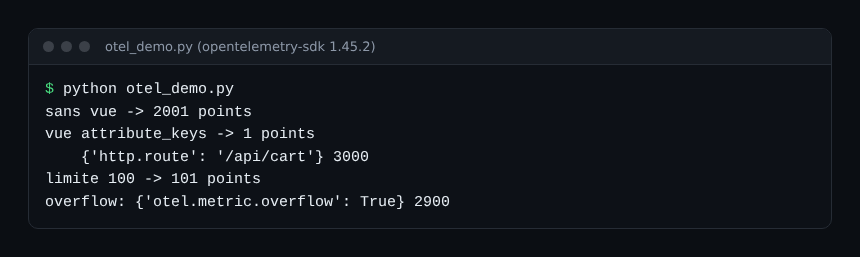
Sans vue, on obtient 2 001 points : la limite par défaut de 2 000 plus le point de débordement. Avec attribute_keys, un seul point reste, avec toutes les mesures cumulées (3 000). Avec une limite de 100, on obtient 101 points et le débordement cumule les 2 900 mesures restantes. Le débordement ne perd donc pas le total, il perd le détail. Le plafond limite la casse, mais seule la suppression de l’attribut règle le problème. Je n’ai pas vérifié ces options dans les autres langages : leur disponibilité varie selon le SDK.
Pour situer les deux écosystèmes l’un par rapport à l’autre, voir OpenTelemetry et Prometheus, deux outils complémentaires.
Bonnes pratiques : un garde-fou de revue en cinq lignes
- Lister les valeurs possibles de chaque label dans la pull request et multiplier.
- Refuser tout identifiant (utilisateur, requête, session) comme label ou attribut de métrique.
- Poser
sample_limitsur les jobs, en sachant que le dépassement fait échouer tout le scrape. - Alerter sur
scrape_series_addedet tester la règle avecpromtool test rules. - Rejouer
promtool tsdb analyzechaque trimestre sur un bloc récent.
Le même raisonnement s’applique aux logs : l’article sur les labels et la cardinalité dans Loki décrit l’équivalent côté index de logs, et celui sur les métriques custom Datadog montre comment la facturation se calcule chez un éditeur. Côté exploitation, la alerte sur les nœuds, pods et quotas reste une affaire distincte.
Sources : bonnes pratiques d’instrumentation Prometheus, spécification du SDK de métriques OpenTelemetry.
Questions fréquentes
Quelle est la cardinalité acceptable pour une métrique ?
La documentation Prometheus donne des repères : sous 10 valeurs par métrique, quelques métriques seulement au-dessus, et une réflexion sur les dimensions au-delà de 100. Le bon seuil dépend de votre budget de séries, qu’il faut mesurer.
Que se passe-t-il quand la limite du SDK OpenTelemetry est atteinte ?
Les nouvelles combinaisons d’attributs sont agrégées dans un point unique portant otel.metric.overflow=true. Le total reste exact, mais le détail par attribut est perdu pour ces mesures.
Faut-il utiliser sample_limit pour se protéger ?
C’est un filet de sécurité utile, mais radical : d’après la documentation, si le nombre d’échantillons après relabeling dépasse la limite, le scrape entier est considéré en échec. Mieux vaut le combiner avec l’alerte sur les nouvelles séries.
Conclusion
Maîtriser la cardinalité des métriques revient à déplacer le contrôle plus tôt : chiffrer en revue, auditer avec promtool, alerter sur le rythme de création, plafonner dans le SDK. Les sorties présentées viennent d’un jeu de laboratoire, pas d’un environnement de production : refaites les mesures sur vos données avant de fixer vos seuils.
span.observer est un blog indépendant, non affilié à Dynatrace LLC. Les noms de produits cités appartiennent à leurs propriétaires respectifs ; les configurations sont des exemples à adapter et à tester avant tout usage en production.