
Tu Jaeger v1 lleva años en marcha y la pregunta reaparece en cada revisión de arquitectura: ¿toca migrar a Jaeger v2 ya, o esperamos? La respuesta depende menos de una fecha que de lo que operas hoy: cuántos binarios, qué flags, qué cadena de recolección delante del almacenamiento.
Esta guía parte de esa decisión operativa. Los datos salen de la documentación de jaegertracing.io (la versión 2.23 aparece como la última) y del repositorio jaegertracing/jaeger, consultados el 11 de noviembre de 2026. No he migrado ninguna producción para escribirla: los fragmentos de configuración son los del repositorio, no una prueba de span.observer.
Para situar el Collector en sí, mira los componentes del Collector Contrib; para vigilar el tuyo, la supervisión del Collector.
Por qué migrar a Jaeger v2: qué cambia de verdad
La documentación sitúa el lanzamiento de Jaeger v2 en noviembre de 2024 y lo describe como construido sobre el framework del Collector de OpenTelemetry. En la página de arquitectura, Jaeger es «una distribución personalizada del Collector de OpenTelemetry con distintos roles». Un único binario, jaeger, cumple esos roles según su configuración.
- Collector: recibe las trazas de las aplicaciones y las escribe en un almacenamiento.
- Ingester: lee los spans de Kafka y los escribe en un almacenamiento.
- Query: sirve la interfaz y la API de lectura.
- Agent: la documentación recomienda ahora usar en su lugar el Collector estándar de OpenTelemetry.
Dicho de otro modo, lo que en la v1 se ajustaba con flags pasa a ser un fichero YAML con el formato del Collector. El README del repositorio (Apache 2.0, unas 23 400 estrellas el día de la consulta) anuncia «Jaeger v2 is out».
El asunto del fin de vida de la v1
Voy a ser claro: no encontré ninguna fecha de fin de vida de la v1 en las páginas de arquitectura, despliegue y migración, ni en el README. La página de migración solo remite a un documento compartido de Google que no pude aprovechar. Las páginas de la documentación ya solo listan versiones 2.x.
No decidas, pues, con una fecha supuesta. Busca la política de soporte en las notas de versión del repositorio antes de fijar tu calendario, y recuerda que cada mes en la v1 es un mes sin los arreglos de la rama principal.
Haz el mapa de tu v1 antes de tocar nada
Una migración que sale bien empieza por un inventario, no por un YAML. Anota para cada componente de la v1:
- qué almacenamiento usa (memoria, Elasticsearch, Cassandra, Kafka como búfer);
- qué protocolos le envían las aplicaciones (OTLP, Jaeger gRPC o Thrift, Zipkin);
- qué estrategia de muestreo sirve a los SDK;
- qué flags personalizados viven en tus manifiestos o charts.
Ese inventario te dice sobre todo dónde se esconde el riesgo: un servicio que sigue con un protocolo antiguo, o una estrategia de muestreo servida en remoto que se te olvidó.
Cómo leer el fichero de configuración de la v2
El fichero se lanza con jaeger --config config.yaml. Sigue la estructura del Collector: un bloque service conecta componentes definidos más abajo. El ejemplo del repositorio lo deja claro.
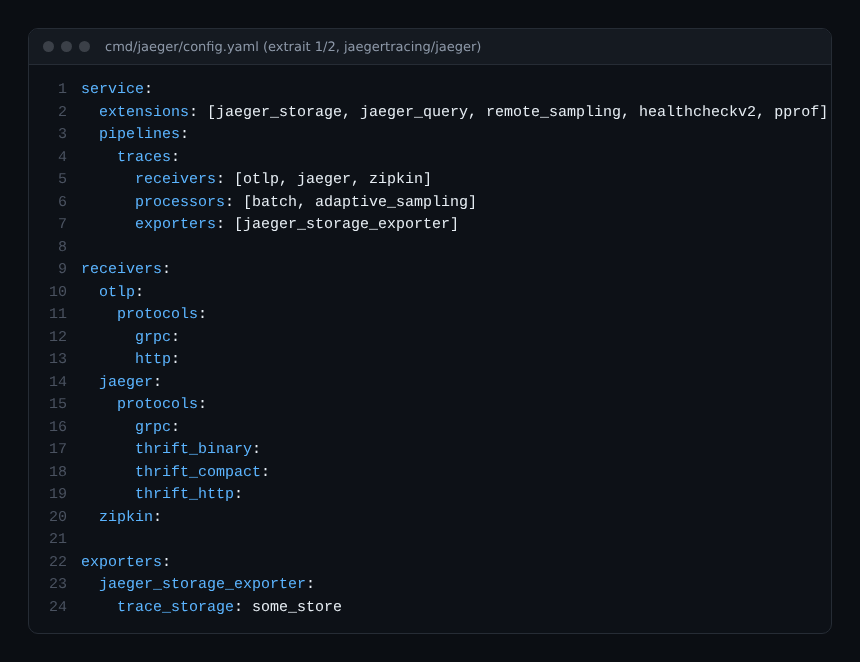
Tres ideas para quedarte:
- el pipeline
tracestiene receptores (OTLP, protocolos de Jaeger, Zipkin), procesadores y un exportador; - el exportador
jaeger_storage_exporterescribe en un almacenamiento con nombre, aquísome_store; - la lista
extensionsactiva las funciones propias de Jaeger: almacenamiento, consultas, muestreo remoto.
La segunda mitad del fichero define esas extensiones.
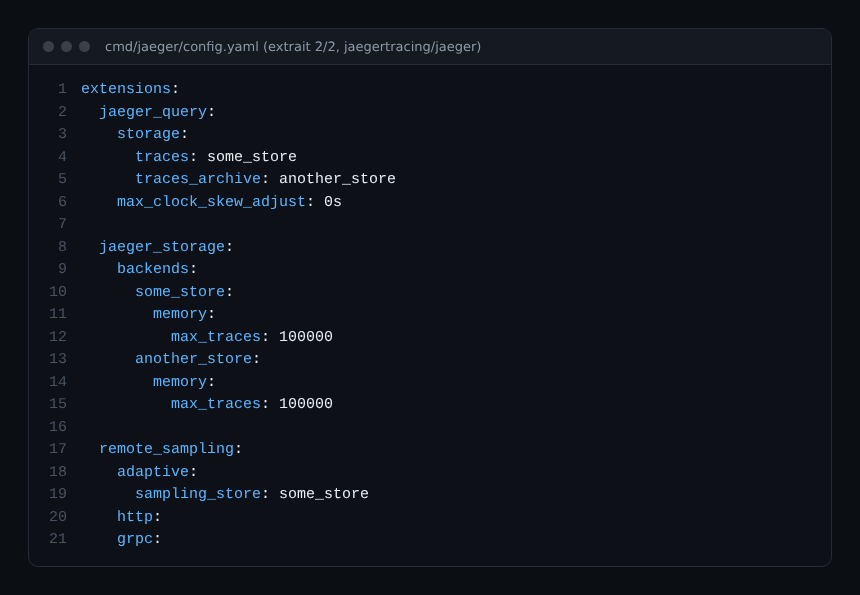
La extensión jaeger_storage declara los backends una sola vez, con un nombre. jaeger_query y el exportador lo referencian por ese nombre. Es un cambio de lógica útil: cambiar de almacenamiento es editar una entrada, no varios flags repartidos. El backend memory del ejemplo sirve para probar, no para producción.
Pasos de una migración prudente
- Arranca en paralelo. Levanta un Jaeger v2 junto a la v1, con un almacenamiento de prueba, y envíale una copia del tráfico.
- Traduce la configuración. Parte de tu inventario: un receptor por protocolo en uso, un backend con nombre por almacenamiento.
- Verifica los datos. Compara en la interfaz trazas conocidas entre las dos instancias.
- Cambia primero las escrituras y después las lecturas.
- Apaga la v1 cuando haya pasado la ventana de retención.
Para actualizar entre versiones 2.x, la documentación fija el orden: primero query, luego el ingester si usas Kafka y por último el collector. No está escrito para el salto de v1 a v2, pero el principio (lectura antes que escritura) es un buen reflejo.
La trampa de la cola del exportador
La documentación avisa de un detalle fino: si la cola del exportador confirma los spans en cuanto entran en ella, una caída del almacenamiento puede hacerte perder datos. Para evitarlo, indica configurar wait_for_result: true y no usar el procesador batch. El mismo exportador también puede actuar como conector y reenviar los spans rechazados de forma definitiva a otro pipeline, que hace de buzón de descartes. Repásalo antes de pasar a producción, sobre todo si tu SLO depende de que las trazas lleguen completas.
Buenas prácticas
- Versiona el YAML y revísalo como código.
- Deja solo los receptores de los protocolos que de verdad usas: cada puerto abierto es superficie de ataque añadida.
- Mide antes y después: latencia de escritura, spans rechazados, duración de una consulta típica.
- Si muestreas, consulta también las reglas de tail sampling para no perder las trazas útiles.
- Mantén la v1 en solo lectura hasta que termine la retención.
Preguntas frecuentes
¿Necesito un Collector de OpenTelemetry delante de Jaeger v2?
No. La documentación aclara que no hace falta para operar Jaeger. Añade que un equipo que ya tenga uno puede colocarlo delante de Jaeger para otros tipos de telemetría.
¿Tienen que cambiar mis aplicaciones?
El fichero de ejemplo mantiene receptores de Jaeger y Zipkin junto a OTLP, así que los clientes actuales pueden seguir escribiendo. Compruébalo en tu propia configuración.
¿Y con Dynatrace?
Este artículo solo trata de Jaeger. Para enviar trazas de OpenTelemetry a Dynatrace, mira el Collector de OpenTelemetry con Dynatrace; la documentación de Dynatrace distingue SaaS y Managed, y aquí no entro en ello.
Conclusión
Migrar a Jaeger v2 significa aceptar un YAML de Collector en lugar de flags: más legibilidad, a cambio de un inventario serio. Empieza en paralelo, verifica las trazas y después cambia. Fuentes: documentación de Jaeger y repositorio jaegertracing/jaeger.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC (ni al proyecto Jaeger). Las marcas citadas pertenecen a sus propietarios. Las herramientas evolucionan deprisa: comprueba siempre los comandos y las opciones en la documentación oficial correspondiente a tu versión.