
Votre facture de logs double chaque trimestre, et personne ne lit 90 % de ce qui est stocké. Faut-il vraiment indexer chaque mot de chaque ligne ? Avec Loki logs labels, Grafana Labs propose l’inverse : n’indexer que quelques étiquettes par flux, et chercher le reste à la lecture. Le dépôt grafana/loki annonçait environ 29 200 étoiles le 11 novembre 2026, sous licence AGPL-3.0.
Ce choix réduit le coût, mais il impose une discipline. Cet article part de la décision d’exploitation : quelles étiquettes garder, lesquelles refuser, et que faire des valeurs qui varient sans cesse. Les faits viennent de la documentation officielle et du dépôt, lus le 11 novembre 2026.
Précision d’honnêteté : span.observer n’a pas déployé Loki pour cet article. Les deux captures sont des extraits d’exemple rédigés par nos soins, non exécutés. Pour situer Loki dans une pile complète, voir notre comparatif Dynatrace et Grafana.
Pourquoi Loki logs labels coûte moins cher
Un moteur de recherche plein texte construit un index sur le contenu des lignes. Cet index grossit avec le volume, et il faut le stocker et le mémoriser. Loki fait un autre pari, décrit dans sa documentation : il n’indexe pas le contenu des logs, seulement des métadonnées sous forme d’étiquettes (labels) par flux.
- Un flux est la combinaison unique de toutes les paires clé-valeur d’étiquettes.
- Les lignes d’un flux sont compressées et rangées dans des chunks, stockés dans un stockage objet comme S3 ou GCS.
- L’index indique seulement où trouver les chunks d’un jeu d’étiquettes donné.
Le stockage objet est le seul mécanisme de stockage des données : Loki hérite de son coût et de sa fiabilité, par rapport à des disques locaux. Pour un volume de logs en croissance, le gain vient d’un index petit et de chunks compressés.
Le prix à payer se paie à la lecture. Loki cible d’abord un flux avec les étiquettes, puis parcourt ses lignes. Une requête qui ne sait pas restreindre les flux lit beaucoup de données.
La décision : quelles étiquettes accorder au flux ?
Tout part de la cardinalité, c’est-à-dire du nombre de combinaisons uniques d’étiquettes et de valeurs. La documentation avertit qu’une cardinalité élevée oblige Loki à construire un index énorme et à écrire des milliers de petits chunks dans le stockage objet. Chaque nouvelle valeur d’une étiquette crée un nouveau flux.
Voici le tri que je propose, en suivant les recommandations de la documentation.
- Gardez les valeurs stables et bornées : région, cluster, namespace, application, environnement. Un label d’hôte avec 1 000 valeurs reste acceptable.
- Refusez les valeurs éphémères : identifiants de trace, de commande ou de requête, adresses IP, horodatages.
- Refusez les étiquettes que personne n’interroge : elles grossissent l’index et fragmentent les flux pour rien.
- Méfiez-vous de
levelcomme étiquette dynamique : un filtre|= "level=error"est souvent aussi rapide et ne découpe pas les flux.
Des ordres de grandeur existent. Les étiquettes dynamiques devraient avoir quelques valeurs, voire quelques dizaines. Loki applique par défaut une limite de 15 étiquettes d’index, et la documentation conseille de viser 10 à 15 étiquettes personnalisées au plus.
Le cas qui fait mal : l’identifiant de requête en étiquette
La documentation donne un exemple parlant. Une analyse avec logcli series --analyze-labels montrait une étiquette requestId avec 24 653 valeurs pour 24 979 flux. Le guide la qualifie de « parfait exemple de ce qui ne doit pas être un label ».
La correction consiste à retirer l’étiquette et à filtrer dans la ligne, par exemple avec |= "requestId=32422355". Le flux reste unique, les chunks se remplissent, et la recherche reste raisonnable si le sélecteur est précis.
Un second effet est moins visible. Avec trop de flux, les chunks sont écrits avant d’être pleins, par expiration d’inactivité ou par âge maximal. Le résultat est une multitude de petits chunks. La métrique loki_ingester_chunks_flushed_total, regroupée par reason, montre pourquoi ils partent.
Autre contrainte à connaître : dans un flux, les entrées doivent arriver dans l’ordre, dans une fenêtre par défaut de deux heures. Au-delà, Loki rejette la ligne avec une erreur « too far behind ». Séparer deux sources avec des étiquettes distinctes évite de les mélanger dans un même flux.
Structured metadata : garder la valeur sans l’indexer
Que faire d’un identifiant de pod, de thread ou de processus, utile mais jamais assez stable pour être une étiquette ? La documentation propose la structured metadata : des métadonnées attachées à la ligne, sans index et sans les mettre dans le texte. La documentation la recommande notamment pour les données OpenTelemetry reçues via Grafana Alloy ou un OpenTelemetry Collector. Pour Alloy, voyez l’article sur le collecteur qui remplace Promtail.
Elle a des prérequis précis :
- un schéma en version 13 ou plus (chunk format V4) ;
- l’index
tsdb: l’ancienboltdb-shipper, déprécié, ne la supporte pas ; allow_structured_metadata: truedanslimits_config.
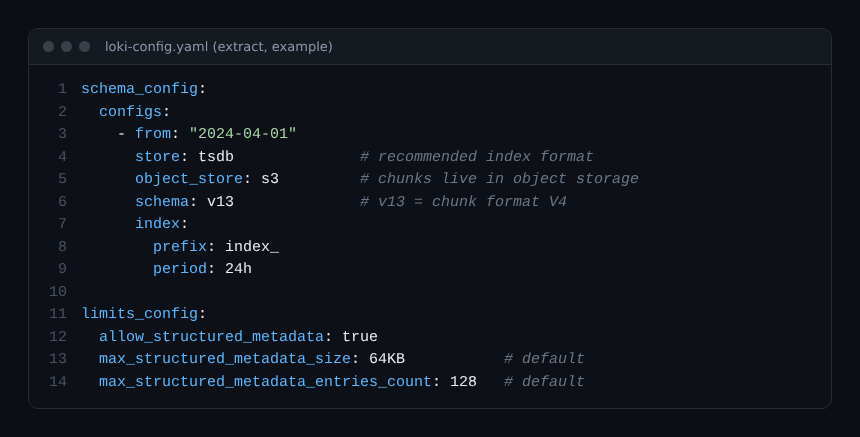
Les limites par défaut sont de 64 Ko et 128 entrées par ligne. Au-delà, la ligne est rejetée avec une erreur HTTP 400. À la lecture, ces valeurs apparaissent comme des étiquettes du résultat et se filtrent de la même façon. Attention : dans une requête métrique, elles peuvent faire exploser le nombre de séries. Les étapes keep ou drop retirent ce qui est inutile.
La documentation que j’ai lue ne dit pas à quelle version de Loki la fonction est apparue : je ne l’avance pas.
Interroger avec LogQL
Une requête LogQL a deux parties : un sélecteur de flux obligatoire, puis un pipeline optionnel. Le sélecteur utilise les opérateurs =, !=, =~ et !~. Le pipeline enchaîne des filtres de ligne (|=, !=, |~), des analyseurs comme json ou logfmt, puis des filtres sur les champs extraits.
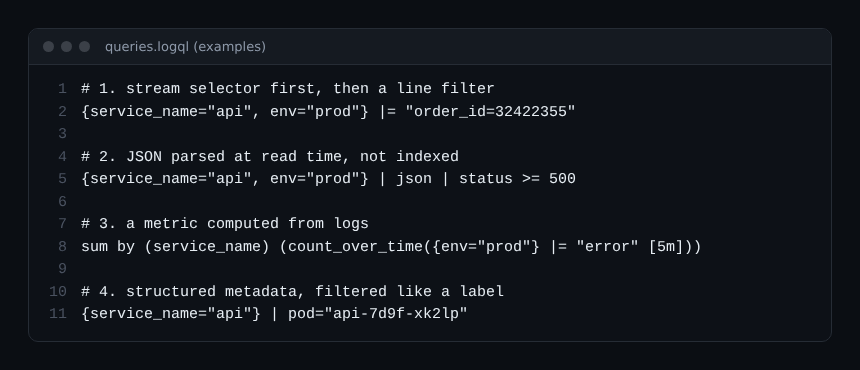
La règle pratique : un sélecteur étroit d’abord, puis un filtre de ligne, puis un analyseur. L’analyseur est coûteux sur beaucoup de lignes ; le sélecteur ne l’est pas. Pour comprendre une approche différente de l’analyse des logs, voyez l’analyse de patterns de logs.
Licence AGPL-3.0 : ce qu’elle impose
Le README du dépôt indique que Loki est distribué sous AGPL-3.0-only, et le fichier LICENSE contient le texte de la GNU Affero General Public License, version 3. Je n’ai pas trouvé d’exception dans ce fichier.
La particularité de l’AGPL est sa section 13 : si vous modifiez le logiciel et que des utilisateurs interagissent avec lui à distance, vous devez leur proposer le code source de votre version modifiée. Pour un usage interne sans modification, l’obligation est généralement vue comme légère. Cette lecture n’est pas un avis juridique : faites valider votre cas, surtout si vous modifiez Loki ou le proposez comme service. Je n’ai pas vérifié les conditions des offres commerciales de Grafana Labs.
Bonnes pratiques
- Listez les étiquettes que vos requêtes utilisent vraiment, supprimez les autres.
- Mesurez la cardinalité avant la mise en production, avec
logcli series --analyze-labels. - Passez les valeurs à haute cardinalité en structured metadata, après avoir vérifié le schéma et l’index.
- Surveillez les raisons de flush des chunks et le nombre de flux actifs par tenant.
- Gardez des requêtes à sélecteur étroit : c’est lui qui borne le coût de lecture.
- Relisez la licence AGPL avant de modifier le code ou de l’exposer à des tiers.
Questions fréquentes
Loki est-il vraiment moins cher qu’un moteur plein texte ?
La documentation l’affirme pour l’exploitation, grâce à un petit index et à des chunks compressés dans un stockage objet. Je n’ai pas mesuré ce gain : il dépend de votre volume, de vos étiquettes et de vos requêtes.
Peut-on rechercher une valeur qui n’est pas une étiquette ?
Oui, avec un filtre de ligne ou un analyseur, ou via la structured metadata. La recherche parcourt alors les lignes des flux sélectionnés, donc un sélecteur précis reste indispensable.
Quelle est la limite à ne pas dépasser ?
La documentation donne comme repère, pour de très gros tenants, moins de 100 000 flux actifs et moins de 1 million de flux sur 24 heures. Un tenant plus petit doit descendre proportionnellement.
Conclusion
Loki rend les logs peu coûteux si vous acceptez une règle simple : peu d’étiquettes, stables, choisies pour les requêtes. Ce qui varie va dans la ligne ou dans la structured metadata. Dépôt et documentation : grafana/loki et grafana.com/docs/loki.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni à Grafana Labs. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans la documentation officielle.