
Votre application appelle un LLM, la facture grimpe, et personne ne sait quelle requête coûte le plus. Avec OpenLIT OpenTelemetry, la réponse tient dans une trace : chaque appel au modèle devient un span avec son modèle, ses tokens et son coût. Le dépôt openlit/openlit est sous licence Apache 2.0 et affichait environ 3 000 étoiles le 11 novembre 2026.
Cet article part d’une décision d’exploitation : faut-il instrumenter à la main, ou laisser un SDK le faire pour vous ? Et surtout, que faut-il accepter de stocker dans les traces ? Les faits viennent du README du dépôt et de la documentation docs.openlit.io, lus le 11 novembre 2026.
Précision d’honnêteté : span.observer n’a pas exécuté ces commandes. Les extraits reprennent la documentation, et la capture de trace vient du dépôt du projet (Apache 2.0). Pour comparer avec d’autres approches, voyez Langfuse et OpenLLMetry et OpenInference vers un Collector.
OpenLIT OpenTelemetry : ce que le projet fait vraiment
OpenLIT se présente comme une plateforme open source pour tracer, évaluer et améliorer des applications d’IA avec OpenTelemetry. Le README annonce plus de 70 intégrations : fournisseurs de modèles, frameworks d’agents, bases vectorielles et GPU.
- SDK : Python (
pip install openlit), TypeScript (npm install openlit) et Go. - Conventions : les traces et métriques suivent les conventions sémantiques GenAI d’OpenTelemetry, dans l’espace de noms
gen_ai.*. - Export : de l’OTLP, donc des traces, des métriques et des événements standards, lisibles par n’importe quel backend compatible.
- Interface : un tableau de bord auto-hébergé, lancé avec
docker compose up -d, qui écoute l’OTLP sur les ports 4317 (gRPC) et 4318 (HTTP).
Le tableau de bord est donc facultatif. Le SDK compte plus que lui : il produit des spans que vous pouvez envoyer ailleurs.
Trois façons d’instrumenter, un seul critère de choix
La documentation propose trois entrées. Le critère de choix est simple : qui peut modifier le code de l’application ?
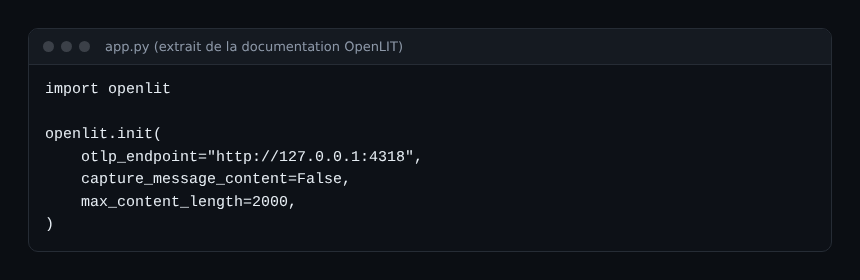
Vous possédez le code : openlit.init()
Un appel au démarrage suffit. Le SDK repère les bibliothèques installées et les instrumente. L’extrait ci-dessous combine l’adresse OTLP et deux options de confidentialité que nous détaillons plus bas.
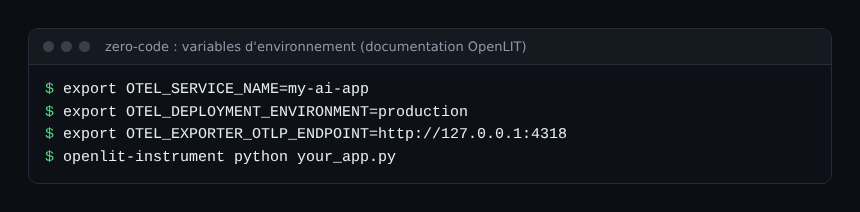
Vous ne touchez pas au code : openlit-instrument
La CLI lance votre programme à votre place. Le service, l’environnement et l’endpoint passent par des variables d’environnement. C’est le bon choix pour une application tierce ou un conteneur que vous ne reconstruisez pas.
Vous êtes en TypeScript avec des imports statiques
Un import de premier niveau comme import OpenAI from "openai" échappe à l’instrumentation automatique. La documentation demande alors de passer le module au paramètre instrumentations. LangChain doit passer par des imports dynamiques.
Attention à un piège de la page de démarrage : la ligne export OTEL_EXPORTER_OTLP_ENDPOINT = "..." y est écrite avec des espaces autour du signe égal, ce que le shell refuse. Écrivez-la sans espaces.
Ce que contient un span : lire une trace
Ouvrez une trace et regardez les attributs du span. Sur la capture du dépôt, un appel de chat montre le modèle, la durée, le nombre de tokens et le coût. Les attributs portent les noms gen_ai.operation.name, gen_ai.provider.name et gen_ai.request.model.
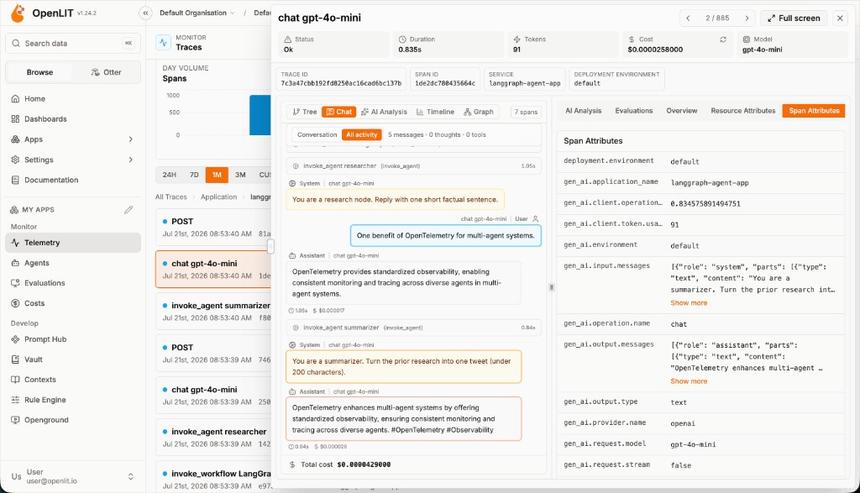
Source de l’image : dépôt openlit/openlit, licence Apache 2.0. Ce découpage rend la trace exploitable : un span par appel, un parent par conversation. Vous voyez où part le temps et où partent les tokens.
Décider quoi capturer : prompts, longueur, PII
Par défaut, le SDK Python capture le contenu des messages. C’est utile pour déboguer, mais risqué : les prompts contiennent souvent des données de clients. Trois réglages encadrent la décision.
capture_message_content=False(variableOTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT) garde prompts et réponses hors des traces. La valeur par défaut estTrue.max_content_lengthtronque le contenu conservé.guards=[openlit.PII(action="redact")]masque des valeurs sensibles avant l’envoi du prompt. La documentation précise que cette réécriture ne s’applique qu’aux prompts à message unique.
Notre recommandation, non testée : en production, coupez d’abord le contenu, puis réactivez-le seulement sur un environnement de préproduction.
Étapes : de zéro à une première trace
- Installez le SDK avec
pip install openlit. - Choisissez l’entrée :
openlit.init()dans le code, ouopenlit-instrumentdevant la commande. - Posez
OTEL_SERVICE_NAMEetOTEL_DEPLOYMENT_ENVIRONMENT. Sans eux, la documentation donne la valeurdefaultaux deux. - Pointez
OTEL_EXPORTER_OTLP_ENDPOINTvers le tableau de bord OpenLIT ou vers votre Collector. - Appelez le modèle une fois, puis cherchez le service dans l’interface.
Pour vérifier que cela fonctionne : la trace doit contenir un span de chat avec gen_ai.request.model et le nombre de tokens. Si elle reste vide, contrôlez d’abord le port 4318 et le fait que init() s’exécute avant l’import du client LLM.
Un point de priorité à retenir, d’après la page de configuration : les variables d’environnement l’emportent sur les arguments de la CLI, qui l’emportent sur les paramètres du SDK. En cas de doute, regardez les variables du processus.
Vers quel backend envoyer les données ?
La documentation indique qu’on peut sauter la pile fournie et envoyer l’OTLP à un autre backend OpenTelemetry. La suite est de l’ingénierie classique : un Collector devant, des attributs de ressource propres, une rétention adaptée. Le suivi des coûts vu côté tokens est détaillé dans notre article sur le coût d’un agent IA.
Dynatrace n’est pas mentionné dans les pages lues du projet, et nous n’avons pas vérifié ce raccordement. Pour Dynatrace, appuyez-vous uniquement sur docs.dynatrace.com, en distinguant SaaS et Managed.
Bonnes pratiques
- Fixez
service_nameet l’environnement : sans eux, tous vos services se retrouvent sous « default ». - Changez les identifiants par défaut du tableau de bord (l’exemple de la documentation utilise un compte public) avant toute exposition réseau.
- Désactivez la capture des messages dès que les prompts contiennent des données personnelles.
- Gardez le SDK à jour : les conventions GenAI évoluent et les noms d’attributs peuvent changer.
- Mesurez le surcoût de l’instrumentation sur votre charge : nous ne l’avons pas fait.
Questions fréquentes
OpenLIT remplace-t-il OpenTelemetry ?
Non. OpenLIT est un SDK et une plateforme construits sur OpenTelemetry. Il exporte de l’OTLP standard et suit les conventions gen_ai.*.
Faut-il le tableau de bord d’OpenLIT ?
Non. Il sert à démarrer vite et peut être remplacé par un autre backend OTLP. Le SDK reste le même.
Les prompts sont-ils stockés dans les traces ?
Par défaut, oui, pour le SDK Python. Utilisez capture_message_content=False pour l’éviter.
Conclusion
OpenLIT vaut un essai si vous voulez des traces GenAI standard sans écrire vos spans à la main. Choisissez l’entrée selon qui maîtrise le code, puis décidez de ce que les traces ont le droit de contenir. Dépôt : openlit/openlit ; documentation : docs.openlit.io.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni à OpenLIT. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans la documentation officielle.