
Un incident s’achève, et quelqu’un corrige « juste un panneau » dans l’interface. Trois mois plus tard, personne ne sait pourquoi le tableau de production diffère de celui de la préproduction. Les tableaux de bord as code répondent à cette dérive : la définition vit dans Git, elle se relit en revue et se déploie par pipeline. Perses, projet de la CNCF, en fait son argument principal.
Cet article part d’une décision d’exploitation : faut-il changer d’outil de visualisation pour cela ? Les faits viennent du dépôt perses/perses (README, VERSION, CHANGELOG, dossier docs/), lus le 11 novembre 2026, et du dépôt grafana/grafana pour la licence. Je n’ai pas installé Perses pour cet article : les captures reproduisent des extraits réels de la documentation du projet.
Le blog est indépendant. Il ne compare pas ces outils à Dynatrace ici, et chaque fonction Dynatrace citée ailleurs sur le site renvoie à docs.dynatrace.com.
Ce que Perses est, et ce qu’il n’est pas
- Un outil de tableaux de bord : le README le décrit « d’abord et avant tout » comme tel. Il lit des métriques Prometheus, des traces Tempo, des logs Loki et du profiling Pyroscope, plus d’autres sources par plugins.
- Licence et gouvernance : Apache 2.0 (fichier LICENSE), projet « sandbox » de la Cloud Native Computing Foundation. Grafana est distribué sous AGPL-3.0 (README de
grafana/grafana), avec des exceptions Apache-2.0 détaillées dans son fichier LICENSING.md. - Version lue : 0.55.0, publiée le 21 octobre 2026 selon le CHANGELOG. Le numéro 0.x rappelle que l’API peut encore bouger : cette version casse plusieurs choses (React 17 abandonné, Node 24 exigé, anciennes spécifications supprimées).
- Pas une plateforme complète : ni stockage de métriques, ni alerting dans les pages lues ici. Perses affiche ; vos sources restent Prometheus et compagnie.
Je n’ai pas relevé le nombre d’étoiles du dépôt : l’API GitHub n’était pas accessible depuis mon poste de travail. Les chiffres de popularité ne comptent d’ailleurs pas pour ce choix.
Le problème de départ : la dérive entre interface et dépôt
Quand l’interface est la source de vérité, trois dérives reviennent. Les copies divergent entre environnements. Personne ne relit les changements. Et corriger la même requête dans quarante tableaux prend une journée. Le README de Perses revendique une approche « GitOps-friendly » : SDK, bibliothèques de CI/CD, validation statique et CLI native.
Sa documentation justifie le code par l’échelle : l’intérêt apparaît quand on maintient beaucoup de tableaux qu’il faut garder alignés. Pour cinq tableaux, un export JSON versionné suffit probablement. Au-delà, il faut des composants réutilisables.
Comment fonctionnent les tableaux de bord as code avec Perses
Le principe tient en trois temps : on écrit dans un SDK, on construit un JSON ou YAML Perses, puis on l’applique à l’API.
- Écrire avec le SDK CUE ou le SDK Go. La documentation les compare : CUE valide mieux et s’intègre à tous les plugins, Go demande moins d’apprentissage et s’intègre mieux à du code existant.
- Construire avec
percli dac build. La sortie arrive dans un dossierbuilt, en YAML par défaut ou en JSON avec-ojson. - Valider avec
percli lint. Par défaut, aucun serveur n’est requis ; l’option--onlineinterroge un serveur Perses pour tester la compatibilité avec ses plugins. - Déployer avec
percli apply -f built/mon_tableau.json.
La documentation conseille un tableau par fichier et percli dac build -d mon_dossier pour tout construire d’un coup. Les prérequis indiqués pour la version 0.55.0 : percli en 0.55.0 minimum, et cue en 0.17.1 minimum pour le SDK CUE.
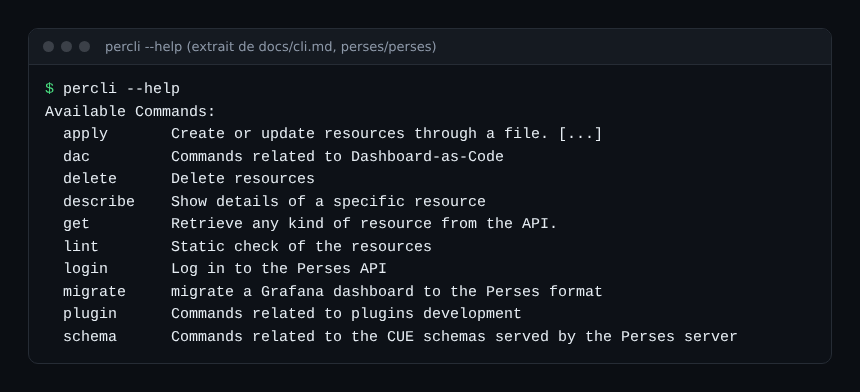
La première capture résume l’outillage : dac, lint, apply et migrate couvrent tout le cycle. percli login prend en charge un jeton, un couple utilisateur et mot de passe, un fournisseur OIDC ou un fichier kubeconfig ; le jeton d’identification expire après une heure d’après la documentation.
Un tableau écrit en CUE : lire l’exemple de la documentation
La documentation propose un exemple complet. Voici le début : on nomme le tableau, on déclare le projet, une variable alimentée par les valeurs d’une étiquette Prometheus, puis la source de données.
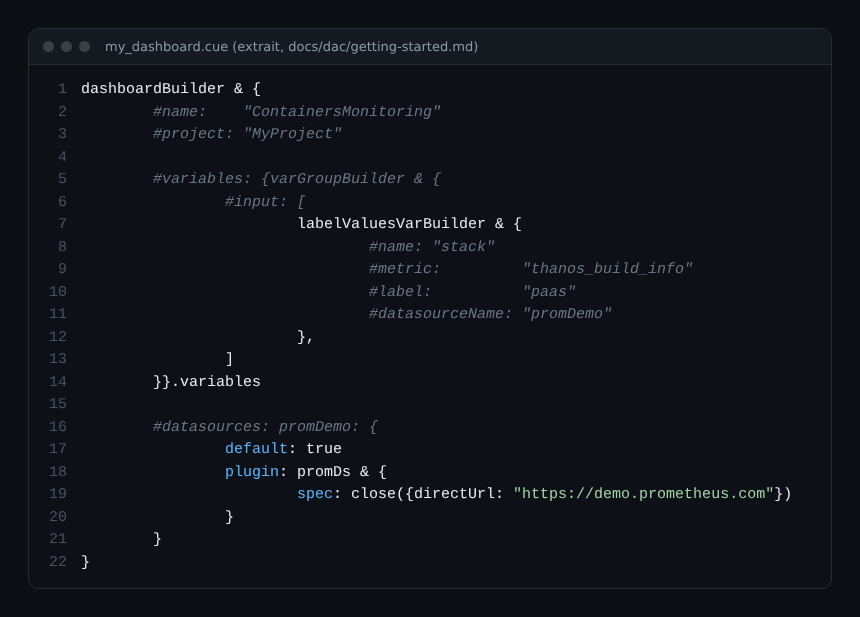
Deux détails comptent pour l’exploitation. D’abord, la source de données se déclare dans le même fichier : le tableau emporte avec lui sa dépendance. Ensuite, les champs commençant par # sont des paramètres du constructeur CUE : on factorise une fois, puis on instancie par équipe ou par environnement. C’est là que la maintenance baisse : un changement dans le composant commun se propage à tous les tableaux au prochain build.
Attention, les requêtes PromQL restent à votre charge. Garder des noms de métriques stables facilite ce travail : voyez nos conseils sur les recording rules Prometheus et sur la cardinalité des métriques Kubernetes, qui jouent sur le coût de chaque panneau.
Migrer depuis Grafana : ce que l’outil promet vraiment
percli migrate traduit un tableau Grafana au format Perses. La documentation fixe des limites claires, qu’il vaut mieux lire avant de promettre une migration à son équipe :
- seuls les tableaux de bord sont migrés, ni alertes ni utilisateurs ;
- la migration se fait au mieux : Perses est plus jeune et ne couvre pas tous les plugins Grafana ;
- versions de Grafana prises en charge : de 9.0.0 à 11.x ; le modèle de Grafana 12 (schéma v2,
apiVersionendashboard.grafana.app/) est rejeté, il faut exporter le JSON classique ; - le champ « Regex » des variables n’est pas migré.
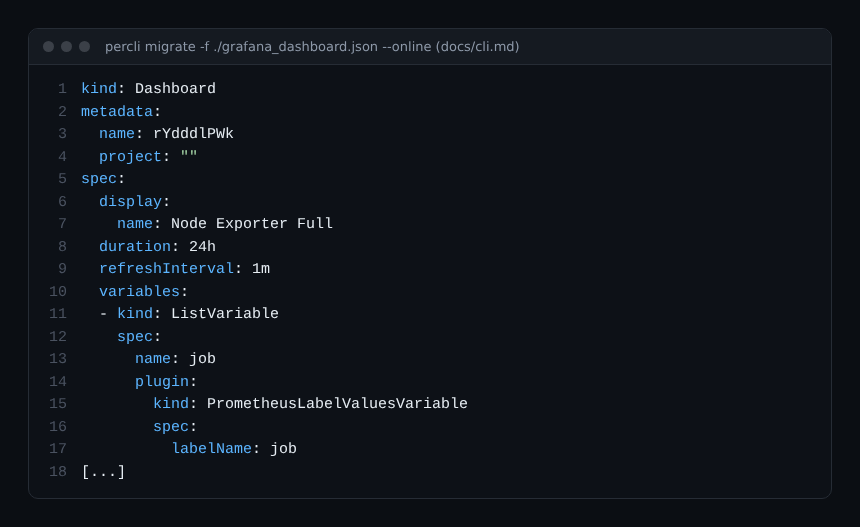
Ma recommandation : migrez un tableau pilote, relisez le YAML obtenu comme du code, puis comparez les panneaux à l’écran. Considérez le résultat comme un brouillon, pas comme une conversion garantie.
Kubernetes : l’opérateur Perses
Les définitions peuvent aussi vivre dans le cluster. Le dépôt perses/perses-operator (Apache 2.0) propose des ressources personnalisées pour déployer des instances Perses, des tableaux de bord et des sources de données, avec synchronisation automatique. Il permet de cibler une instance par sélecteur et d’associer un espace de noms à un projet Perses pour l’isolation. Je n’ai pas testé l’opérateur : lisez son guide avant de l’adopter.
Côté sécurité, le CHANGELOG de la 0.55.0 corrige de nombreuses vulnérabilités, dont des critiques exploitables sans authentification avec la configuration par défaut, et impose une clé de chiffrement quand l’authentification est active. Le proxy de sources de données refuse désormais par défaut les adresses de boucle locale, de métadonnées cloud et l’API Kubernetes. Si vous déployez Perses, partez d’une version à jour et lisez la page « security » de la documentation.
Perses ou Grafana : la comparaison honnête
- Maturité : Grafana est plus ancien, avec un écosystème de plugins plus vaste. Perses assume être plus jeune ; ses 0.x et ses ruptures de version le rappellent.
- Dashboard-as-Code : c’est le point de départ de Perses, avec CLI, SDK et validation intégrés. Grafana propose aussi des moyens de gérer ses tableaux comme du code ; je ne les ai pas revérifiés pour cet article, donc je ne les compare pas fonction par fonction.
- Périmètre : Grafana couvre davantage de domaines. Perses se concentre sur l’affichage.
- Licence : Apache 2.0 pour Perses, AGPL-3.0 pour Grafana. Si votre service juridique évite l’AGPL, le critère pèse ; sinon, il n’est pas décisif.
- Coût de changement : refaire ses tableaux et ses habitudes d’équipe coûte plus cher que la licence. Un essai à côté de l’existant coûte peu.
Pour replacer le sujet dans une stratégie plus large, relisez OpenTelemetry et Prometheus et l’installation de Grafana Tempo avec kube-prometheus-stack, deux briques qu’un tableau as code lit.
Bonnes pratiques
- Un tableau par fichier, relu en pull request, avec
percli lintdans la CI. - Un composant commun par type de service, instancié ensuite.
- Un tableau pilote avant tout lot de migration.
- Version de
percliet du SDK épinglées, puisque le projet est en 0.x. - Aucun secret dans le dépôt : sources de données et jetons restent côté serveur.
Questions fréquentes
Perses remplace-t-il Grafana ?
Pas à périmètre égal. Perses affiche des données déjà stockées ; il est plus jeune et plus restreint. Il convient à une équipe dont le besoin principal est de gérer ses tableaux par le code.
Faut-il apprendre CUE pour utiliser Perses ?
Non. Le SDK Go existe, et les tableaux se créent aussi dans l’interface ou en JSON ou YAML. La documentation indique que CUE offre une meilleure validation, au prix d’un apprentissage plus long.
Mes tableaux Grafana se migrent-ils sans perte ?
Non, la documentation parle de migration au mieux, pour les versions 9.0.0 à 11.x et pour les seuls tableaux de bord. Testez d’abord un cas réel.
Conclusion
Les tableaux de bord as code de Perses répondent à un vrai problème de dérive et de maintenance, avec un outillage complet : SDK, percli, validation, opérateur Kubernetes. Le projet reste jeune et sa 0.55.0 a surtout corrigé des failles de sécurité : testez-le à côté de votre outil actuel. Dépôt et documentation : perses/perses et perses.dev.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni aux projets Perses et Grafana. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans la documentation officielle.