ai-memory, mémoire agents de code écrite en Rust : ce projet open source donne à vos agents (Claude Code, Codex, Cursor, Gemini CLI, OpenCode et plus de vingt autres harnais) une mémoire longue partagée, stockée sous forme de pages Markdown versionnées avec Git. Le dépôt akitaonrails/ai-memory affiche environ 12 600 étoiles à la fin octobre 2026, sous licence MIT.
L’idée du README : quitter Claude Code en pleine tâche, ouvrir Codex dans le même dossier et reprendre sans réexpliquer l’architecture, les pistes abandonnées et les questions ouvertes. Cet article présente le projet, son installation d’après le README, ce que montre son interface web, ses limites (données capturées, jeunesse) et la manière de le superviser avec ses métriques Prometheus. Précision d’honnêteté : span.observer n’a pas installé ai-memory ; les commandes viennent du README et les captures viennent du dépôt.
ai-memory : mémoire agents de code, ce que dit le dépôt
- Qui : le dépôt appartient au compte
akitaonrails, sous licence MIT (copyright 2026 au nom du mainteneur). Son site est aimemory.sh. - Chiffres relus le 22 octobre 2026 : environ 12 600 étoiles, environ 889 forks, 4 344 commits ; la version 3.2.0 figure au changelog à la date du 21 octobre 2026 ; la chaîne d’outils demandée est Rust 1.95 ou plus.
- Architecture : un binaire Rust autonome qui sert MCP et HTTP et possède un dossier de données avec un wiki Markdown versionné (source de vérité), un index SQLite dérivé (FTS5, entités, embeddings optionnels) et des journaux.
- Cycle : capture par hooks de cycle de vie (prompts, appels d’outils, limites de session), consolidation en pages à la fin de la session, rappel par recherche et injection d’un résumé, puis « handoff » vers l’agent suivant.
Le projet insiste sur un point : le chemin par défaut n’utilise aucun appel à un LLM. La capture, la recherche et les handoffs fonctionnent sans clé d’API, et les fonctions qui réécrivent le contenu (compaction, déduplication, « dream ») sont facultatives et désactivées par défaut. Pour comparer avec d’autres approches de la mémoire d’agent, lisez notre article sur Hindsight ; le README cite lui-même Hindsight dans son tableau comparatif.
Visite de l’interface web
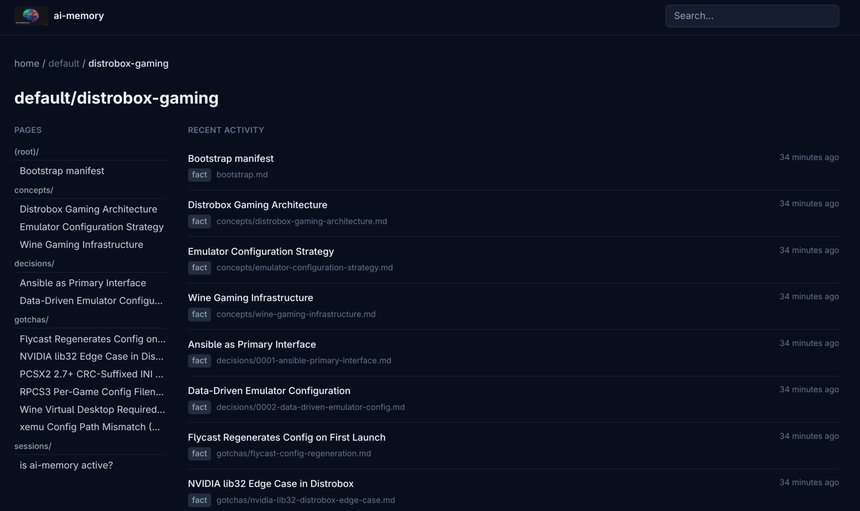
Le serveur peut démarrer avec --enable-web pour offrir une vue du wiki en lecture seule dans le navigateur, un graphe de liens (/web/graph) et une API JSON sous /api/v1. La capture ci-dessous, tirée du dépôt, montre un projet avec ses pages classées par dossier (concepts/, decisions/, gotchas/, sessions/) et l’activité récente.
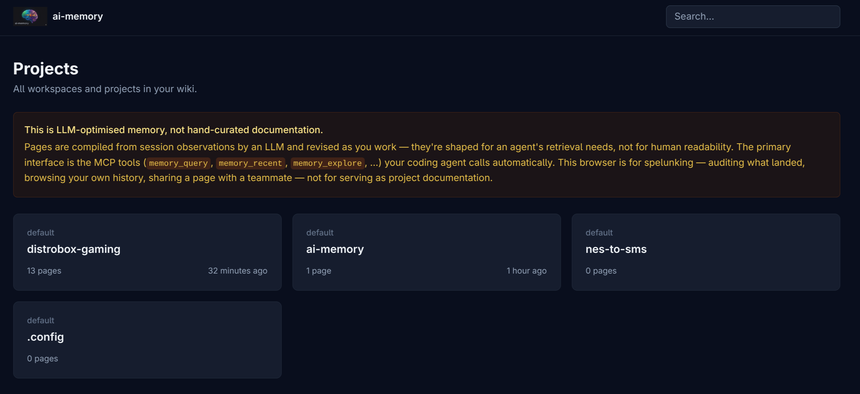
Sur l’écran d’accueil, un avertissement du projet rappelle que ces pages sont « LLM-optimised memory, not hand-curated documentation » : compilées pour la récupération par un agent, pas pour la lecture humaine. Le navigateur sert à auditer ce qui a été enregistré.
Installation pas à pas
Étape 1 — Linux et macOS
Le README propose deux commandes, sans droits root :
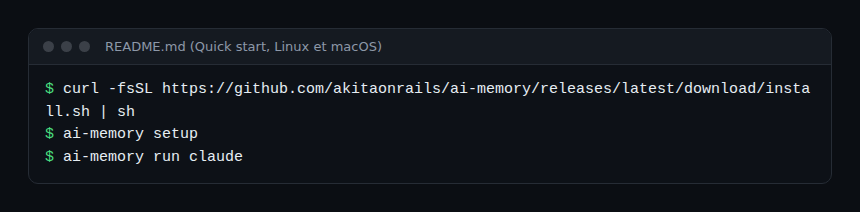
Selon le README, install.sh télécharge la version pour votre système, la compare à la somme SHA-256 publiée (et refuse d’installer sans correspondance), puis crée un lien dans ~/.local/bin. ai-memory setup crée le dossier de données avec un jeton dans un fichier réservé au propriétaire, démarre un service utilisateur (systemd ou launchd) et configure MCP, hooks et skills pour les agents qu’il trouve, après confirmation. L’option --plan affiche le plan sans rien modifier.
Étape 2 — Windows et autres plateformes
Sous Windows, le README donne deux commandes PowerShell (install.ps1 puis ai-memory setup), et classe Windows natif comme « expérimental » ; Windows via WSL2 est « supporté ». Des paquets existent pour Arch (AUR), Fedora (RPM), NixOS, une application de barre de menus macOS et une image Docker.
Étape 3 — Lancer un agent
Le README conseille de démarrer l’agent avec ai-memory run claude (ou codex) : le lanceur câble hooks et MCP s’ils manquent, et ajoute la continuité de session entre harnais. Redémarrez ensuite vos agents et demandez-leur « What do you remember about this project? » pour vérifier.
Limites et points ouverts
- Ce qui est capturé : les hooks enregistrent prompts et appels d’outils, nettoyés par une frontière de confidentialité avant stockage. Le fichier DATA_HANDLING.md précise qu’il n’y a pas de chiffrement au repos en v1 et s’appuie sur les droits du système de fichiers. Des règles
[capture]par dépôt permettent d’exclure des chemins. - Authentification : le README signale que le démarrage rapide Docker n’a aucune authentification (liaison sur la boucle locale seulement). Les installations natives avec
ai-memory initreçoivent un jeton. Ajoutez TLS via un proxy inverse dès que le serveur sort de la machine. - Chemins externes optionnels : par défaut, tout est local, avec des embeddings locaux. Un fournisseur de LLM ou d’embeddings distant envoie du contenu à ce fournisseur si vous l’activez.
- Maturité : le projet publie des versions majeures rapprochées, annonce Windows natif comme expérimental et déclare, dans ses remerciements, avoir été construit en collaboration avec Claude Code. Lisez le changelog avant chaque mise à jour.
- Mémoire erronée : une mémoire automatique peut conserver une conclusion fausse. Le README signale du « contradiction flagging », pas une garantie de vérité.
Comment superviser ai-memory
ai-memory est un service local de longue durée : on le supervise comme tel. D’après la documentation du dépôt, trois sources existent. La commande ai-memory status --json (équivalent de GET /admin/status, protégé) donne l’état, y compris une télémétrie des appels LLM par charge de travail quand un fournisseur est configuré. Le point GET /admin/metrics expose en format texte Prometheus des compteurs de hooks par résultat, les appels d’outils MCP séparés en lecture et écriture, et des histogrammes de latence de POST /hook et memory_query ; les étiquettes viennent d’un ensemble fermé et aucun texte de requête, nom de projet ou jeton ne peut y figurer. Enfin /web/health affiche la file d’écriture, le spool de hooks et la file de consolidation.
Le dépôt précise qu’il n’existe pas d’exporteur OpenTelemetry : les compteurs se remettent à zéro au redémarrage, et l’export OTLP est noté « à mesurer d’abord ». Pour les envoyer à Dynatrace, on peut faire lire /admin/metrics par un OpenTelemetry Collector avec le récepteur Prometheus, comme l’explique notre article sur OpenTelemetry et Prometheus, en respectant l’authentification du serveur. Cela vaut pour Dynatrace SaaS ; sur Dynatrace Managed, vérifiez la prise en charge de l’ingestion de métriques OTLP.
Côté agent, l’impact sur le coût (le résumé injecté consomme des tokens) se mesure avec la télémétrie de l’agent, voir le coût d’un agent IA en tokens avec OpenTelemetry et superviser un agent de code en entreprise.
Comment vérifier que ça fonctionne
ai-memory statusetai-memory doctorne signalent pas d’avertissement bloquant.- Après une session, une page apparaît dans le wiki (vue web ou fichiers Markdown).
- Dans un nouvel agent du même dossier, la question « where did we leave off? » reprend le handoff.
Bonnes pratiques
- Commencez sur un dépôt sans secret, avec les règles
[capture]d’exclusion en place. - Gardez le serveur sur la boucle locale ; sinon jeton, comptes et TLS.
- Sauvegardez le dossier de données (le README décrit une sauvegarde vers un dépôt Git distant) et relisez les pages enregistrées.
- Fixez la version et lisez les notes de mise à jour avant de migrer.
Questions fréquentes
ai-memory a-t-il besoin d’un LLM ou d’une clé d’API ?
Non par défaut : capture, recherche et handoffs fonctionnent sans appel à un LLM. Un fournisseur ne sert qu’à améliorer les résumés et la recherche sémantique, si vous le configurez.
Les données quittent-elles ma machine ?
D’après DATA_HANDLING.md, non par défaut : le projet dit ne pas envoyer de télémétrie. Certaines options (fournisseur de LLM ou d’embeddings distant, serveur partagé) envoient du contenu où vous les pointez.
Peut-on le partager dans une équipe ?
Oui, d’après le README : un serveur commun, avec authentification multi-utilisateurs, attribution et journal d’audit. Les handoffs personnels restent personnels.
Conclusion
ai-memory propose une mémoire agents de code transparente : des fichiers Markdown que vous possédez, un binaire Rust unique et un fonctionnement sans LLM par défaut. Elle capture beaucoup de contenu : à vous de décider quoi, où et avec quelle supervision. Sources : dépôt akitaonrails/ai-memory.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni aux projets cités. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans leur documentation officielle.