
Un jeton d’autorisation apparaît dans un attribut de log, une métrique arrive avec un nom que personne ne reconnaît, et les health checks gonflent la facture de traces : trois problèmes, une seule réponse possible dans le Collector, le langage OTTL OpenTelemetry. Il permet de corriger la télémétrie en vol, avant qu’elle ne parte vers le backend.
Cet article part de ces trois décisions d’exploitation plutôt que de la liste des fonctions : que faut-il masquer, que faut-il renommer, que faut-il jeter ? Chaque réponse tient en quelques instructions. Pour le panorama des composants, voir l’article sur les composants du Collector contrib ; ici, on se concentre sur le langage.
Les faits viennent de la page « Transforming telemetry » d’opentelemetry.io et des README du dépôt opentelemetry-collector-contrib (pkg/ottl, transformprocessor, filterprocessor), lus le 12 novembre 2026. Le traitement a lieu dans le Collector, avant l’export OTLP : le raisonnement vaut pour Dynatrace SaaS, pour Dynatrace Managed et pour tout autre backend.
Lire une instruction OTTL en trente secondes
Une instruction OTTL comporte une fonction et, en option, une condition. La fonction transforme la télémétrie. La condition, introduite par where, décide si la fonction s’exécute. L’exemple du README tient en une ligne : set(span.attributes["test"], "pass") where span.attributes["test"] == nil.
Le premier argument est un chemin (path) vers un champ : span.attributes, resource.attributes, log.body, metric.name. Le préfixe indique le contexte. Le README liste les contextes resource, scope, span, span event, span link, metric, datapoint, exemplar et log. Un point à retenir : OTTL ne gère pas les interactions entre signaux. Copier le corps d’un log dans un attribut de span est refusé.
Deux familles de fonctions existent. Les éditeurs modifient la donnée (set, delete_key, replace_pattern, keep_keys, truncate_all). Les convertisseurs calculent une valeur et s’écrivent avec une majuscule (SHA256, IsMatch, Concat, Substring, ParseJSON). Le langage sert à plusieurs endroits : le processeur transform, le processeur filter, le tail sampling et le routing connector.
Masquer : retirer le secret avant l’export
Premier réflexe en cas de fuite : supprimer la clé fautive, puis nettoyer ce qui reste dans le texte. Le processeur transform reçoit des listes d’instructions par signal (log_statements, trace_statements, metric_statements). Voici une configuration de logs qui supprime un en-tête, masque un mot de passe dans le corps et remplace un identifiant par son empreinte.
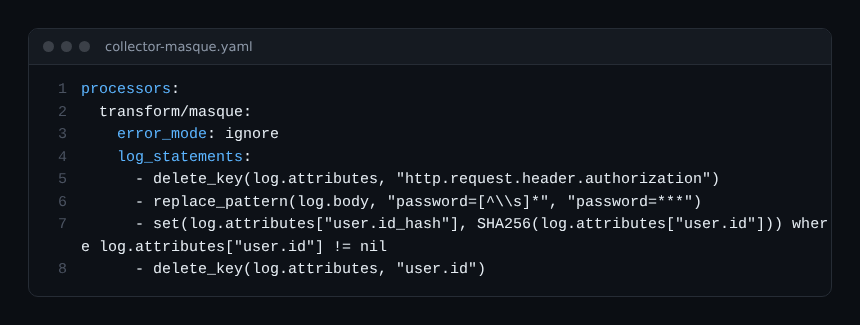
delete_keyretire l’attributhttp.request.header.authorization. C’est l’exemple de la documentation.replace_patternremplace toute séquencepassword=…du corps parpassword=***. Elle suppose un corps de type chaîne : sur un corps structuré, testez avant de compter dessus.setavecSHA256écrit l’empreinte deuser.iddans un nouvel attribut, seulement si l’attribut existe.- Le dernier
delete_keysupprime ensuite la valeur d’origine.
Attention au sens du mot « masquer ». Une empreinte SHA-256 permet de corréler les événements d’un même utilisateur sans voir son identifiant. Mais si l’identifiant est court ou prévisible, quelqu’un peut recalculer l’empreinte de chaque valeur possible. C’est un raisonnement général, pas une promesse de la documentation : pour des données réglementées, privilégiez la suppression.
Côté Dynatrace, le masquage existe aussi à l’ingestion, avec des fonctions propres à la plateforme, décrites dans l’article sur le masquage dans OpenPipeline. Les deux approches ne se mélangent pas : celle-ci agit dans le Collector, l’autre après l’arrivée des données.
Renommer : aligner les noms sur vos conventions
Renommer sert à une chose : que les mêmes données portent le même nom partout, par exemple pour respecter les conventions sémantiques. OTTL n’a pas d’éditeur « rename » dédié dans les extraits lus ; on combine deux gestes. On copie la valeur vers le nouveau nom, puis on supprime l’ancien. Pour un nom de métrique, replace_pattern agit directement sur metric.name.
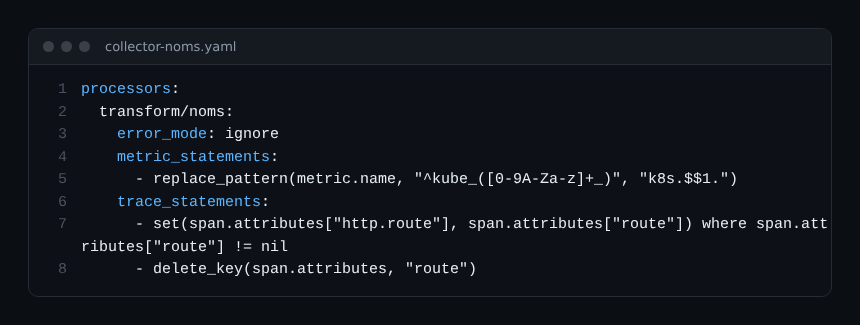
La première instruction vient du README : elle transforme kube_pod_… en k8s.pod…. Notez le $$1. Dans un fichier de configuration du Collector, le signe dollar sert à l’expansion des variables, d’où son doublement pour obtenir un groupe de capture. Sans cela, la référence est interprétée avant d’atteindre OTTL.
La seconde paire déplace l’attribut route vers http.route. L’ordre compte : l’instruction qui copie doit précéder celle qui supprime, sinon la valeur disparaît avant la copie. Les instructions s’exécutent dans l’ordre d’écriture.
La page d’opentelemetry.io présente aussi le processeur metricstransform, qui renomme des métriques et des étiquettes avec des correspondances par expression régulière. C’est une autre voie, avec sa propre syntaxe. Choisissez un seul outil par transformation, pour que le prochain lecteur sache où chercher.
Filtrer : jeter le bruit, mais pas n’importe comment
Le processeur filter utilise aussi OTTL, mais avec des conditions plutôt que des instructions. La règle de lecture est contre-intuitive : une condition qui est vraie fait supprimer la donnée. Plusieurs conditions d’une même liste sont combinées par un OU : il suffit qu’une seule corresponde. Dans une condition, and, or et les parenthèses sont permis.
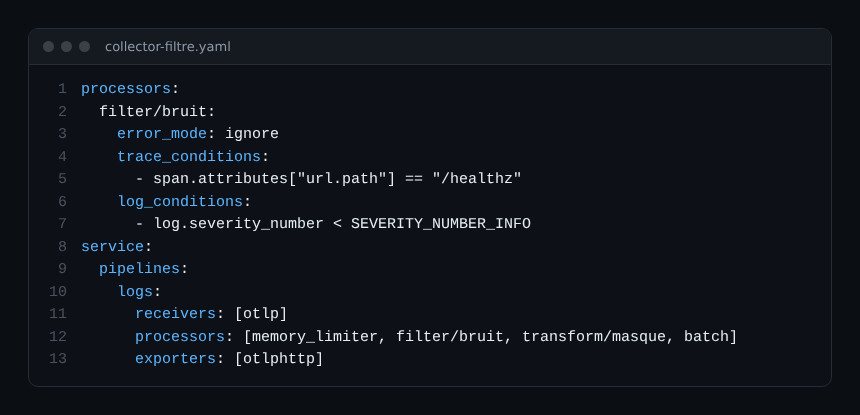
La configuration ci-dessus écarte les spans de /healthz et les logs sous le niveau INFO, puis place le filtre dans le pipeline. Le README du filtre signale plusieurs effets de bord :
- un span supprimé entraîne l’ignorance de ses conditions d’événements de span ;
- si tous les événements d’un span sont supprimés, le span reste ;
- si tous les points de données d’une métrique sont supprimés, la métrique l’est aussi ;
- supprimer des spans peut laisser des spans enfants ou des logs orphelins.
Autre nuance : le README décrit le format actuel (trace_conditions, log_conditions, metric_conditions) et indique que les anciennes options traces.*, metrics.* et logs.* sont dépréciées. La page d’opentelemetry.io montre encore l’ancienne forme. Pour décider quelles traces garder selon leur contenu global, le filtre ne convient pas : voyez les règles de tail sampling.
Mettre OTTL OpenTelemetry en production
Trois réglages évitent les mauvaises surprises.
- Choisir l’
error_mode. Les valeurs sontignore(défaut : l’erreur est journalisée, l’instruction suivante s’exécute),silent(sans journal) etpropagate(l’erreur remonte et le lot est abandonné). Pour un masquage,propagateest défendable : mieux vaut perdre un lot qu’exporter un secret. Un groupe d’instructions peut surcharger la valeur globale. - Ordonner les processeurs. Ils s’appliquent dans l’ordre du pipeline. Filtrez d’abord pour ne pas transformer ce qui sera jeté, masquez avant tout export.
- Activer le journal de debug pour comprendre un résultat. Avec
service.telemetry.logs.levelàdebug, le Collector affiche chaque instruction, si sa condition a correspondu et l’état du contexte après exécution.
Pour les cas plus riches, le format avancé du processeur transform regroupe des instructions avec un context, des conditions et un error_mode propres. Les instructions qui mélangent des chemins ou des fonctions incompatibles échouent au chargement : il faut alors les séparer en groupes. Le README donne l’exemple de convert_sum_to_gauge() avec un chemin datapoint.
Bonnes pratiques
- Ajoutez une condition
whereà chaque instruction pour ne traiter que les données concernées : le README le recommande pour la performance, et la page d’opentelemetry.io avertit que les transformations avancées peuvent la dégrader sensiblement. - Testez sur un pipeline de recette avec l’exportateur de debug avant la production.
- Gardez les règles de masquage dans un seul fichier versionné, relu comme du code.
- Mesurez avant et après : volume exporté, latence du pipeline, mémoire du Collector. Aucun chiffre n’est garanti ici.
- Évitez de dépendre de fonctions marquées expérimentales ; les signaux traces, métriques et logs sont stables dans le README, les profils sont en développement.
Questions fréquentes
OTTL remplace-t-il les processeurs attributes et resource ?
Pas forcément. Ces processeurs, présentés sur opentelemetry.io, couvrent des cas simples (insérer, mettre à jour, supprimer un attribut) avec une configuration déclarative. OTTL devient utile dès qu’il faut une condition, un calcul ou une expression régulière. Mélanger les deux sur le même champ complique la relecture.
Peut-on supprimer un span avec le processeur transform ?
Les sources lues ne décrivent pas de fonction de suppression dans transform : c’est le rôle du processeur filter. Je n’ai pas vérifié si une version récente l’autorise autrement ; la documentation de votre version fait foi.
Comment savoir pourquoi une instruction ne s’applique pas ?
Passez le niveau de journal du Collector à debug. Chaque instruction est affichée avec le résultat de sa condition. Vérifiez ensuite le préfixe de contexte du chemin : un chemin log sur un pipeline de traces ne fonctionnera pas.
Conclusion
OTTL OpenTelemetry tient en un schéma : une fonction, un chemin, une condition. Masquez ce qui ne doit pas quitter votre réseau, renommez pour aligner vos conventions, filtrez le bruit, et réglez error_mode selon le risque. Référence : le README du paquet OTTL et la page Transforming telemetry.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Les marques citées appartiennent à leurs propriétaires. Les exemples sont fictifs et n’ont pas été exécutés dans un Collector : vérifiez les options dans la documentation officielle de votre version.