
Votre alerte de latence p99 vient de se déclencher, le graphe Grafana montre un pic à 14 h 07, et la question d’astreinte est toujours la même : quelle requête a été lente ? Les exemplars Prometheus répondent exactement à cela. Ils attachent à un point de métrique l’identifiant d’une trace réelle, et vous passez du graphe à la trace OpenTelemetry en un clic.
Les faits viennent de la documentation Prometheus, de la spécification OpenMetrics et de la documentation Grafana, lues le 12 novembre 2026. Je n’ai pas monté de pile complète pour cet article : les captures rendent des fichiers d’exemple construits d’après ces pages, et ce que je n’ai pas vérifié est signalé.
Si les spans sont nouveaux pour vous, lisez d’abord l’anatomie d’un span OpenTelemetry. Les deux signaux se complètent : la métrique dit « quand et combien », la trace dit « laquelle ».
Le problème : une moyenne ne désigne aucune requête
Une métrique de latence agrège des milliers de requêtes en quelques compteurs. C’est précisément ce qui la rend peu coûteuse. Mais quand le p99 grimpe, vous devez retrouver une requête concrète, et la métrique l’a déjà oubliée.
Sans lien direct, on fait de l’archéologie : on note l’heure du pic, on ouvre l’outil de traces, on filtre par service et par durée, puis on espère que la bonne trace n’a pas été écartée par l’échantillonnage. Chaque minute passée là compte dans votre MTTR.
La décision d’exploitation est donc simple : acceptez-vous de stocker, à côté de vos séries, une poignée de références vers des traces ? C’est le principe d’un exemplar, et il a un coût mémoire précis, que nous chiffrons plus bas.
Exemplars Prometheus : ce que la spécification autorise
Un exemplar est une référence vers des données extérieures à la métrique, typiquement un identifiant de trace. La page des feature flags de Prometheus le rattache à OpenMetrics : ce format permet à une cible scrapée d’attacher des exemplars à certaines métriques.
La spécification OpenMetrics limite le périmètre. Elle autorise un exemplar sur les valeurs de bucket d’un histogramme et sur le total d’un compteur. Elle ne parle pas des jauges ni des summaries. Sur une ligne de texte, l’exemplar suit la valeur après un dièse, avec ses propres libellés et sa valeur observée.
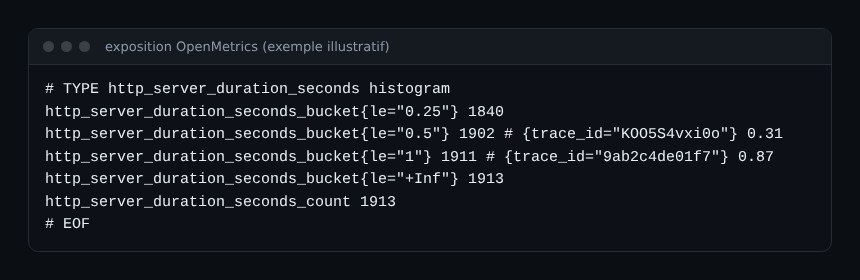
Une contrainte à connaître : la longueur cumulée des noms et des valeurs de libellés d’un exemplar ne doit pas dépasser 128 points de code UTF-8, d’après la spécification. Un identifiant de trace tient largement. En revanche, n’y glissez pas d’autres libellés « pour plus de contexte ».
Activer exemplar-storage sans surprise mémoire
Par défaut, Prometheus ne conserve pas les exemplars qu’il scrape. Il faut lancer le serveur avec --enable-feature=exemplar-storage. D’après la documentation, les exemplars vont alors dans un tampon circulaire en mémoire, de taille fixe, partagé par toutes les séries.
- Lancez Prometheus avec le feature flag
exemplar-storage. - Réglez la taille du tampon dans le bloc
storagepuisexemplarsde la configuration :max_exemplarsvaut 100 000 par défaut, d’après la page de configuration, et peut être modifié à chaud. - Vérifiez que vos cibles exposent bien des exemplars dans leur format de scrape.
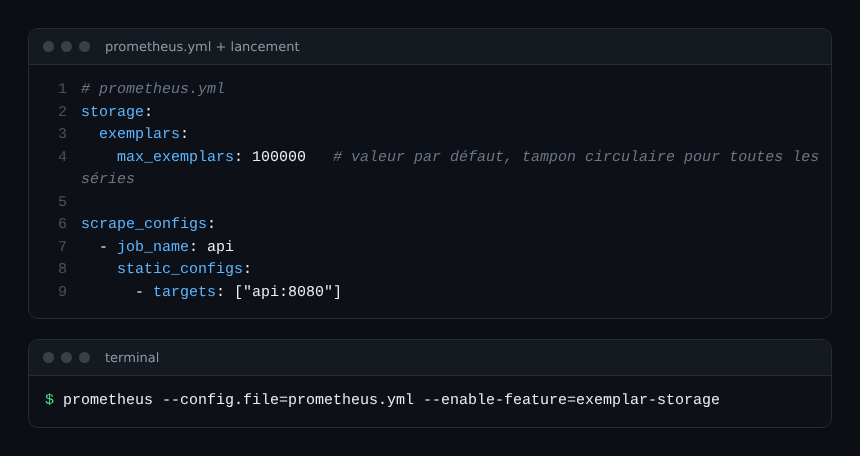
La documentation donne un ordre de grandeur : un exemplar qui ne contient que trace_id pèse environ 100 octets. À 100 000 entrées, cela fait de l’ordre de 10 Mo, soit mon calcul à partir de ce chiffre, pas une mesure. Le tampon étant circulaire, les plus anciens exemplars disparaissent d’abord. Sur une flotte bruyante, une fenêtre de quelques minutes seulement n’est pas exclue : à vérifier chez vous.
Autre point : toujours selon la même page, les exemplars sont aussi écrits dans le WAL, pour la persistance locale et pour la durée du WAL. Je n’ai pas lu le comportement avec le remote write : si vous envoyez vers un stockage distant, lisez la section correspondante, comme celle de Grafana Mimir pour le stockage des métriques Prometheus.
Interroger les exemplars avec l’API
Avant de configurer Grafana, vérifiez que Prometheus les a bien reçus. L’API HTTP propose le point d’entrée /api/v1/query_exemplars, en GET ou en POST, marqué expérimental dans la documentation. Il prend une requête PromQL et une fenêtre start / end.
La réponse liste, pour chaque série, ses seriesLabels puis un tableau exemplars. Chaque exemplar contient ses labels (par exemple trace_id), une value et un timestamp en secondes Unix. Si ce tableau est vide, inutile d’aller plus loin : le problème est en amont, côté exposition ou côté feature flag.
Du graphe à la trace OTel dans Grafana
Dans Grafana, un exemplar s’affiche comme une étoile sur le graphe. Au survol, on lit l’identifiant de trace, et un bouton ouvre la trace dans la source de données de traces, Tempo dans l’exemple de la documentation. Le support des exemplars n’est annoncé que pour la source de données Prometheus.
La liaison se déclare dans la source Prometheus. Le champ Label name indique la clé du libellé qui porte l’identifiant, et un lien interne désigne la source de traces. En provisioning, cela donne ceci.
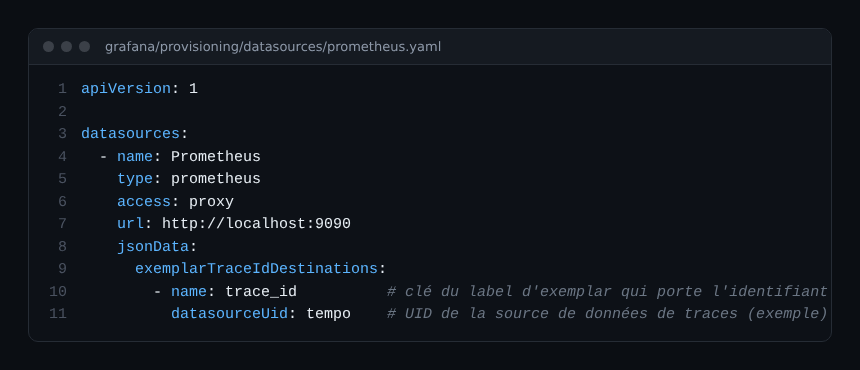
Si vous n’avez pas encore de backend de traces, notre article sur Grafana Tempo avec kube-prometheus-stack décrit une installation. Le point de vigilance est ailleurs : l’identifiant doit être le même des deux côtés. C’est le cas quand l’application lit le trace_id du span OpenTelemetry actif au moment où elle enregistre la durée.
Le piège de l’échantillonnage
Voici le cas qui piège le plus souvent. Votre exemplar pointe vers une trace que le tail sampling a jetée : le clic mène à une page « introuvable ». L’exemplar est enregistré par l’application, la décision de conserver la trace est prise plus loin dans le pipeline.
Deux remèdes, à arbitrer selon votre budget. Conservez systématiquement les traces lentes et en erreur, comme le montrent les règles de tail sampling du Collector. Ou n’enregistrez un exemplar que lorsque la trace est marquée comme échantillonnée : je n’ai pas vérifié que votre bibliothèque cliente le propose, regardez sa documentation.
Bonnes pratiques
- Commencez par la latence d’un service critique, sur un histogramme, pas sur tout le parc.
- Gardez
trace_idcomme seul libellé d’exemplar : la limite est de 128 caractères. - Contrôlez avec
query_exemplarsavant d’accuser Grafana. - Gardez les traces lentes dans le tail sampling, sinon l’étoile mène nulle part.
- Notez dans le runbook : « pic p99, survoler les étoiles, ouvrir la trace la plus lente ».
Questions fréquentes
Les exemplars fonctionnent-ils avec n’importe quelle métrique ?
Non. La spécification OpenMetrics les prévoit pour les buckets d’histogramme et le total d’un compteur. Elle ne les décrit pas pour les jauges.
Combien de mémoire coûtent les exemplars ?
La documentation donne environ 100 octets pour un exemplar réduit à un trace_id, dans un tampon de taille fixe réglé par max_exemplars (100 000 par défaut). Mesurez chez vous avant de changer cette valeur.
Et si j’utilise Dynatrace ?
Cet article ne traite que de Prometheus, Grafana et OpenMetrics. Pour le lien entre métriques et traces dans Dynatrace, consultez docs.dynatrace.com en distinguant SaaS et Managed : je n’en mélange aucune fonction ici. Pour comparer les approches, voyez OpenTelemetry et Prometheus.
Conclusion
Les exemplars Prometheus transforment un pic de latence en une liste de traces candidates, pour quelques mégaoctets de mémoire. Activez le feature flag, vérifiez avec l’API, déclarez la liaison dans Grafana, puis protégez vos traces lentes de l’échantillonnage. Sources : feature flags Prometheus, spécification OpenMetrics, exemplars dans Grafana.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni à Grafana Labs ou à la Prometheus Authors. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans la documentation officielle.