
Votre SLO de latence dit « 99 % des requêtes sous 200 ms », et vos buckets ont été choisis il y a deux ans : 0,1 ; 0,25 ; 0,5 ; 1. Personne ne se souvient pourquoi. Les histogrammes natifs Prometheus retirent cette décision du code : la résolution se règle à la collecte, pas à l’instrumentation. Cet article part de ce choix d’exploitation, puis regarde ce qui change pour la cardinalité, les percentiles et les SLO.
Les faits viennent de la spécification et de la documentation officielles de Prometheus, lues le 12 novembre 2026. Je n’ai pas fait tourner de banc d’essai : tout gain de stockage ou de CPU que je ne peux pas citer est signalé comme non vérifié. Ici, il n’est question que de Prometheus et de son écosystème libre.
Pour le versant cardinalité en général, voyez l’article sur les séries qui explosent ; ici, on ne traite que ce que les histogrammes y changent.
Le problème : des buckets figés avant d’avoir vu le trafic
Un histogramme classique est un jeu de séries : une série _bucket par borne le, plus _sum et _count. Vous fixez les bornes dans le code. Trop peu, et le percentile devient grossier. Trop, et chaque borne multiplie les séries, puis chaque label (route, code, pod) multiplie encore le tout.
Le plus gênant : ces bornes ne se changent pas à chaud. Corriger un mauvais découpage demande un déploiement, et l’historique avant le changement n’est plus comparable. Le percentile, lui, est une estimation : Prometheus interpole à l’intérieur du bucket qui contient le quantile.
Ce que fait un histogramme natif
Un histogramme natif est exposé et stocké comme un seul échantillon structuré : compte, somme et ensemble dynamique de buckets. Plus de série par borne. Les bornes suivent une progression géométrique fixée par un entier, le schema.
- Pour un schema standard
n, la borne haute du bucketivaut(2^(2^-n))^i. Chaque bucket est donc le précédent multiplié par un facteur constant. - Les schemas standard vont de -4 à +8 ; le schema -53 est réservé aux buckets personnalisés (voir plus bas). Le schema
na la moitié de la résolution du scheman+1, ce qui permet de fusionner deux buckets voisins pour réduire la résolution sans perdre de données. - Les buckets vides ne coûtent rien : la représentation est creuse, et couvre toute la plage d’un float64.
- Un bucket « zéro » recueille les valeurs nulles ou très proches de zéro (seuil par défaut côté instrumentation : 2^-128).
Voici le calcul sur un cas concret, une latence entre 1 ms et 10 s. Le script est un calcul maison à partir de la formule ci-dessus, exécuté pour cet article ; l’« erreur relative max » est mon estimation, pas un chiffre de la documentation.
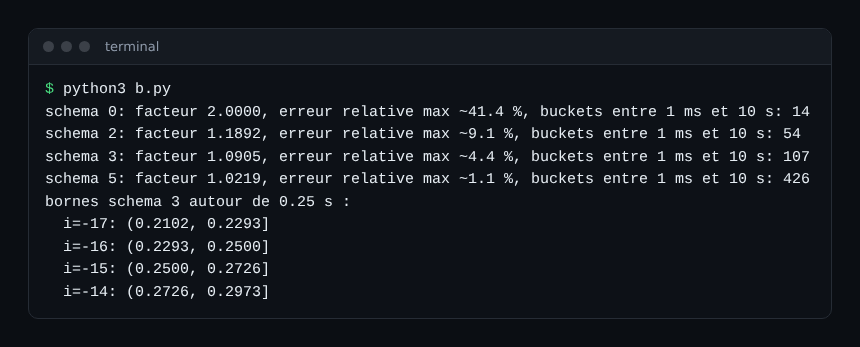
Lecture : au schema 3 (facteur 1,09), couvrir toute la plage demande au plus 107 buckets, et seuls ceux qui reçoivent des observations existent. Une latence réelle en occupe une fraction. Un tel découpage à la main, avec des bornes classiques, ne se fait quasiment jamais.
Histogrammes natifs Prometheus et cardinalité : ce qui change vraiment
Deux effets, à ne pas confondre avec le sujet de la cardinalité en général.
- Le label
ledisparaît. Un histogramme classique de 12 bornes produit 14 séries par combinaison de labels (12 buckets,_sum,_count). L’histogramme natif en produit une. Ce décompte est arithmétique ; le gain réel en mémoire et en disque dépend de vos données, et je n’ai pas de mesure à citer. - Les labels métier restent votre problème. Si vous ajoutez
user_idà un histogramme, vous créez toujours une série par utilisateur, natif ou non.
Prometheus propose aussi des garde-fous. native_histogram_bucket_limit plafonne le nombre de buckets par histogramme : au-delà, la résolution baisse pour les schemas standard. native_histogram_min_bucket_factor impose un facteur minimal. Côté bibliothèque cliente, la spécification recommande un nombre maximal de buckets, avec 160 comme valeur typique citée.
Activer la collecte sans casser l’existant
Le calendrier compte : fonctionnalité expérimentale à partir de la v2.40.0 (novembre 2022), stable depuis la v3.8.0 selon la spécification. La collecte exige scrape_native_histograms ; sur la v4, la documentation indique qu’il passe à true par défaut, de même que send_native_histograms pour le remote write. Ne comptez pas sur ce futur défaut : écrivez l’option.
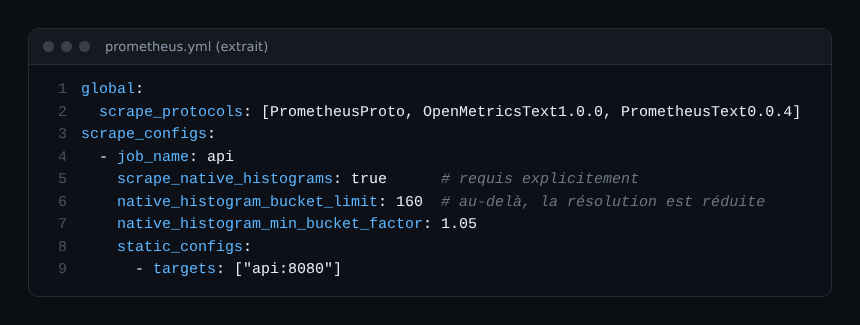
Deux points d’attention :
- Les histogrammes natifs ne voyagent qu’en protobuf ; le format texte n’est pas étendu. Activer l’option change donc la négociation vers le protobuf. La documentation note que les scrapes texte sont en général bien moins gourmands en ressources que les scrapes protobuf : mesurez sur vos cibles.
- Par défaut, Prometheus préfère la partie native à la partie classique.
always_scrape_classic_histograms(faux par défaut) conserve les deux pendant la migration, au prix des séries en double.
Les bibliothèques clientes concernées sont, d’après la documentation sur les types de métriques, Go et Java. Pour les autres langages, vérifiez l’état de votre bibliothèque avant de planifier.
Percentiles : exacts ? Non, mais mieux répartis
La requête change peu, et la clause le disparaît. Voici les deux formes côte à côte, reprises des exemples de la documentation et adaptées à mon nom de métrique.
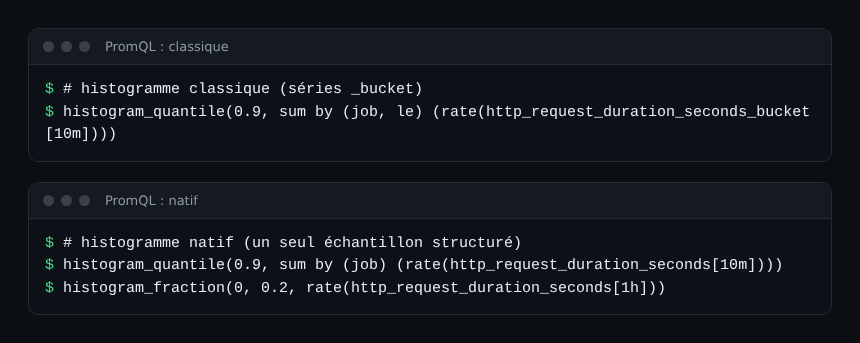
Sur un histogramme natif à buckets standard, histogram_quantile interpole de façon exponentielle à l’intérieur du bucket, c’est-à-dire comme si les observations remplissaient un histogramme de résolution plus fine. Les histogrammes classiques et les buckets personnalisés utilisent une interpolation linéaire. La documentation ne donne pas de borne d’erreur chiffrée pour cette fonction. Mon estimation : avec un facteur de 1,09, l’écart relatif maximal est de l’ordre de 4 % au pire ; c’est un calcul, pas une garantie.
Et quand vous avez déjà des histogrammes classiques à bornes inadaptées ? Le paramètre convert_classic_histograms_to_nhcb les convertit à l’ingestion en buckets personnalisés (schema -53). Ils gardent leurs bornes, ne sont pas fusionnables entre elles quand elles diffèrent, et un dépassement de native_histogram_bucket_limit fait échouer le scrape. C’est un pont, pas une cible.
SLO de latence : le seuil n’est plus une borne
Avec un histogramme classique, un SLO « sous 200 ms » se calcule proprement seulement si le="0.2" existe. C’est la raison pour laquelle on ajoute des bornes aux seuils d’engagement. Avec un histogramme natif, la fonction histogram_fraction(0, 0.2, …) donne la part des observations entre 0 et 0,2 s, même si 0,2 n’est pas une borne.
Attention : si 0,2 tombe au milieu d’un bucket, le résultat est interpolé. La documentation précise que l’erreur dépend de la résolution de l’histogramme. Au schema 3, les bornes autour de 0,25 s sont 0,2293 ; 0,2500 ; 0,2726 ; 0,2 n’en est pas une. Pour un SLO contractuel, gardez donc un schema assez fin et vérifiez l’écart sur un échantillon connu avant de basculer vos alertes.
Pour la mise en place des règles qui précalculent ces ratios, voir les recording rules Prometheus. Si vous comparez avec la manière dont d’autres plateformes agrègent les distributions, l’article sur les histogrammes et OpenPipeline traite un autre outil ; je ne mélange pas les deux ici. Pour situer Prometheus par rapport à OpenTelemetry, lisez ce comparatif.
Bonnes pratiques
- Migrez un service à la fois, avec
always_scrape_classic_histogramsle temps de comparer les percentiles. - Posez un
native_histogram_bucket_limitpour borner la mémoire. - Réécrivez les dashboards et alertes :
histogram_quantilesansle,histogram_fractionpour les SLO. - Gardez les labels à faible cardinalité : l’histogramme natif ne les protège pas.
- Vérifiez la prise en charge du stockage distant (remote write, backend long terme) avant de migrer : je ne l’ai pas vérifiée pour chaque backend.
Questions fréquentes
Les histogrammes natifs Prometheus remplacent-ils les histogrammes classiques ?
Pas immédiatement. La documentation recommande de les préférer quand la bibliothèque les gère, mais les deux coexistent, et la conversion en buckets personnalisés existe pour la transition.
Faut-il encore choisir des buckets ?
Plus à l’instrumentation : on choisit un facteur de croissance et un plafond de buckets. Le facteur par défaut est 1,1 côté instrumentation. Les buckets personnalisés restent possibles, avec leurs limites de fusion.
Mon percentile sera-t-il plus précis ?
Cela dépend du schema et de vos données. La résolution est généralement bien plus fine qu’avec une douzaine de bornes manuelles, mais la documentation ne chiffre pas l’erreur : testez sur vos propres distributions.
Conclusion
Les histogrammes natifs déplacent une décision du code vers la configuration : vous réglez une résolution et un plafond, plus une liste de bornes. La cardinalité des buckets disparaît, pas celle des labels, et les SLO gagnent en souplesse au prix d’une interpolation à surveiller. Sources : spécification des histogrammes natifs, fonctions PromQL.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni au projet Prometheus. Les marques citées appartiennent à leurs propriétaires. Les versions et options évoluent vite : vérifiez-les dans la documentation officielle.