Le Sensitive Data Scanner Datadog repère les données personnelles dans vos logs et les masque avant qu’elles ne soient lisibles. Pour une équipe SRE ou plateforme, c’est un garde-fou concret : un e-mail, un numéro de carte ou un jeton qui s’échappe dans un message d’erreur n’a rien à faire dans un outil que toute l’équipe consulte.
Ce tutoriel suit la documentation officielle de Datadog, consultée le 30 octobre 2026. Il couvre la création d’un groupe de scan, d’une règle, le choix de l’action (masquer, hacher), puis les limites de la syntaxe regex. Aucun prix n’est repris ici : consultez la page officielle de Datadog pour les conditions commerciales.
Sensitive Data Scanner Datadog : ce qu’il fait
D’après la documentation, le Sensitive Data Scanner (SDS) découvre, classe et, au choix, masque des données sensibles : PII, identifiants, numéros de carte. Pour la télémétrie, il couvre les logs, les spans APM, les événements RUM et les événements Datadog. Les logs peuvent être scannés dans le cloud Datadog, ou dans votre environnement avec Observability Pipelines.
Deux notions structurent l’outil :
- un scanning group définit quelles données scanner (une requête de filtre, des produits, un taux d’échantillonnage) ;
- des scanning rules définissent ce qu’il faut y trouver : règles de la bibliothèque (e-mails, cartes bancaires, clés d’API, jetons d’autorisation…) ou règles personnalisées en regex.
Prérequis de permissions, selon la page de configuration : le rôle Datadog Admin suffit par défaut. Sinon, un rôle personnalisé reçoit data_scanner_read (lecture) ou data_scanner_write (configuration) dans la section Compliance. La permission Data Scanner Unmask sert à lire les valeurs cachées par l’action Mask.
Étape 1 : créer un groupe de scan
- Ouvrez la page de réglages du Sensitive Data Scanner et cliquez sur Add scanning group.
- Saisissez une requête de filtre. L’aperçu « Logs » ou « APM Spans » montre les données concernées.
- Donnez un nom et une description.
- Activez les produits à scanner : Logs, APM spans, RUM events, Datadog events.
- Option : fixez un taux d’échantillonnage de 10 % à 99 % par produit.
- Cliquez sur Create, puis activez l’interrupteur du groupe : un nouveau groupe démarre désactivé.
Point d’attention : la documentation indique qu’un groupe échantillonné ne peut pas utiliser les actions de masquage. Pour des données sensibles, ne mettez donc pas d’échantillonnage : un scan partiel laisserait passer des valeurs en clair. Le masquage avec OpenPipeline côté Dynatrace suit la même logique : agir avant le stockage, sur tout le flux.
Étape 2 : ajouter une règle et choisir l’action
Ouvrez le groupe, cliquez sur Add Scanning Rule, puis choisissez une règle de bibliothèque ou une règle personnalisée. Pour une règle de bibliothèque, vous réglez la Priority, sélectionnez les règles dans « Add Library Rules », puis l’Action on Match. Pour une règle personnalisée, vous saisissez en plus une regex dans « Match conditions » et vous la testez sur un échantillon avant de valider.
L’option « Action on Match » demande aussi la portée : Entire Event (avec exclusion possible d’attributs) ou Specific Attributes (liste des attributs à scanner). Dans les chemins d’attributs, la documentation demande de ne pas écrire le préfixe @.
Redact, Partially Redact, Hash ou Mask ?
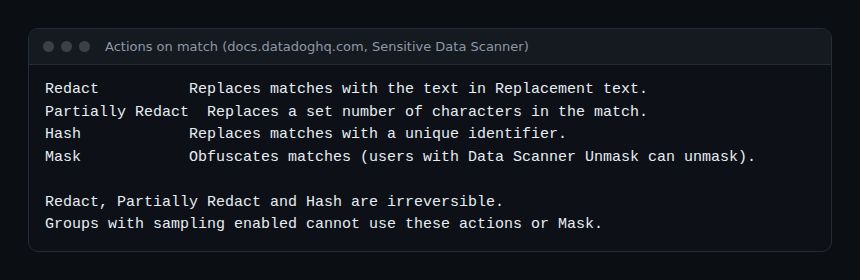
- Redact remplace la valeur par le texte de votre choix. Simple et lisible :
[EMAIL]dans un log se comprend tout de suite. - Partially Redact remplace un nombre de caractères que vous choisissez, sur la partie de la valeur que vous désignez. Utile pour ne garder visible qu’un fragment.
- Hash remplace la valeur par un identifiant unique. Le remplacement est irréversible : la donnée d’origine n’est plus lisible.
- Mask masque la valeur, mais les utilisateurs qui ont
Data Scanner Unmaskpeuvent la révéler. La page de présentation donne Mask disponible pour les logs, l’APM et le RUM, mais pas pour les événements.
Redact, Partially Redact et Hash sont irréversibles, précise la documentation. C’est ce qu’on veut pour une donnée qui ne doit plus exister en clair. Mask convient quand quelques personnes habilitées doivent pouvoir relire la valeur.
Enfin, ajoutez des tags aux événements qui ont une correspondance. Datadog recommande sensitive_data et sensitive_data_category ; ils permettent ensuite de chercher et de compter les fuites évitées.
Étape 3 : écrire une règle regex avec les limites de PCRE
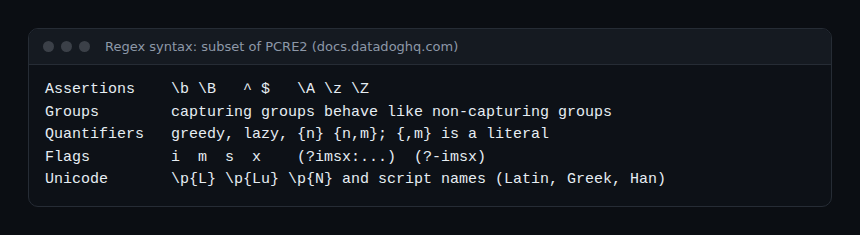
La page de syntaxe indique que la regex du SDS est « un sous-ensemble de PCRE2 ». Les familles prises en charge sont l’alternance, les assertions, les classes de caractères, les groupes, les quantificateurs, les drapeaux et les propriétés Unicode.
Voici ce que la documentation dit, et ce qu’elle ne dit pas :
- Côté assertions, seuls les repères de mot (
\b,\B) et les ancres de ligne et de texte sont listés. Le lookaround ((?=,(?<=) n’est donc pas décrit comme pris en charge. - Les groupes de capture se comportent comme des groupes non capturants et leurs noms sont ignorés. Une référence arrière (backreference) n’a donc pas de sens ici.
- La forme
{,m}est lue comme du texte littéral, et des espaces dans les accolades font aussi du quantificateur un littéral.
Le point sur le lookaround et les références arrière n’est pas écrit noir sur blanc comme « non pris en charge » : la page ne les liste simplement pas. Considérez-les comme indisponibles, et testez votre regex dans le champ d’échantillon de l’interface avant de la déployer. Ce point reste à confirmer côté produit.
Exemple de règle personnalisée, écrit par span.observer pour illustrer la syntaxe (non repris de la documentation). Pour repérer un identifiant client de la forme CLI- suivi de huit chiffres, sans lookaround :
\bCLI-[0-9]{8}\bAjoutez ensuite des mots-clés proches pour réduire les faux positifs. Selon la page de configuration, une règle accepte jusqu’à 20 mots-clés, qui doivent apparaître dans les 30 caractères avant la correspondance par défaut.
Limites à connaître
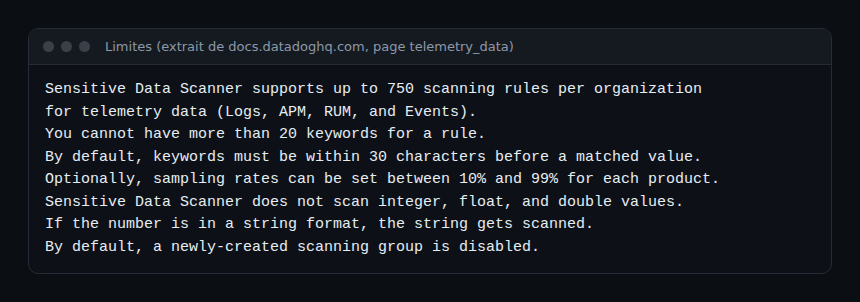
Deux limites surprennent souvent. D’abord, les valeurs entières, flottantes et doubles ne sont pas scannées ; les nombres écrits sous forme de chaîne le sont. Un numéro de carte stocké comme entier dans un attribut JSON échappe donc au scan, alors qu’il est détecté s’il est en chaîne. Ensuite, pour les logs, les notifications d’alerte contiennent le contexte de la détection et un lien, sans extrait de log.
Comment vérifier que ça fonctionne
- Envoyez un log de test avec une fausse valeur (jamais une vraie donnée) qui correspond à votre règle.
- Ouvrez le log dans le Log Explorer : la valeur doit apparaître remplacée.
- Filtrez sur le tag
sensitive_datapour compter les événements touchés.
Lien avec OpenTelemetry et Dynatrace
Le masquage dans le backend est un dernier filet. Si vos logs passent par un Collector OpenTelemetry, un traitement en amont retire la donnée avant l’envoi : voyez notre guide du Collector OpenTelemetry sur Kubernetes et celui du Collector Datadog (DDOT). Pour comparer les approches, le comparatif Dynatrace et Datadog replace les deux outils dans un contexte SRE. Aucune intégration entre le SDS et Dynatrace n’est documentée ici.
Bonnes pratiques
- Masquez le plus tôt possible : au Collector d’abord, au SDS en filet de sécurité.
- Pas d’échantillonnage sur un groupe qui protège des données sensibles.
- Testez chaque regex sur un échantillon et évitez ce que la syntaxe ne liste pas.
- Gardez Mask pour les besoins d’investigation, Redact ou Hash pour le reste.
- Suivez le tag
sensitive_datadans un dashboard : une hausse signale un défaut de code à corriger.
Questions fréquentes
Le Sensitive Data Scanner Datadog supporte-t-il le lookaround ?
La documentation décrit la syntaxe comme un sous-ensemble de PCRE2 et ne liste que les repères de mot et les ancres comme assertions. Le lookaround n’y figure pas : non vérifié comme pris en charge, testez avant usage.
Quelle différence entre Redact et Hash ?
Redact remplace la valeur par le texte de votre choix. Hash la remplace par un identifiant unique. Les deux sont irréversibles, d’après la documentation.
Peut-on scanner autre chose que les logs ?
Oui : spans APM, événements RUM et événements Datadog. La documentation mentionne aussi des traces d’observabilité d’agents IA, des buckets S3 (détection seule, sans masquage) et des dépôts de code.
Conclusion
Un groupe de scan sans échantillonnage, une règle de bibliothèque, une action irréversible et un tag de suivi : cette base couvre déjà la plupart des fuites courantes dans les logs. Ajoutez ensuite des regex personnalisées, en restant dans le sous-ensemble de PCRE2 décrit par Datadog.
Blog indépendant, non affilié à Dynatrace LLC ni à Datadog Inc. Les informations proviennent de la documentation officielle de Datadog consultée le 30 octobre 2026 ; aucun prix n’est repris. Sources : Sensitive Data Scanner, configuration pour la télémétrie, règles personnalisées.