


Browsing Tag
GPU
13 posts

Modelo MoE local: lo que Colibri le pide a tu disco
Modelo MoE local con Colibri: RAM, disco NVMe, velocidades publicadas y supervisión con /metrics. Lo que dice el README antes de bajar 400 GB.

vLLM inferencia de LLM: instalar y supervisar el servidor
vLLM inferencia de LLM: instalación según la documentación, arquitectura, métricas de servicio (cola, caché KV, TTFT) y trazas OpenTelemetry.
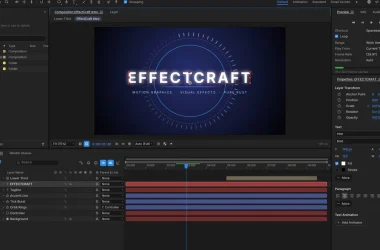
EffectCraft motion graphics de código abierto: visita y límites
EffectCraft, motion graphics de código abierto en Rust: licencia, capturas, instalación según el README, límites de la alfa y mediciones en el equipo.
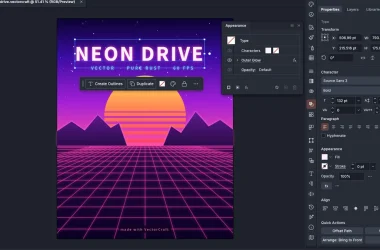
VectorCraft dibujo vectorial de código abierto: visita y límites
VectorCraft, dibujo vectorial de código abierto en Rust: licencia, capturas, instalación según el README, límites de la alfa y mediciones en el equipo.
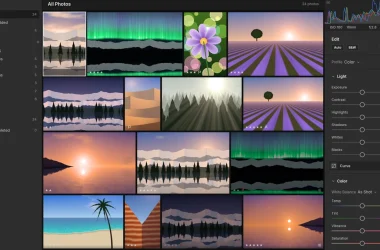
LightCraft retoque fotográfico no destructivo: lo esencial
LightCraft, retoque fotográfico no destructivo en Rust: licencia, capturas, instalación según el README, límites de la alfa y mediciones en el equipo.
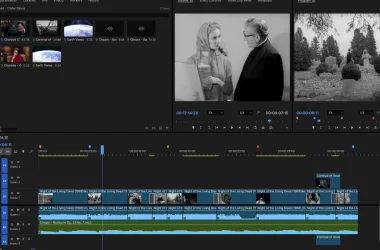
FilmCraft editor de video de código abierto: visita y límites
FilmCraft, editor de video de código abierto en Rust: licencia, capturas, instalación según el README, límites de la alfa y mediciones en el equipo.
Comparativa de LLM de código abierto: licencia, tamaño, VRAM y rendimiento medido en vLLM y Ollama
Comparativa de LLM de código abierto: licencia, parámetros, memoria de GPU y etiquetas de Ollama de 8 modelos, y cómo medir el rendimiento en vLLM.
Mistral Large 4 autoalojado: qué está publicado, dimensionamiento y monitorización
Mistral Large 4 en autoalojamiento: pesos aún sin publicar, memoria necesaria para 1 billón de parámetros y monitorización de vLLM con varias GPU.
Stack de IA autoalojada de código abierto: comparativa de los componentes de una infraestructura de IA propia
Comparativa de una stack de IA autoalojada de código abierto: Ollama, vLLM, Open WebUI, LlamaIndex, CrewAI, Dify, n8n, Langfuse y combinaciones.
llama.cpp: inferencia local en CPU y GPU, modelos GGUF y servidor HTTP integrado
Compila llama.cpp, sirve un modelo GGUF en CPU o GPU con llama-server compatible con OpenAI y monitorízalo: salud, métricas de Prometheus y logs.