Esta comparativa de LLM de código abierto reúne, para ocho modelos de pesos abiertos, las características que deciden un despliegue: licencia, número de parámetros, memoria de GPU anunciada por el editor, tamaño de descarga en Ollama y comando de servicio en vLLM. Cada valor procede de la ficha oficial del modelo en Hugging Face, de la biblioteca de Ollama o del sitio del editor, consultados en octubre de 2026. Lo que no figura en ellos no se escribe.
No contiene cifras de rendimiento. Los rendimientos publicados dependen de la GPU, de la cuantización, de la longitud de las peticiones y de la concurrencia: no se trasladan de un entorno a otro. La segunda parte muestra cómo medir tú mismo el rendimiento y la latencia con vllm bench serve y la API de Ollama, en tu hardware.
Para el método de elección con criterios de explotación (latencia, RGPD, coste por tarea), consulta elegir tu LLM. Para la arquitectura que rodea al modelo, consulta la stack de IA de código abierto autoalojada.
Comparativa de LLM de código abierto: la tabla
| Modelo | Licencia | Parámetros | Memoria indicada por el editor | Ollama: etiqueta, tamaño, contexto |
|---|---|---|---|---|
| gpt-oss-20b (OpenAI) | Apache 2.0 | 21 mil millones, 3,6 mil millones activos | cabe en 16 GB de memoria (MXFP4) | gpt-oss:20b, 14 GB, 128K |
| gpt-oss-120b (OpenAI) | Apache 2.0 | 117 mil millones, 5,1 mil millones activos | una sola GPU de 80 GB (H100 o MI300X) | gpt-oss:120b, 65 GB, 128K |
| Qwen3-8B (Alibaba Qwen) | Apache 2.0 | 8,2 mil millones | no indicada | qwen3:8b, 5,2 GB, 40K |
| Qwen3-30B-A3B (Alibaba Qwen) | Apache 2.0 | 30,5 mil millones, 3,3 mil millones activados | no indicada | qwen3:30b, 19 GB, 256K |
| Mistral Small 3.2 24B (Mistral AI) | Apache 2.0 | 24 mil millones | unos 55 GB en bf16 o fp16 | mistral-small3.2:24b, 15 GB, 128K |
| Ministral 3 8B (Mistral AI) | Apache 2.0 | 8,9 mil millones (pesos publicados) | cabe en 12 GB de VRAM en FP8 | ministral-3:8b, 6,0 GB, 256K |
| Gemma 3 27B (Google) | Gemma Terms of Use | 27,4 mil millones (pesos publicados) | no consultada (ficha de acceso controlado) | gemma3:27b, 17 GB, 128K |
| Llama 3.3 70B (Meta) | Llama 3.3 Community License | 70,6 mil millones (pesos publicados) | no consultada (ficha de acceso controlado) | llama3.3:70b, 43 GB, 128K |
Cómo leer la tabla:
- Parámetros: valor de la ficha del modelo; cuando la ficha no lo da, total de los pesos publicados que indica Hugging Face. «Activos» se refiere a los modelos de mezcla de expertos (MoE), que solo utilizan una parte de sus pesos por token.
- Tamaño en Ollama: tamaño de la descarga de la etiqueta por defecto, ya cuantizada. En Mistral Small 3.2, la etiqueta por defecto corresponde a la variante
q4_K_M. La columna de contexto recoge la ventana que muestra Ollama para esa etiqueta. - Acceso controlado: las fichas de Gemma 3 y Llama 3.3 exigen aceptar la licencia en Hugging Face antes de la descarga.
Licencia: qué cambia en producción
Seis de los ocho modelos tienen licencia Apache 2.0: uso comercial, modificación y redistribución permitidos, siempre que se conserven la licencia y las menciones. La ficha de gpt-oss la presenta como una licencia permisiva «sin restricción copyleft ni riesgo de patentes». Gemma 3 y Llama 3.3 tienen licencias propias del editor, con sus condiciones de uso: haz que las revise tu departamento jurídico antes de cualquier despliegue, sobre todo para un producto distribuido a clientes.
Tamaño y memoria de GPU: estimar antes de comprar
Solo tres fichas dan una necesidad de memoria explícita: gpt-oss (16 GB para 20b, una GPU de 80 GB para 120b, gracias a la cuantización MXFP4 de los pesos MoE), Mistral Small 3.2 (unos 55 GB en bf16/fp16) y Ministral 3 8B (12 GB de VRAM en FP8). Para los demás se puede calcular un orden de magnitud: en bf16, cada parámetro ocupa 2 bytes, así que un modelo de 8 mil millones de parámetros pesa unos 16 GB solo en pesos. La cifra de Mistral Small 3.2 (24 mil millones de parámetros, unos 55 GB) muestra el margen que hay que prever más allá de los pesos: caché KV, activaciones, contexto largo.
Los modelos MoE engañan con frecuencia: Qwen3-30B-A3B solo activa 3,3 mil millones de parámetros por token, pero los 30,5 mil millones deben caber en memoria. La ganancia está en el cálculo, no en la VRAM.
La ventana de contexto también pesa. La ficha de Qwen3-8B indica 32 768 tokens de forma nativa y 131 072 con YaRN, y precisa que este modo no se recomienda si tus contextos se mantienen por debajo de 32 768 tokens, porque puede degradar el rendimiento.
Medir el rendimiento en vLLM y Ollama
Paso 1: servir el modelo
# vLLM : serveur compatible avec l'API OpenAI (commande des fiches gpt-oss)
vllm serve openai/gpt-oss-20b

# Ollama
ollama pull gpt-oss:20b
ollama run gpt-oss:20b
Las fichas de gpt-oss, Qwen3 y Mistral Small 3.2 dan cada una su comando vllm serve. La ficha de Qwen3-8B activa el razonamiento con --enable-reasoning --reasoning-parser deepseek_r1: un parámetro que cambia el número de tokens producidos y, por tanto, el rendimiento aparente.
Paso 2: medir con vllm bench serve
vLLM ofrece una herramienta de medición en el lado del cliente. Su guía muestra el resultado esperado:
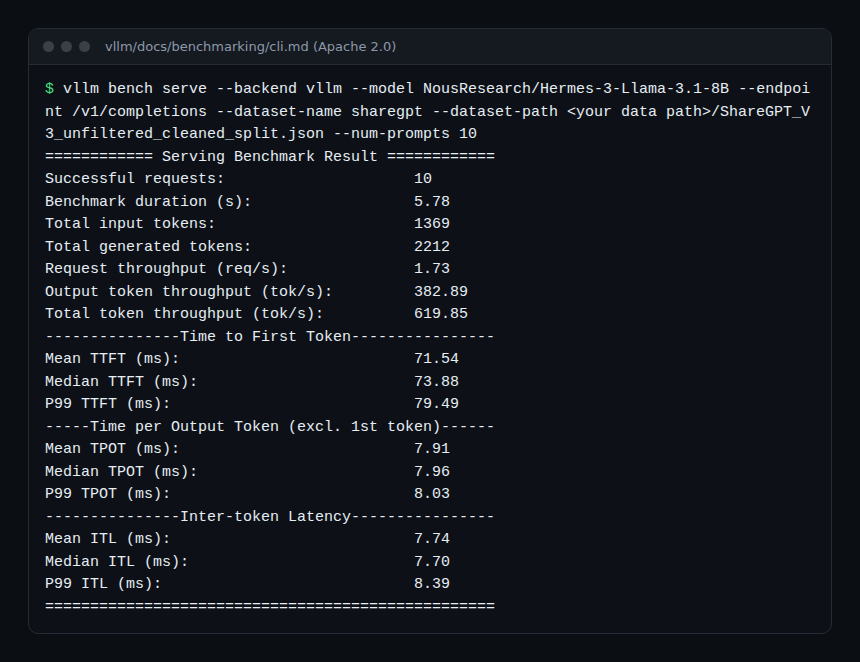
Las líneas que conviene comparar entre modelos son Output token throughput (tok/s), P99 TTFT (ms) y P99 ITL (ms). Los valores de la imagen son los del ejemplo de la documentación, con otro modelo: ilustran el formato, no un rendimiento. La documentación advierte de que repetir la medición contra el mismo servidor puede reutilizar la caché de prefijos e inflar el rendimiento: cambia --seed, reinicia el servidor o usa vllm bench sweep serve. También recomienda GuideLLM para los servidores de producción.
Paso 3: medir con la API de Ollama
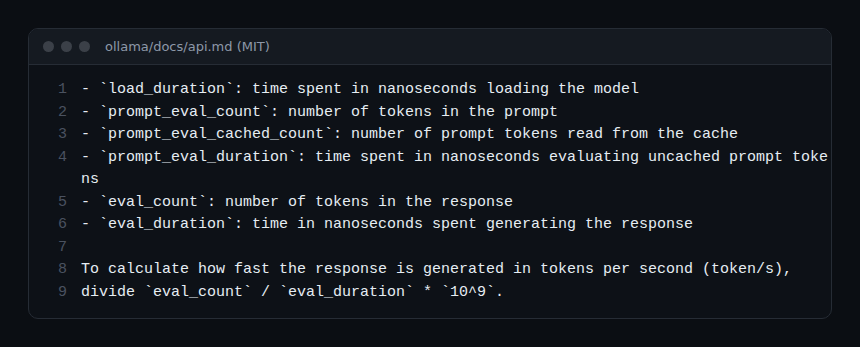
La respuesta final de la API de Ollama contiene duraciones en nanosegundos y contadores de tokens:
curl -s http://localhost:11434/api/generate \
  -d '{"model": "gpt-oss:20b", "prompt": "Résume la RFC 9110 en trois lignes.", "stream": false}' \
  | jq '.eval_count / .eval_duration * 1e9'
La fórmula es la de la documentación de Ollama: eval_count / eval_duration × 10^9 da los tokens generados por segundo. Mide en frío y en caliente: load_duration muestra el tiempo de carga del modelo, que pesa mucho en la primera petición.
Cómo comprobar que la comparación es justa
- Misma GPU, misma cuantización, misma longitud de entrada y de salida para todos los modelos.
- Varios niveles de concurrencia (
--max-concurrency): un modelo rápido en solitario puede hundirse con 32 peticiones simultáneas. - El modo de razonamiento activado o no de la misma forma en los modelos que lo ofrecen.
- En producción, las métricas de Prometheus de vLLM confirman las mediciones: consulta vLLM en producción y, para Ollama, la monitorización de Ollama.
Buenas prácticas
- Anota la revisión exacta del modelo (fecha o hash de Hugging Face, digest de Ollama): una etiqueta como
latestpuede cambiar. - Prueba la calidad con tus propias consultas: el rendimiento no dice nada sobre la corrección de las respuestas.
- Prevé la memoria para el contexto real de tus peticiones, no solo para los pesos.
- Mantén una API compatible con OpenAI delante del modelo para poder cambiarlo sin reescribir la aplicación.
- Instrumenta las llamadas con OpenTelemetry desde el piloto: latencia, tokens y errores se comparan después en Dynatrace SaaS con DQL, o en una pila de Prometheus y Grafana junto a Dynatrace Managed.
Preguntas frecuentes
¿Por qué esta comparativa no da tokens por segundo?
Porque ningún valor publicado es trasladable a tu hardware. No todos los editores publican rendimiento, y los que existen dependen de la GPU, de la cuantización y de la carga. Una medición de treinta minutos con vllm bench serve vale más que una cifra copiada.
¿Ollama o vLLM para comparar?
Ollama para un puesto de trabajo o una prueba rápida con modelos cuantizados; vLLM para medir el comportamiento de un servidor bajo carga concurrente. Ambos exponen una API compatible con OpenAI.
¿«Código abierto» o «pesos abiertos»?
Estos modelos publican sus pesos bajo una licencia determinada; los datos y el código de entrenamiento no tienen por qué estar publicados. Para el uso en producción, lo que cuenta es la licencia de los pesos, de ahí la segunda columna de la tabla.
Conclusión
Una comparativa de LLM de código abierto útil se limita a lo verificable: licencia, parámetros, memoria anunciada, etiquetas disponibles. El rendimiento, en cambio, se mide en tu casa, con las mismas herramientas para todos los candidatos. La tabla sirve para descartar; el banco de medición sirve para decidir.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a los editores o proyectos citados. Las marcas citadas pertenecen a sus propietarios. Las fichas de modelos evolucionan: comprueba la licencia y las características en la ficha oficial antes de cualquier despliegue.