vLLM inferencia de LLM: el repositorio vllm-project/vllm es una biblioteca de Python y un servidor para ejecutar modelos de lenguaje en tus propias GPU, con una API compatible con OpenAI. Mostraba unas 95 100 estrellas en octubre de 2026, con licencia Apache-2.0. El README lo resume como «Easy, fast, and cheap LLM serving for everyone».
Para un equipo de operaciones, la cuestión no es solo lanzarlo, sino saber qué ocurre cuando diez usuarios llegan a la vez: cuántas peticiones esperan, a qué velocidad sale el primer token, dónde se satura la caché de memoria. Este artículo presenta el proyecto, la instalación según la documentación y, sobre todo, las señales que hay que vigilar. Para el despliegue básico y un primer dashboard, consulta nuestro artículo sobre vLLM en producción: aquí el enfoque es el funcionamiento interno y la lectura de las métricas de servicio.
La información procede del README y de la documentación oficial del proyecto. span.observer no ha instalado vLLM: los esquemas siguientes proceden de la documentación del proyecto.
vLLM inferencia de LLM: lo que dice el repositorio
- Origen: según el README, vLLM se desarrolló originalmente en el Sky Computing Lab de la Universidad de California en Berkeley, y hoy lo mantiene una comunidad de «decenas de instituciones académicas y empresas», con más de 2 000 contribuidores.
- Licencia: Apache-2.0 (archivo LICENSE del repositorio).
- Versión: 0.32.0 en PyPI, publicada el 18 de octubre de 2026.
- Técnicas destacadas: gestión de la memoria clave-valor con PagedAttention, procesamiento continuo de peticiones (continuous batching), prefill por fragmentos, caché de prefijos, numerosas cuantizaciones (FP8, INT8, INT4, GPTQ, AWQ, GGUF…), decodificación especulativa, paralelismo tensorial, de pipeline, de datos, de expertos y de contexto.
- Interfaces: servidor compatible con OpenAI, con además la API Anthropic Messages y gRPC según el README.
- Hardware: GPU de NVIDIA, AMD e Intel, procesadores x86, ARM y PowerPC, además de plugins de hardware (TPU, Gaudi, Ascend, Apple Silicon…).
El README anuncia un «rendimiento de servicio de última generación»: es una afirmación del proyecto, que no cuantificamos. Mide con tu hardware y tus modelos.
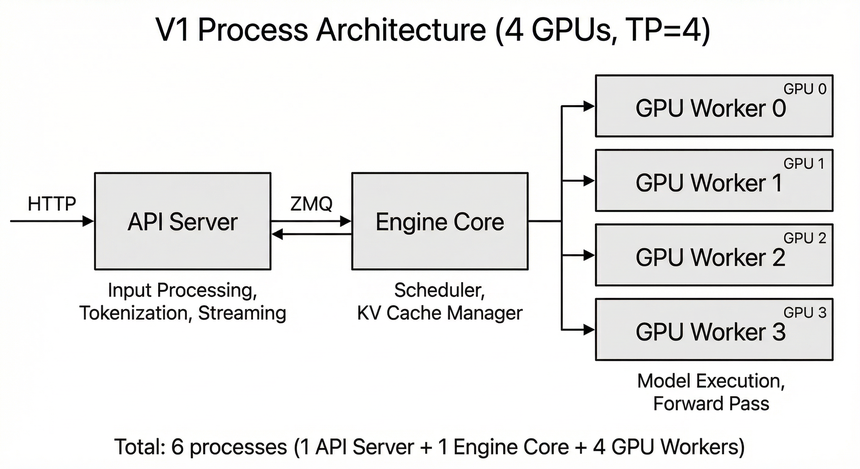
La documentación de arquitectura describe así la versión V1: un servidor de API (tratamiento de entradas, tokenización, flujo de salida), un núcleo de motor (planificador y gestor de caché KV) conectado por ZMQ, y un proceso de trabajo por GPU. Para supervisar es útil: una cola que crece viene del planificador, no del modelo.
Instalar vLLM según la documentación
Paso 1 — Requisitos previos
La guía de inicio indica: sistema Linux, Python 3.11 a 3.14. En Mac con chip Apple, la misma guía remite al proyecto distinto vLLM-Metal. Las páginas consultadas no describen una instalación nativa en Windows.
Paso 2 — Instalar
uv venv --python 3.12 --seed
source .venv/bin/activate
uv pip install vllm --torch-backend=auto
vllm download-kernels
El README da la forma corta uv pip install vllm seguida de vllm download-kernels: este comando instala kernels precompilados que, si no, se descargan y compilan al arrancar, lo que puede añadir varios minutos en las GPU Hopper y posteriores. Las variantes AMD ROCm, Intel, TPU y Ascend tienen sus propias instrucciones en la documentación.
Paso 3 — Lanzar el servidor
vllm serve Qwen/Qwen2.5-1.5B-InstructPor defecto, el servidor escucha en http://localhost:8000 (opciones --host y --port) y aloja un solo modelo a la vez, según la guía.
Supervisar vLLM: las métricas de servicio
El servidor expone métricas en formato Prometheus en el punto /metrics. La documentación muestra la consulta:
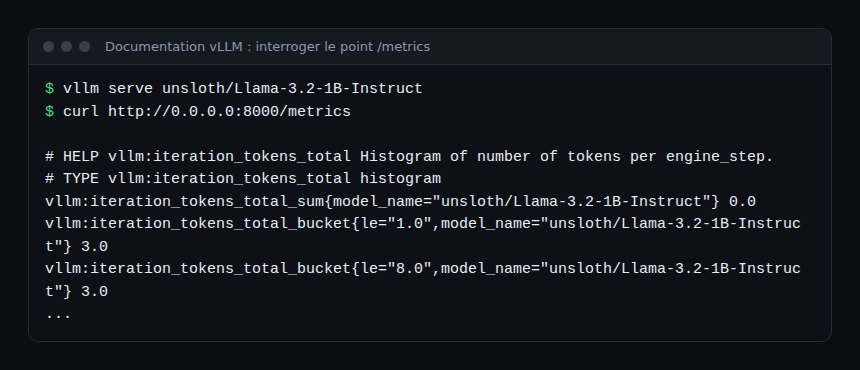
Los nombres siguientes figuran en la página «Production Metrics» de la documentación en desarrollo; compruébalos contra la versión que despliegues, porque el proyecto aplica una política de obsolescencia (una métrica obsoleta en X.Y se oculta en X.Y+1 y se elimina en X.Y+2).
- Cola y carga:
vllm:num_requests_runningyvllm:num_requests_waiting. - Memoria:
vllm:kv_cache_usage_perc(ocupación de la caché clave-valor) yvllm:num_preemptions. - Latencia:
vllm:time_to_first_token_seconds,vllm:inter_token_latency_seconds,vllm:e2e_request_latency_seconds, así como los tiempos de cola, de prefill y de decodificación por petición. - Volumen:
vllm:prompt_tokens,vllm:generation_tokensyvllm:request_success.
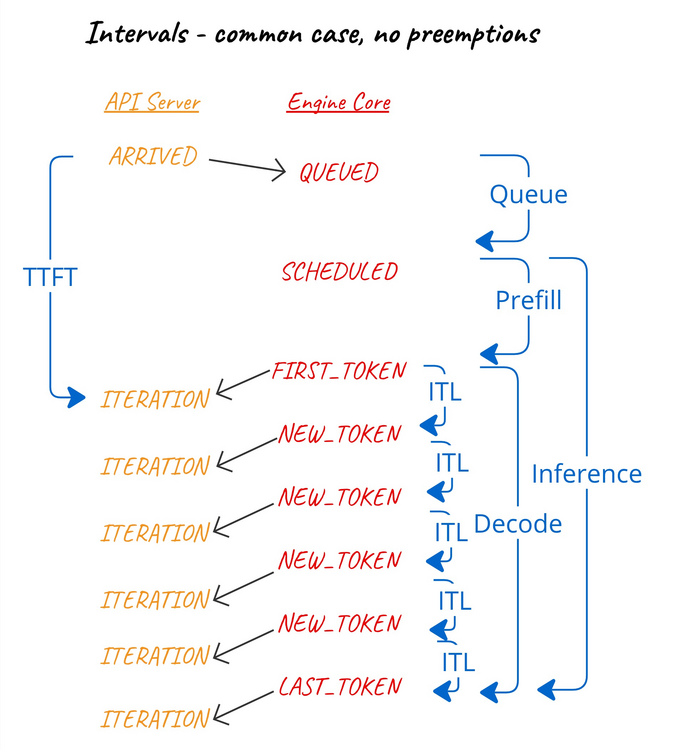
El esquema de diseño del proyecto ayuda a leer estos histogramas: el TTFT (tiempo hasta el primer token) cubre la espera en cola y después el prefill; el ITL (retardo entre tokens) mide el ritmo de la decodificación. Un TTFT que sube con una cola que crece indica saturación; un ITL que sube con la caché KV llena indica presión de memoria.
Ajustar los buckets de un SLO
La documentación precisa que el umbral más pequeño por defecto de los histogramas de fases de petición es 0,3 s. Para seguir un objetivo de latencia más bajo, la opción --custom-histogram-buckets sustituye los umbrales de una familia:
vllm serve Qwen/Qwen3-0.6B \
    --custom-histogram-buckets '{"request_latency": [0.01, 0.05, 0.1, 0.25, 0.5, 1.0, 5.0, 30.0]}'
Cada umbral añade una serie temporal por métrica y por combinación de etiquetas: mantén listas cortas. La documentación señala también la opción --enable-mfu-metrics para métricas de utilización de flops del modelo.
Trazas de OpenTelemetry
No confundas métricas y trazas. vLLM admite el trazado de OpenTelemetry mediante --otlp-traces-endpoint y --collect-detailed-traces. El ejemplo de la documentación usa Jaeger, OTEL_SERVICE_NAME y OTEL_EXPORTER_OTLP_TRACES_ENDPOINT; el protocolo por defecto es gRPC, y OTEL_EXPORTER_OTLP_TRACES_PROTOCOL=http/protobuf cambia a HTTP. Un Collector colocado delante permite después enrutar hacia tu herramienta; consulta el Collector de OpenTelemetry hacia Dynatrace.
Cómo comprobar que funciona
curl http://localhost:8000/metricsdevuelve líneasvllm:….- Envía algunas peticiones a la API y comprueba que
vllm:request_successy los contadores de tokens aumentan. - Con el trazado activado, cada petición produce una traza visible en tu backend con el nombre de servicio elegido.
Límites y puntos abiertos
- Hardware: el proyecto apunta sobre todo a GPU; para un equipo sin GPU, herramientas como llama.cpp u Ollama son más sencillas.
- Estadísticas de uso: la documentación indica que vLLM recoge por defecto datos de uso anónimos (hardware, arquitectura del modelo, configuración). Desactivación:
VLLM_NO_USAGE_STATS=1oDO_NOT_TRACK=1, o un archivo~/.config/vllm/do_not_track. Decídelo antes de pasar a producción. - Un modelo por servidor; los nombres de las métricas pueden cambiar de una versión a otra (política de obsolescencia del proyecto).
- Cardinalidad: los buckets y el paralelismo de datos multiplican las series de Prometheus.
Buenas prácticas
- Fija la versión de vLLM y relee las notas de versión antes de cada actualización.
- Alerta sobre la cola de espera y el TTFT en lugar de solo sobre el rendimiento.
- Vigila la ocupación de la caché KV y las preempciones antes de añadir GPU.
- Mantén listas de buckets cortas y alineadas con tus SLO.
- No pongas el puerto 8000 en Internet sin autenticación ni proxy.
Preguntas frecuentes
¿Es vLLM gratuito?
El código tiene licencia Apache-2.0. El hardware de GPU y la operación corren por tu cuenta.
¿Sustituye vLLM a Ollama?
Son dos enfoques: vLLM apunta al servicio multiusuario en servidor, Ollama a la comodidad en un equipo local. Consulta el stack de IA de código abierto autoalojado.
¿Dónde encontrar la lista exacta de métricas?
En la página «Production Metrics» de la documentación, o directamente en el punto /metrics de la versión que ejecutas.
Conclusión
vLLM es un motor de inferencia muy activo, que expone lo necesario para medir cola, memoria y latencias. Instálalo según la documentación, activa las métricas desde el primer día, añade las trazas si las necesitas y decide sobre la recogida de uso antes de pasar a producción.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a los proyectos citados. Las marcas citadas pertenecen a sus propietarios. Las herramientas evolucionan rápido: comprueba los comandos y las opciones en su documentación oficial (docs.vllm.ai).