Mistral Large 4 en autoalojamiento es la pregunta que se hacen ya los equipos de plataforma desde el anuncio del 6 de octubre de 2026. Antes de comprar GPU hay que separar lo que está publicado de lo que solo se promete. A la fecha de este artículo (15 de octubre de 2026), Mistral ofrece una versión preliminar del modelo a través de su API y de su plataforma Mistral Studio, y anuncia la publicación de los pesos «antes de que acabe el mes». Todavía no existe ningún repositorio de pesos bajo la cuenta mistralai de Hugging Face, y la licencia no está publicada.
Por tanto, todavía no se puede autoalojar Mistral Large 4. Sí se puede preparar el terreno: estimar la memoria necesaria a partir de las cifras oficiales, apoyarse en lo que Mistral ha documentado para Mistral Large 3 y montar la monitorización de un servidor de inferencia con varias GPU. De eso trata esta guía, orientada a la explotación.
Este tema no depende de Dynatrace: las métricas citadas están en formato Prometheus y las puede recopilar cualquier backend, incluidos Dynatrace SaaS y Dynatrace Managed.
Mistral Large 4: qué está publicado a 15 de octubre de 2026
El anuncio oficial de Mistral da los siguientes elementos:
- un modelo de unos 1 billón de parámetros (1 000 000 de millones), de los cuales 52 000 millones están activos por token: es una arquitectura de mezcla de expertos (MoE);
- un modelo nativamente multimodal (entrada de texto e imagen), que combina instrucción y razonamiento en un solo modelo;
- un entrenamiento con 3800 GPU NVIDIA Grace Blackwell en los centros de datos de Mistral;
- una versión preliminar accesible por API, pesos prometidos para finales de mes y más detalles sobre la arquitectura en ese momento.
Lo que falta para dimensionar con seriedad: la licencia, la longitud de contexto, los formatos de pesos publicados (FP8, NVFP4 u otro) y la versión de vLLM compatible. Mientras esos puntos no se publiquen, cualquier cifra de hardware sigue siendo una estimación.
Estimar la memoria de un modelo de 1 billón de parámetros
En un modelo MoE, todos los expertos deben residir en la memoria de la GPU, aunque solo unos pocos trabajen para cada token. La memoria depende, por tanto, del número total de parámetros; el cálculo por token depende de los parámetros activos. El volumen de los pesos por sí solos se calcula de forma sencilla:
poids (octets) = paramètres totaux × octets par paramètre

1 000 milliards × 2 octets   (BF16)      ≈ 2 To
1 000 milliards × 1 octet    (FP8)       ≈ 1 To
1 000 milliards × 0,5 octet  (4 bits)    ≈ 0,5 To
A esto hay que sumar la caché clave-valor (KV cache), que crece con la longitud de contexto y con el número de peticiones simultáneas, así como el margen del motor de inferencia. Estos órdenes de magnitud bastan para una primera conclusión: incluso cuantizado, Mistral Large 4 apunta a un nodo de GPU de centro de datos, o a varios, y no a un puesto de trabajo. Para un uso local, los modelos más pequeños servidos con Ollama siguen siendo la vía realista.
El punto de referencia publicado: Mistral Large 3
La ficha de Hugging Face de Mistral Large 3 (675 000 millones de parámetros en total, 41 000 millones activos, licencia Apache 2.0, contexto de 256k tokens) ofrece cifras oficiales de despliegue:
- la versión FP8 funciona en un solo nodo de B200 o de H200, con un ejemplo en un nodo 8xH200;
- la versión NVFP4 funciona en un solo nodo de H100 o de A100.
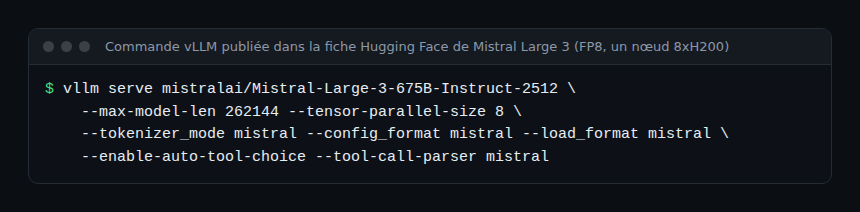
A igual precisión, Large 4 tiene unas 1,5 veces más parámetros que Large 3. Espera a la ficha oficial antes de concluir que un nodo bastará: el formato de cuantización publicado lo cambiará todo. La ficha de Large 3 recuerda también que se puede reducir --max-model-len para ahorrar memoria: es la primera palanca si la caché KV se queda sin espacio.
En la práctica: preparar el autoalojamiento
Paso 1: probar con la versión preliminar de la API
Mide desde ya tus casos de uso reales en la API: longitud media de los prompts, longitud de las respuestas, necesidad de contexto largo, llamadas a herramientas. Estas mediciones fijan la longitud de contexto que configurar y la concurrencia que prever, y por tanto el tamaño de la caché KV.
Paso 2: validar la cadena con Mistral Large 3
El pipeline de despliegue (almacenamiento de los pesos, descarga, arranque, sondas de salud, monitorización) se puede ir afinando con Large 3, cuyos pesos y licencia están publicados. Con varias GPU, vLLM reparte el modelo mediante paralelismo de tensores (--tensor-parallel-size) y, si hace falta, de pipeline (--pipeline-parallel-size). En un solo nodo se apoya en multiprocessing; con varios nodos, en Ray.
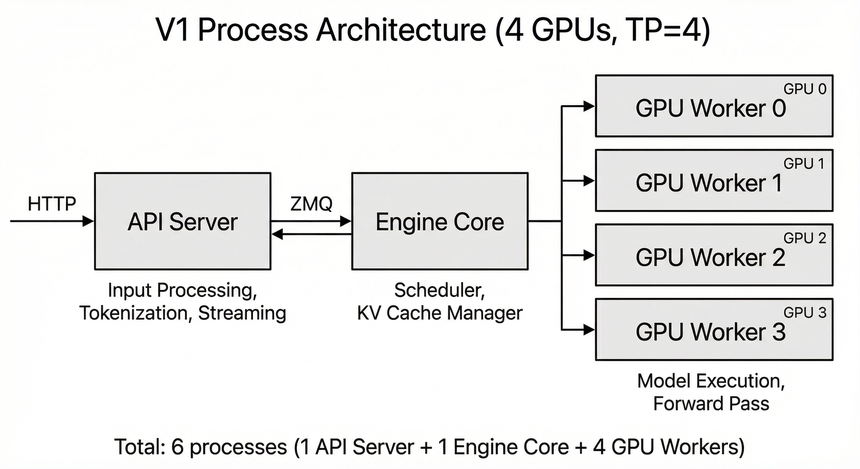
Este esquema muestra lo que hay que monitorizar: el servidor de API (entrada HTTP, tokenización), el núcleo del motor (planificador y caché KV) y un proceso por GPU. Si cae una GPU, se detiene toda la instancia: con el paralelismo de tensores no hay degradación parcial.
Paso 3: conectar la monitorización
vLLM expone sus métricas en formato Prometheus en /metrics, con el prefijo vllm:. Para un modelo MoE grande, sigue en primer lugar:
vllm:kv_cache_usage_perc: parte de la caché KV utilizada (de 0 a 1). Cerca de 1, las peticiones esperan;vllm:num_requests_running: peticiones en curso;vllm:time_to_first_token_seconds: tiempo hasta el primer token (TTFT), sensible a la longitud de los prompts;vllm:inter_token_latency_seconds: retardo entre dos tokens, que se percibe directamente en streaming;vllm:request_queue_time_secondsyvllm:e2e_request_latency_seconds: espera y duración total;vllm:prompt_tokens_totalyvllm:generation_tokens_total: volumen procesado, para calcular el coste por token.
El detalle de la recopilación y de los dashboards está en nuestra guía vLLM en producción. Añade las métricas de las GPU (memoria, temperatura, utilización): en un nodo de ocho GPU, un solo componente que se sobrecaliente ralentiza todo el lote.
Cómo comprobar que funciona
curl http://localhost:8000/v1/modelsdevuelve el nombre del modelo servido.curl -s http://localhost:8000/metrics | grep vllm:kv_cache_usage_percdevuelve un valor entre 0 y 1.- Bajo carga de prueba, el TTFT p95 se mantiene por debajo de tu objetivo y
vllm:kv_cache_usage_percno se queda pegado a 1.
Buenas prácticas
- No fijes ningún presupuesto de hardware antes de la publicación de la ficha oficial y de la licencia de Mistral Large 4.
- Define los SLO antes del despliegue: TTFT, latencia entre tokens, disponibilidad. Ellos dictan la concurrencia admisible.
- Prevé el tiempo de arranque: cargar un modelo de este tamaño lleva tiempo, lo que alarga la recuperación tras un incidente (MTTR).
- Almacena los pesos lo más cerca posible de los nodos: volver a descargar 1 To en cada reinicio no es una estrategia.
- Compara con la API: según tu volumen, el coste de un nodo dedicado puede no justificarse. Nuestro panorama de las stacks de IA autoalojadas ayuda a decidir.
Preguntas frecuentes
¿Se puede descargar Mistral Large 4 hoy?
No, no a 15 de octubre de 2026. Mistral anuncia los pesos para finales de mes; solo está disponible la versión preliminar de la API.
¿Estará Mistral Large 4 bajo licencia Apache 2.0?
No está publicado. Mistral Large 3 sí lo está, pero nada garantiza que Large 4 siga la misma licencia. Lee la ficha del modelo cuando salga.
¿Por qué 52 000 millones de parámetros activos no bastan para reducir la memoria?
Porque el enrutador puede elegir cualquier experto en cada token: todos deben estar cargados. Los parámetros activos reducen el cálculo, no la memoria de los pesos.
Conclusión
Mistral Large 4 todavía no se puede autoalojar, pero su orden de magnitud es conocido: alrededor de 1 billón de parámetros, es decir, al menos un nodo de GPU de centro de datos. Aprovecha la espera para medir tus usos en la API, afinar la cadena con Mistral Large 3 y conectar la monitorización. Para profundizar en los requisitos de este tipo de carga, lee lo que las cargas de IA exigen a los SRE. Fuentes: anuncio de Mistral Large 4 y ficha de Mistral Large 3.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Mistral AI. Las marcas citadas pertenecen a sus propietarios. Las herramientas evolucionan rápido: comprueba los comandos y las opciones en su documentación oficial.