Para observar eBPF Kubernetes a nivel de red, Cilium y Hubble forman la combinación mejor documentada del proyecto de código abierto. Cilium se apoya en eBPF, una tecnología del kernel de Linux, para aplicar políticas de red. Hubble, construido encima, hace visibles los flujos entre pods sin modificar las aplicaciones.
Esta guía muestra cómo activar Hubble, leer los flujos con la CLI y exportar métricas a Prometheus. Está pensada para equipos SRE y de plataforma que deben responder a una pregunta sencilla: quién habla con quién en el clúster y por qué falla. Los comandos proceden de la documentación oficial de Cilium (página «stable», chart 1.20.4 en el momento de la lectura).
eBPF Kubernetes: qué observan Cilium y Hubble
Según la documentación de Cilium, eBPF permite insertar dinámicamente lógica de visibilidad y de control en el kernel. Así, las políticas se aplican sin cambiar el código de la aplicación ni la configuración de los contenedores. Cilium razona por identidades de cargas de trabajo y no por direcciones IP, lo que sigue siendo legible cuando los pods cambian de dirección.
Hubble es la capa de observabilidad de Cilium. Según la documentación, describe cuatro usos:
- las dependencias entre servicios, con un mapa de comunicaciones, incluidas las llamadas HTTP;
- la supervisión de red: fallos de comunicación, problemas de resolución DNS, conexiones TCP interrumpidas, solicitudes SYN sin respuesta;
- la supervisión de aplicaciones: tasa de respuestas HTTP 4xx y 5xx, percentiles de latencia;
- la observabilidad de seguridad: conexiones bloqueadas por una política de red, accesos desde fuera del clúster.
Son flujos de red, no trazas distribuidas. Un flujo de Hubble indica que un pod ha contactado con otro pod y que el tráfico se ha reenviado o bloqueado. No sustituye a un span de OpenTelemetry, que describe el trabajo de un servicio. Ambos se complementan, como explica nuestro artículo sobre OpenTelemetry y Prometheus.
Dos niveles de visibilidad: nodo y clúster
De forma predeterminada, la API de Hubble se ejecuta en cada nodo donde corre el agente de Cilium. La documentación precisa que eso limita la visión al tráfico observado por el agente local. Se consulta entonces con la CLI hubble mediante un socket Unix local; la CLI viene instalada por defecto en los pods del agente.
Para ver el clúster completo hay que desplegar Hubble Relay. Extiende la visibilidad a todo el clúster, e incluso a varios clústeres en ClusterMesh. La CLI o la interfaz Hubble UI se conectan después a él. Esta interfaz web descubre automáticamente el grafo de dependencias entre servicios (L3/L4 y L7) y muestra los flujos como un mapa filtrable.
Requisitos previos
- Cilium instalado y funcionando en el clúster (
cilium statuslo confirma). - El puerto TCP 4244 abierto en todos los nodos que ejecutan Cilium, requisito explícito de la documentación.
- La CLI
hubbleinstalada en el equipo; el puerto local 4245 libre para el port-forward de Relay.
Activar Hubble y leer los primeros flujos
El comando de activación es corto. Según la documentación, cilium hubble enable modifica el ConfigMap cilium-config, reinicia los pods de Cilium, genera los certificados de Relay y despliega Relay.
- Comprobar el estado con
cilium statusy lanzarcilium hubble enable. - Instalar la CLI
hubblesiguiendo la página de la documentación (descarga del archivo, comprobación de la suma SHA-256, copia en/usr/local/binen Linux). - Abrir el port-forward de Relay con
cilium hubble port-forward. El equivalente con kubectl eskubectl -n kube-system port-forward service/hubble-relay 4245:80. - Comprobar el acceso con
hubble statusy mostrar los flujos conhubble observe.
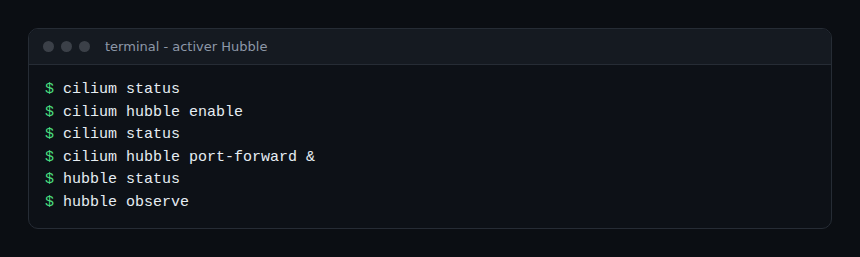
La opción -P abre el port-forward de Relay automáticamente en el puerto 4245: hubble status -P y hubble observe -P. Si el puerto local es distinto, la documentación indica fijar la dirección con --server o con la variable de entorno HUBBLE_SERVER.
Para una instalación con Helm, la documentación da la activación de Relay con helm upgrade cilium cilium/cilium --namespace kube-system --reuse-values --set hubble.relay.enabled=true, indicando la versión del chart. Según la misma página, Hubble está activado por defecto.
Filtrar los flujos con hubble observe
Un clúster produce una enorme cantidad de flujos, por lo que los filtros son indispensables. La página de la CLI de Hubble da varios:
hubble observe --pod deathstar --protocol http
hubble observe --pod deathstar --verdict DROPPED
hubble observe --encrypted
hubble observe --reply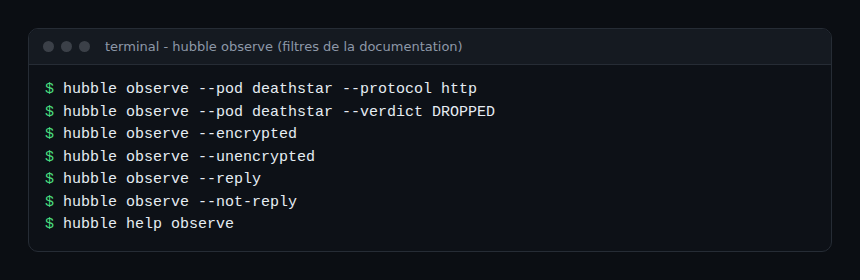
El primero aísla el tráfico HTTP (L7) hacia un pod. El segundo lista el tráfico rechazado, es decir, el veredicto DROPPED. Las líneas de salida muestran la marca de tiempo, el origen y el destino (espacio de nombres, pod, puerto), el tipo de evento, el veredicto (FORWARDED o DROPPED) y, cuando existen, los detalles de la solicitud L7. Las demás opciones se listan con hubble help observe.
En cuanto a la fiabilidad, el veredicto DROPPED sirve de punto de partida para diagnosticar una política de red. Un servicio que responde con timeout no tiene necesariamente un problema de aplicación: una política puede estar bloqueando su tráfico. Hubble lo aclara en pocos segundos, lo que reduce el MTTR.
Exportar las métricas de Hubble a Prometheus
La CLI sirve para el diagnóstico puntual. Para el seguimiento continuo, Hubble expone métricas en formato Prometheus. Según la documentación, la lista de métricas activadas se fija en hubble.metrics.enabled, por ejemplo dns, drop, tcp, flow, port-distribution, icmp y httpV2.
El chart crea un servicio headless hubble-metrics con las anotaciones prometheus.io/scrape: true y prometheus.io/port: 9965. El puerto se ajusta con hubble.metrics.port. Con el Prometheus Operator, hubble.metrics.serviceMonitor.enabled=true crea un ServiceMonitor (las anotaciones se omiten entonces).
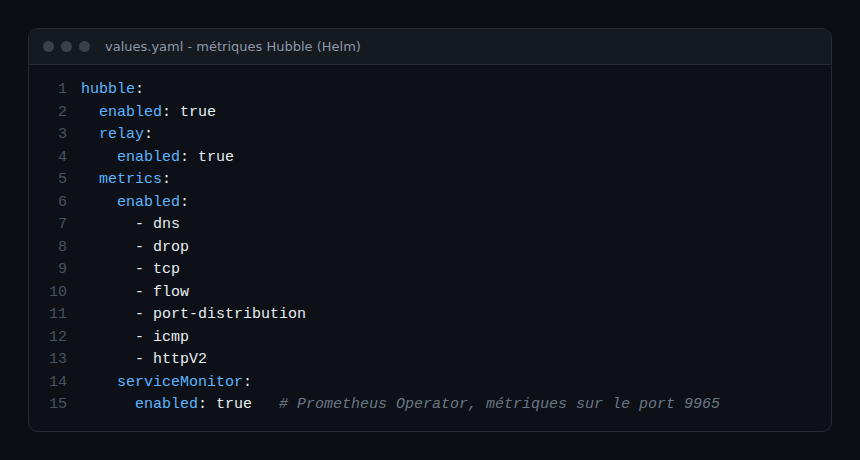
Entre las métricas citadas por la documentación figuran hubble_flows_processed_total, hubble_drop_total, hubble_tcp_flags_total y hubble_dns_queries_total. Dos salvedades: las métricas L7, como HTTP, solo se emiten para los pods con la visibilidad del protocolo L7 activada, y http y httpV2 no pueden estar activas a la vez.
Lugar en una estrategia de observabilidad
Hubble cubre la capa de red. Los equipos siguen necesitando métricas de nodos y pods, trazas y logs. Nuestra guía sobre el Collector de OpenTelemetry en Kubernetes describe la recolección del lado de la plataforma, y la de Prometheus y Dynatrace explica cómo las métricas de Prometheus llegan a Dynatrace. Como las métricas de Hubble están en formato Prometheus, ese camino es concebible. Una integración específica de Cilium con Dynatrace no se ha verificado para este artículo y por tanto no se afirma.
Para situar estas herramientas, véase también la comparación entre Dynatrace y Grafana.
Buenas prácticas
- Abrir el puerto 4244 antes de la activación; de lo contrario Relay no alcanzará a los agentes.
- Activar solo las métricas útiles: cada familia añade series que almacenar.
- Usar el veredicto
DROPPEDcomo primer reflejo cuando un servicio es inalcanzable. - No exponer Relay fuera del clúster sin control de acceso: da una vista de todo el tráfico.
- Releer la página de la versión instalada: los valores del chart evolucionan.
Preguntas frecuentes
¿Hubble sustituye a las trazas distribuidas?
No. Hubble observa flujos de red y, en L7, solicitudes. Una traza describe el recorrido de una solicitud a través del código de los servicios. Los dos enfoques se complementan.
¿Hay que modificar las aplicaciones para usar Hubble?
No. La documentación de Cilium indica que Hubble da visibilidad sin cambiar las cargas de trabajo, gracias a eBPF en el kernel.
¿Qué diferencia hay entre Hubble en un nodo y Hubble Relay?
Sin Relay, la vista se limita al tráfico que ve el agente del nodo. Con Relay, la CLI y Hubble UI ven el clúster completo, e incluso varios clústeres en ClusterMesh.
Conclusión
Activar Hubble requiere unos pocos comandos, y hubble observe responde rápido a las preguntas de conectividad. Las métricas de Prometheus prolongan ese diagnóstico en el seguimiento continuo. Queda por relacionar estas señales de red con las trazas y los logs de la aplicación.
Fuentes
- Setting up Hubble Observability, documentación de Cilium
- Inspecting Network Flows with the CLI, documentación de Cilium
- Monitoring and Metrics, documentación de Cilium
- Introduction to Cilium and Hubble, documentación de Cilium
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni al proyecto Cilium. Dynatrace es una marca de Dynatrace LLC. Las marcas citadas pertenecen a sus propietarios. Las capturas son renderizados de comandos y configuración tomados de la documentación oficial. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.