Ce comparatif LLM open source rassemble, pour huit modèles à poids ouverts, les caractéristiques qui décident d’un déploiement : licence, nombre de paramètres, mémoire GPU annoncée par l’éditeur, taille de téléchargement sous Ollama et commande de service sous vLLM. Chaque valeur vient de la fiche officielle du modèle sur Hugging Face, de la bibliothèque Ollama ou du site de l’éditeur, consultés en octobre 2026. Ce qui n’y figure pas n’est pas écrit.
Il ne contient pas de chiffres de débit. Les débits publiés dépendent du GPU, de la quantification, de la longueur des requêtes et de la concurrence : ils ne se transposent pas d’un environnement à l’autre. La seconde partie montre comment mesurer vous-même le débit et la latence avec vllm bench serve et l’API d’Ollama, sur votre matériel.
Pour la méthode de choix sur des critères d’exploitation (latence, RGPD, coût par tâche), voir choisir son LLM. Pour l’architecture qui entoure le modèle, voir la stack IA open source auto-hébergée.
Comparatif LLM open source : le tableau
| Modèle | Licence | Paramètres | Mémoire indiquée par l’éditeur | Ollama : étiquette, taille, contexte |
|---|---|---|---|---|
| gpt-oss-20b (OpenAI) | Apache 2.0 | 21 Md, 3,6 Md actifs | tient dans 16 Go de mémoire (MXFP4) | gpt-oss:20b, 14 Go, 128K |
| gpt-oss-120b (OpenAI) | Apache 2.0 | 117 Md, 5,1 Md actifs | un seul GPU de 80 Go (H100 ou MI300X) | gpt-oss:120b, 65 Go, 128K |
| Qwen3-8B (Alibaba Qwen) | Apache 2.0 | 8,2 Md | non indiquée | qwen3:8b, 5,2 Go, 40K |
| Qwen3-30B-A3B (Alibaba Qwen) | Apache 2.0 | 30,5 Md, 3,3 Md activés | non indiquée | qwen3:30b, 19 Go, 256K |
| Mistral Small 3.2 24B (Mistral AI) | Apache 2.0 | 24 Md | environ 55 Go en bf16 ou fp16 | mistral-small3.2:24b, 15 Go, 128K |
| Ministral 3 8B (Mistral AI) | Apache 2.0 | 8,9 Md (poids publiés) | tient dans 12 Go de VRAM en FP8 | ministral-3:8b, 6,0 Go, 256K |
| Gemma 3 27B (Google) | Gemma Terms of Use | 27,4 Md (poids publiés) | non consultée (fiche à accès contrôlé) | gemma3:27b, 17 Go, 128K |
| Llama 3.3 70B (Meta) | Llama 3.3 Community License | 70,6 Md (poids publiés) | non consultée (fiche à accès contrôlé) | llama3.3:70b, 43 Go, 128K |
Lecture du tableau :
- Paramètres : valeur de la fiche du modèle ; quand la fiche ne la donne pas, total des poids publiés indiqué par Hugging Face. « Actifs » concerne les modèles à mélange d’experts (MoE), qui n’utilisent qu’une partie de leurs poids par token.
- Taille Ollama : taille du téléchargement de l’étiquette par défaut, déjà quantifiée. Pour Mistral Small 3.2, l’étiquette par défaut correspond à la variante
q4_K_M. La colonne contexte reprend la fenêtre affichée par Ollama pour cette étiquette. - Accès contrôlé : les fiches de Gemma 3 et Llama 3.3 exigent d’accepter la licence sur Hugging Face avant téléchargement.
Licence : ce qui change en production
Six des huit modèles sont sous Apache 2.0 : usage commercial, modification et redistribution autorisés, sous réserve de conserver la licence et les mentions. La fiche de gpt-oss le présente comme une licence permissive « sans restriction copyleft ni risque de brevet ». Gemma 3 et Llama 3.3 ont des licences propres à l’éditeur, avec leurs conditions d’usage : faites-les relire par votre service juridique avant tout déploiement, surtout pour un produit diffusé à des clients.
Taille et mémoire GPU : estimer avant d’acheter
Seules trois fiches donnent un besoin mémoire explicite : gpt-oss (16 Go pour 20b, un GPU de 80 Go pour 120b, grâce à la quantification MXFP4 des poids MoE), Mistral Small 3.2 (environ 55 Go en bf16/fp16) et Ministral 3 8B (12 Go de VRAM en FP8). Pour les autres, un ordre de grandeur se calcule : en bf16, chaque paramètre occupe 2 octets, donc un modèle de 8 milliards de paramètres pèse environ 16 Go de poids seuls. Le chiffre de Mistral Small 3.2 (24 milliards de paramètres, environ 55 Go) montre la marge à prévoir au-delà des poids : cache KV, activations, contexte long.
Les modèles MoE trompent souvent : Qwen3-30B-A3B n’active que 3,3 milliards de paramètres par token, mais les 30,5 milliards doivent tenir en mémoire. Le gain porte sur le calcul, pas sur la VRAM.
La fenêtre de contexte pèse aussi. La fiche de Qwen3-8B indique 32 768 tokens en natif et 131 072 avec YaRN, et précise que ce mode n’est pas recommandé si vos contextes restent sous 32 768 tokens, car il peut dégrader les performances.
Mesurer le débit sur vLLM et Ollama
Étape 1 — Servir le modèle
# vLLM : serveur compatible avec l'API OpenAI (commande des fiches gpt-oss)
vllm serve openai/gpt-oss-20b

# Ollama
ollama pull gpt-oss:20b
ollama run gpt-oss:20b
Les fiches de gpt-oss, Qwen3 et Mistral Small 3.2 donnent chacune leur commande vllm serve. La fiche de Qwen3-8B active le raisonnement avec --enable-reasoning --reasoning-parser deepseek_r1 : un paramètre qui change le nombre de tokens produits, donc le débit apparent.
Étape 2 — Mesurer avec vllm bench serve
vLLM fournit un outil de mesure côté client. Son guide montre le résultat attendu :
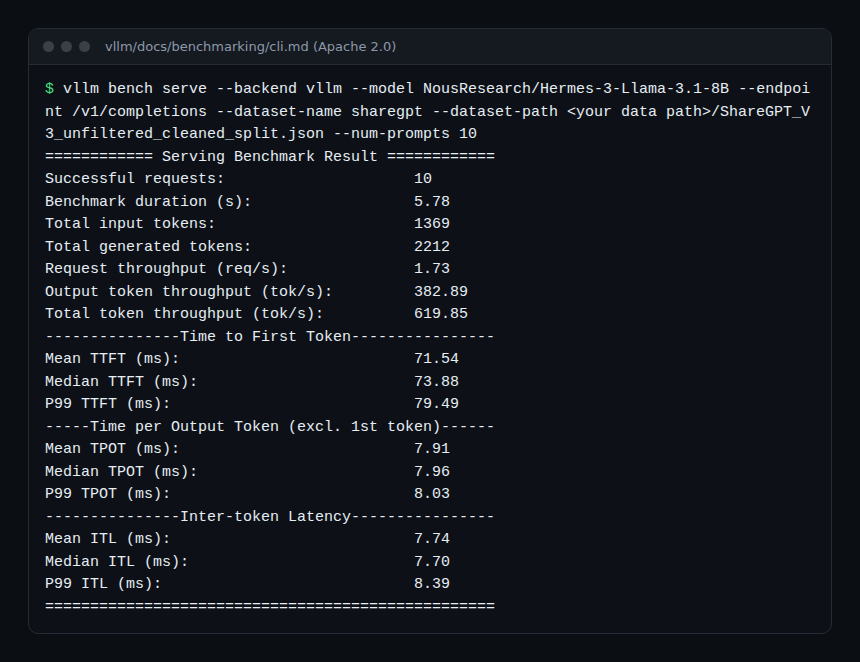
Les lignes à comparer entre modèles sont Output token throughput (tok/s), P99 TTFT (ms) et P99 ITL (ms). Les valeurs de l’image sont celles de l’exemple de la documentation, avec un autre modèle : elles illustrent le format, pas une performance. La documentation prévient que répéter la mesure contre le même serveur peut réutiliser le cache de préfixes et gonfler le débit : changez --seed, redémarrez le serveur ou utilisez vllm bench sweep serve. Elle recommande aussi GuideLLM pour les serveurs de production.
Étape 3 — Mesurer avec l’API d’Ollama
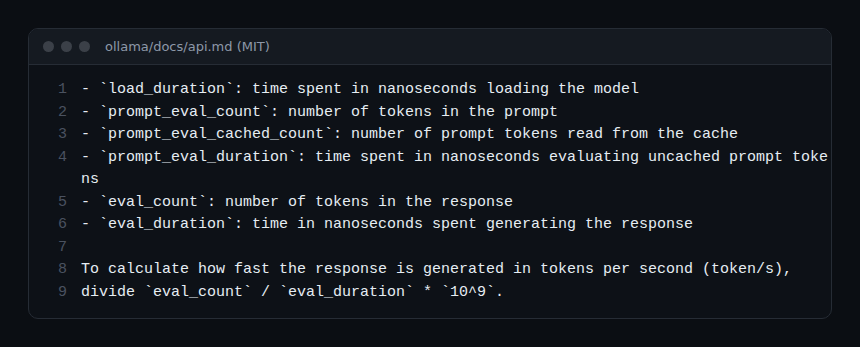
La réponse finale de l’API d’Ollama contient des durées en nanosecondes et des compteurs de tokens :
curl -s http://localhost:11434/api/generate \
  -d '{"model": "gpt-oss:20b", "prompt": "Résume la RFC 9110 en trois lignes.", "stream": false}' \
  | jq '.eval_count / .eval_duration * 1e9'
La formule est celle de la documentation d’Ollama : eval_count / eval_duration × 10^9 donne les tokens générés par seconde. Mesurez à froid et à chaud : load_duration montre le temps de chargement du modèle, qui pèse lourd sur la première requête.
Comment vérifier que la comparaison est juste
- Même GPU, même quantification, même longueur d’entrée et de sortie pour tous les modèles.
- Plusieurs niveaux de concurrence (
--max-concurrency) : un modèle rapide seul peut s’effondrer à 32 requêtes simultanées. - Le mode raisonnement activé ou non de la même façon pour les modèles qui le proposent.
- En production, les métriques Prometheus de vLLM confirment les mesures : voir vLLM en production et, pour Ollama, la supervision d’Ollama.
Bonnes pratiques
- Relevez la révision exacte du modèle (date ou hash Hugging Face, digest Ollama) : une étiquette comme
latestpeut changer. - Testez la qualité sur vos propres requêtes : le débit ne dit rien de la justesse des réponses.
- Prévoyez la mémoire pour le contexte réel de vos requêtes, pas seulement pour les poids.
- Gardez une API compatible OpenAI devant le modèle pour pouvoir en changer sans réécrire l’application.
- Instrumentez les appels avec OpenTelemetry dès le pilote : latence, tokens et erreurs se comparent ensuite dans Dynatrace SaaS en DQL, ou dans une pile Prometheus et Grafana à côté de Dynatrace Managed.
Questions fréquentes
Pourquoi ce comparatif ne donne-t-il pas de tokens par seconde ?
Parce qu’aucune valeur publiée n’est transposable à votre matériel. Les éditeurs ne publient pas tous de débit, et ceux qui existent dépendent du GPU, de la quantification et de la charge. Une mesure de trente minutes avec vllm bench serve vaut mieux qu’un chiffre recopié.
Ollama ou vLLM pour comparer ?
Ollama pour un poste de travail ou un test rapide avec des modèles quantifiés ; vLLM pour mesurer un comportement de serveur sous charge concurrente. Les deux exposent une API compatible OpenAI.
« Open source » ou « poids ouverts » ?
Ces modèles publient leurs poids sous une licence donnée ; les données et le code d’entraînement ne sont pas forcément publiés. Pour l’usage en production, c’est la licence des poids qui compte, d’où la deuxième colonne du tableau.
Conclusion
Un comparatif LLM open source utile se limite à ce qui est vérifiable : licence, paramètres, mémoire annoncée, étiquettes disponibles. Le débit, lui, se mesure chez vous, avec les mêmes outils pour tous les candidats. Le tableau sert à éliminer ; le banc de mesure sert à décider.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni aux éditeurs ou projets cités. Les marques citées appartiennent à leurs propriétaires. Les fiches de modèles évoluent : vérifiez licence et caractéristiques sur la fiche officielle avant tout déploiement.