Headroom, compresión de contexto LLM para agentes de código: el proyecto se presenta como una capa que comprime todo lo que lee un agente (salidas de herramientas, logs, fragmentos de RAG, archivos, historial) antes de que llegue al modelo. El repositorio headroomlabs-ai/headroom muestra unas 77 500 estrellas a finales de octubre de 2026, con licencia Apache-2.0.
Menos tokens de entrada significa menos coste y menos compactaciones, pero solo si la compresión no destruye la información útil. Este artículo resume lo que hace el proyecto según su README, muestra su dashboard, detalla la instalación y explica cómo medir tú mismo los ahorros con sus métricas de Prometheus y OpenTelemetry. Aclaración de honestidad: span.observer no ha instalado Headroom; los comandos proceden del README y de la documentación del proyecto, y las capturas proceden del repositorio.
Headroom: compresión de contexto LLM, lo que dice el repositorio
- Quién: la organización
headroomlabs-ai; la documentación está alojada en docs.headroomlabs.ai. - Licencia: Apache-2.0 (archivo LICENSE del repositorio).
- Cifras releídas el 22 de octubre de 2026: unas 77 500 estrellas, unos 6 000 forks, 3 324 commits; el
pyproject.tomlde la rama principal indica la versión 0.41.0 del paqueteheadroom-ai, que requiere Python 3.10 o posterior. - Cuatro usos según el README: una biblioteca (
compress(messages)en Python o TypeScript), un proxy (headroom proxy --port 8787), el envoltorio de agente (headroom wrap claude,codex,cursor,aider,opencode…) y un servidor MCP.
El mecanismo descrito: un enrutador de contenido detecta el tipo de datos y elige un compresor (JSON, código mediante árbol sintáctico, texto con un modelo publicado en Hugging Face). Los originales se guardan en local («CCR») y el modelo puede volver a pedirlos mediante la herramienta headroom_retrieve. El proyecto afirma que la compresión se hace en tu máquina, sin enviar el contenido a otro sitio para comprimirlo. Esta idea es cercana a la de context-mode, que mantiene la salida bruta fuera del contexto con otra mecánica y otra licencia.
Recorrido por el dashboard
El comando headroom dashboard abre un dashboard con el proxy en marcha. La captura siguiente procede del repositorio: muestra el estado de salud, las peticiones terminadas, fallidas o limitadas, los tokens ahorrados, el coste, la sobrecarga añadida por el proxy (en milisegundos), el uso por tipo de contenido eliminado («JSON Bloat», «Repetition») y el impacto en la caché de prefijo del proveedor.
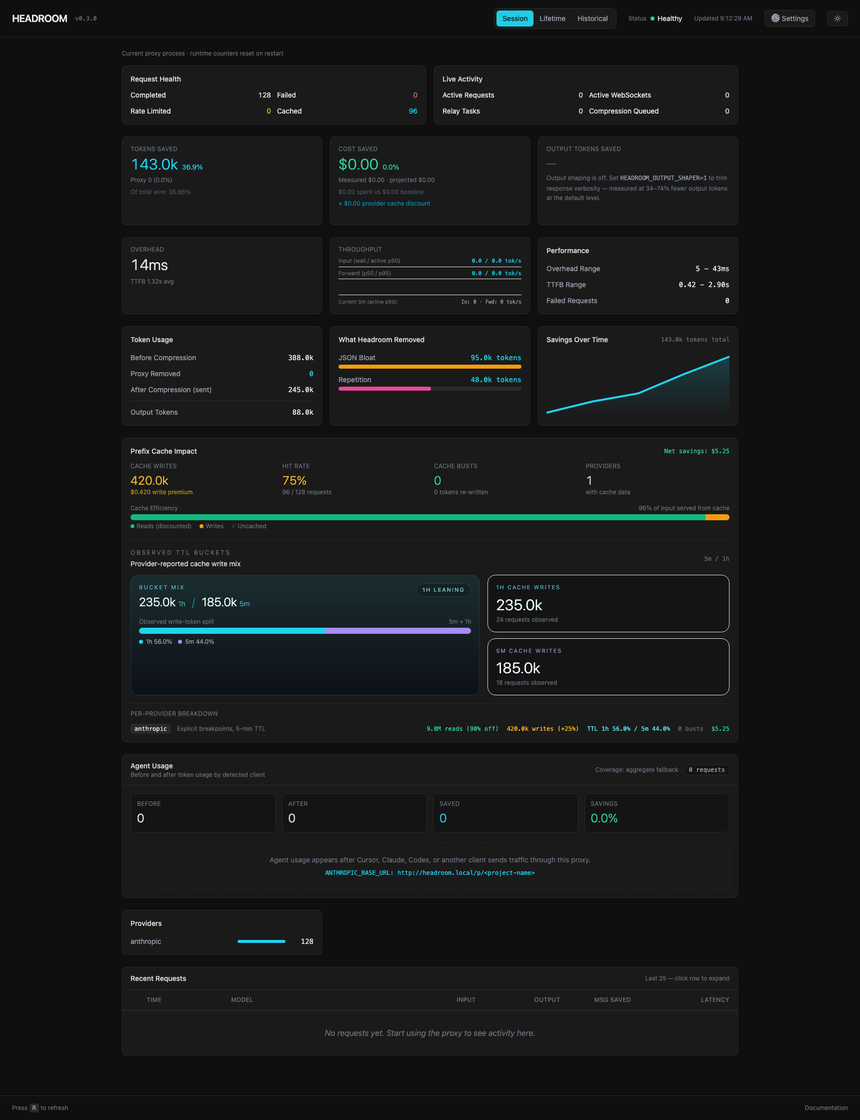
Son valores de ejemplo del proyecto, no mediciones de span.observer. El dashboard prevé también una salida de tokens ahorrados estimada cuando se activa el modelado de la salida (HEADROOM_OUTPUT_SHAPER=1, desactivado por defecto).
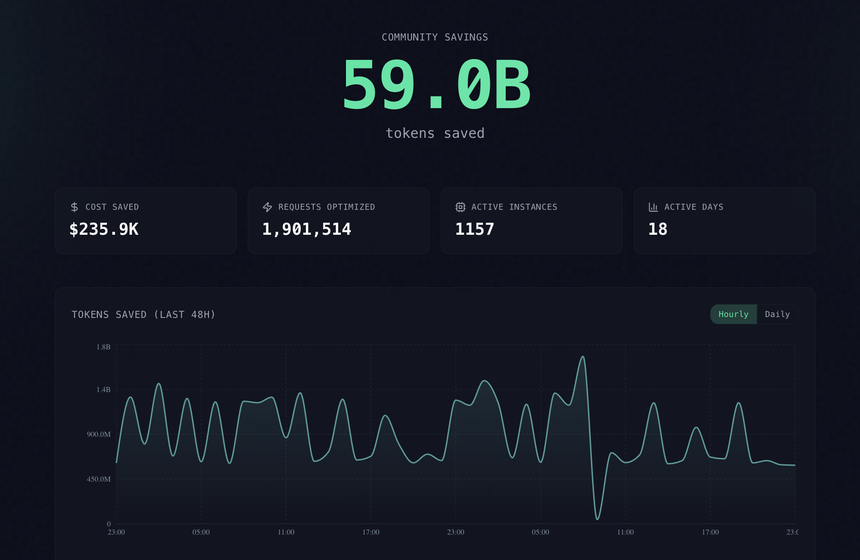
La segunda imagen del repositorio muestra un contador agregado «Community savings». El README no detalla, en el pasaje consultado, cómo se recoge esta cifra: tómala como un dato del proyecto, no verificado, y lee la sección Límites sobre la baliza de telemetría.
Instalación paso a paso
Paso 1 — Instalar la CLI
El README ofrece, a elegir:
uv tool install --python 3.13 "headroom-ai[all]"
pip install "headroom-ai[all]"
npm install headroom-ai     # SDK TypeScript seulement, sans CLI
También se indica una imagen de Docker (ghcr.io/headroomlabs-ai/headroom:latest). Para limitar la superficie, el README lista extras granulares ([proxy], [mcp], [ml], [otel]…).
Paso 2 — Elegir un modo
headroom wrap claude          # enveloppe un agent de code
headroom proxy --port 8787    # proxy sans changer le code
headroom mcp install          # serveur MCP (headroom_compress, headroom_retrieve, headroom_stats)
El README precisa que headroom wrap arranca un proxy local, instala el servidor Serena para la navegación de código y lanza el agente configurado para pasar por Headroom; headroom unwrap lo deshace. Lee esta parte antes de usarlo: modifica la configuración de tu agente.
Paso 3 — Verificar
headroom doctor      # contrôle de santé
headroom perf        # performances
headroom dashboard   # économies en direct (proxy lancé)
Límites y puntos abiertos
- Las cifras son las del proyecto: el README publica una tabla de cuatro escenarios (del 21 % al 57 % de ahorro) medidos con el tokenizador del proveedor, reproducibles con
benchmarks/index_proof_table.py --seed 20260902. Precisa él mismo que las ganancias dependen de lo repetitivos que sean los datos y que la prosa o las salidas ya densas se comprimen muy poco. - Precisión: las pruebas de exactitud del README muestran, con N=100, un delta de ±0,03 que considera dentro del intervalo de confianza. Nada sustituye a una prueba con tus tareas.
- Baliza de telemetría: la página «Limitations» de la documentación explica que
HEADROOM_BEACONestá activada por defecto (se puede desactivar) y envía un resumen anónimo (contadores, ratios, identificadores de proveedor y de modelo, sistema y arquitectura), nunca los prompts ni el código. Se desactiva conHEADROOM_BEACON=off,HEADROOM_TELEMETRY=offoDO_NOT_TRACK=1. Documenta este punto en tu revisión de seguridad. - Un proxy en la ruta de las peticiones: ve tus claves de proveedor y tus prompts. Mantenlo en el bucle local y trátalo como un componente crítico, igual que un servidor MCP (consulta proteger un servidor MCP).
Cómo medir los ahorros y supervisar el proxy
Headroom expone varias fuentes, según su página «Metrics & Monitoring»: el punto de acceso /stats (JSON), el historial /stats-history (con exportación CSV), las métricas de Prometheus en /metrics (por ejemplo headroom_tokens_saved_total, headroom_requests_failed_total) y una exportación OpenTelemetry. La documentación advierte de que headroom_requests_total solo cuenta las peticiones terminadas y de que no existen buckets de histograma: las medias se calculan con los pares _sum y _count.
Para la exportación OTLP, instala el extra [proxy,otel] y define estas variables, tomadas de la documentación:
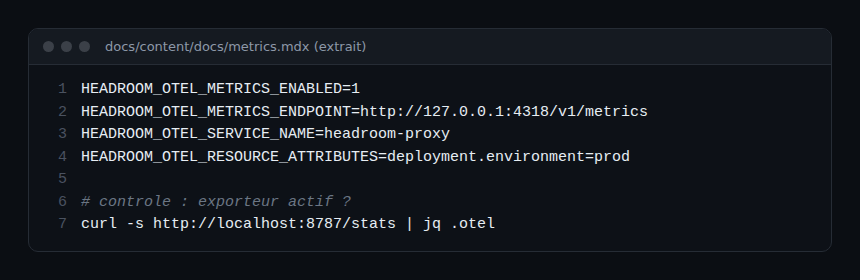
La documentación cita los contadores headroom.proxy.requests, headroom.proxy.tokens.input, headroom.proxy.tokens.output y headroom.proxy.tokens.saved, y precisa que el endpoint debe ser la URL completa, sin añadido automático de /v1/metrics. Para Dynatrace SaaS, la página de Headroom indica un token con el scope metrics.ingest y la variable OTEL_EXPORTER_OTLP_METRICS_TEMPORALITY_PREFERENCE=DELTA: la documentación de OpenTelemetry de Dynatrace confirma que el backend solo ingiere valores con temporalidad delta. El paso a paso de OTLP está en supervisar un agente de código en la empresa. En Dynatrace Managed, comprueba primero que la ingesta OTLP está disponible en tu versión.
Para obtener una cifra independiente, compara los tokens facturados en el agente con y sin Headroom, como en el coste de un agente de IA en tokens con OpenTelemetry, sumando todos los tipos de tokens, caché incluida.
Cómo comprobar que funciona
headroom doctorconfirma que el enrutamiento funciona.curl http://localhost:8787/healthresponde (comando de la página de resolución de problemas de la documentación).curl -s http://localhost:8787/stats | jq .otelconfirma que el exportador OTLP está activo.
Buenas prácticas
- Prueba con una tarea de referencia rica en salidas voluminosas, de tres a cinco veces con y sin proxy.
- Comprueba la calidad de las respuestas, no solo los tokens: una compresión demasiado agresiva puede ocultar una línea útil.
- Fija la versión y relee las variables de telemetría en cada actualización.
- Conserva el acceso local al proxy; no expongas su puerto.
Preguntas frecuentes
¿Es Headroom de código abierto?
Sí, el repositorio tiene licencia Apache-2.0. Comprueba, no obstante, los extras y modelos que instales, ya que cada uno tiene su propia licencia.
¿Envía Headroom mis prompts a algún sitio?
Según el README, la compresión se ejecuta en local. El proxy transmite, por supuesto, la petición comprimida a tu proveedor de LLM, y la baliza de telemetría anónima, activa por defecto, se describe en la página «Limitations».
¿Qué ahorro cabe esperar?
El proyecto publica del 21 % al 57 % en cuatro escenarios y advierte de que los contenidos repetitivos son los que más ganan. Mide con tus propias cargas de trabajo.
Conclusión
Headroom aplica la compresión de contexto LLM lo más cerca posible del proxy y aporta lo necesario para medirla, con Prometheus y OpenTelemetry. Sus cifras son las de sus autores: te toca confirmarlas con tus tareas. Fuentes: repositorio headroomlabs-ai/headroom y documentación de Headroom.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a los proyectos citados. Las marcas citadas pertenecen a sus propietarios. Las herramientas evolucionan rápido: comprueba los comandos y las opciones en su documentación oficial.