Le LLM-as-judge en production consiste à faire noter par un second modèle de langage les réponses réelles d’une application d’IA générative. L’idée est séduisante : une note automatique remplace la relecture humaine. Mais chaque note est elle-même un appel à un modèle, donc un coût et une latence de plus. Sans cadrage, le juge peut coûter autant que l’application qu’il surveille.
Cet article propose une méthode pour garder ce coût sous contrôle : noter un échantillon, cibler les bonnes étapes, calibrer le juge sur des exemples humains, puis mesurer le juge comme n’importe quel autre service. Il complète l’article sur l’évaluation d’un RAG avec LlamaIndex, qui traite surtout de l’évaluation hors ligne. Ici, l’angle est l’exploitation continue, côté SRE.
En bref
- Un juge LLM reçoit une grille, l’entrée, la sortie et, au besoin, une référence ; il rend un score et une justification.
- En production, le budget se règle par l’échantillonnage, le ciblage des observations et le choix du modèle juge.
- Un juge a des biais documentés : il faut le calibrer sur des exemples étiquetés avant de s’y fier.
- Le juge doit être observé : coût, durée, erreurs, file d’attente.
LLM-as-judge en production : ce que coûte un juge
Selon la documentation de Langfuse, un juge reçoit une grille d’évaluation, l’entrée, la sortie à évaluer et une référence facultative. Il renvoie un score accompagné d’un raisonnement. La même page précise que le coût dépend du modèle juge et de la taille des entrées. Deux leviers en découlent : réduire le nombre de notes et réduire le volume envoyé au juge.
La différence avec l’évaluation hors ligne est simple. Hors ligne, un jeu de test fixe est rejoué avant une mise en production. En production, le trafic est ouvert, volumineux et change sans cesse. Noter chaque requête n’est ni nécessaire ni souhaitable. Il faut donc décider quoi noter, à quelle fréquence et avec quel modèle.
Choisir quoi noter
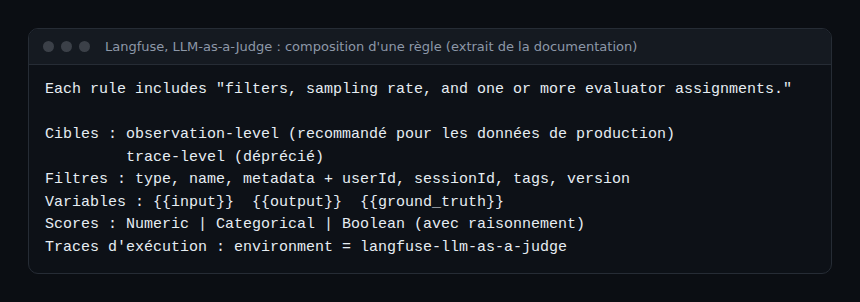
La documentation Langfuse décrit une règle d’évaluation en direct comme un ensemble de filtres, d’un taux d’échantillonnage et d’une ou plusieurs affectations d’évaluateurs. Ce découpage est utile même hors de cet outil, car il pose les bonnes questions.
Cibler l’étape qui compte
Langfuse recommande des évaluateurs au niveau de l’observation pour les données de production, et indique que ceux au niveau de la trace sont dépréciés. Concrètement, notez la réponse finale du modèle, pas chaque appel intermédiaire d’un agent. La page ajoute qu’un évaluateur au niveau de l’observation ne charge pas les observations sœurs ou filles : toute l’information utile doit donc figurer dans l’entrée et la sortie évaluées.
Filtrer avant d’échantillonner
Les filtres disponibles portent sur le type, le nom et les métadonnées de l’observation, ainsi que sur l’utilisateur, la session, les tags et la version de la trace. Un filtre sur la version est précieux : après un changement de prompt ou de modèle, on note davantage la nouvelle version, puis on redescend une fois la confiance rétablie. Pour le fonctionnement des traces et des identifiants, voir l’article sur Langfuse et OpenLLMetry.
Échantillonner de façon reproductible
Un tirage aléatoire pur rend les comparaisons difficiles. Un échantillonnage déterministe sur l’identifiant de trace garantit qu’une même trace est toujours notée, ou jamais, quel que soit le service qui décide. L’exemple ci-dessous est un schéma pédagogique de span.observer, pas une fonction d’une bibliothèque.
import hashlib

def a_noter(trace_id: str, taux: float) -> bool:
    # Vrai pour environ `taux` des traces, de façon stable.
    h = int(hashlib.sha256(trace_id.encode()).hexdigest(), 16)
    return (h % 10_000) < int(taux * 10_000)

# 5 % du trafic courant, 100 % des traces signalées (erreur, retour négatif)
taux = 1.0 if est_signalee else 0.05
if a_noter(trace_id, taux):
    envoyer_au_juge(trace_id)
Deux strates suffisent souvent : un petit pourcentage du trafic ordinaire, et la totalité des cas déjà suspects (retours négatifs, erreurs, version récente). C’est le même raisonnement que pour l’échantillonnage des traces : garder ce qui est rare et utile.
Calibrer le juge avant de lui faire confiance
Un juge n’est pas un instrument neutre. L’article de recherche « Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena » nomme quatre faiblesses : la sensibilité à l’ordre des réponses, la préférence pour les réponses longues, le favoritisme envers ses propres sorties et un raisonnement limité. Ses auteurs rapportent aussi qu’un juge fort comme GPT-4 atteint plus de 80 % d’accord avec les humains, soit le niveau d’accord entre humains. Ce chiffre vient de leur étude et de leurs jeux de données. Il ne se transpose pas à votre grille ni à vos réponses.
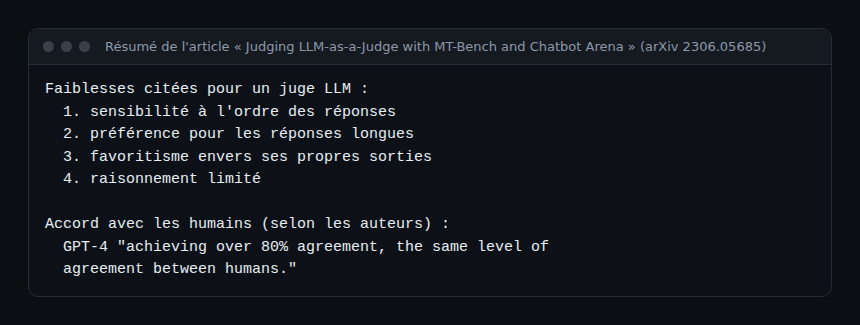
La page Langfuse donne la même consigne pratique : vérifier le prompt du juge sur des exemples étiquetés avant de s’en servir. Voici une méthode courte.
- Constituer un jeu d’or : quelques dizaines de réponses réelles, étiquetées par une personne qui connaît le métier.
- Rédiger une grille étroite : un critère par juge (fidélité au contexte, par exemple), avec un score booléen ou catégoriel plutôt qu’une note sur dix.
- Comparer les notes du juge aux étiquettes humaines, et lire les désaccords un par un.
- Corriger la grille, puis recommencer. Refaire ce contrôle à chaque changement de modèle juge.
- Relire un échantillon chaque semaine : la dérive du trafic finit par désaligner le juge.
Les scores catégoriels et booléens, proposés par Langfuse en plus des scores numériques, se calibrent plus facilement : le désaccord est net. Un score se rattache à une trace, à une observation, à une session ou à une exécution de jeu de données, d’après le modèle de données de Langfuse.
Réduire le prix de chaque note
- Un juge moins cher quand la grille est simple. La page Langfuse indique qu’un évaluateur utilise le modèle par défaut du projet, sauf si on en choisit un dédié. Testez un modèle plus petit sur le jeu d’or et gardez-le s’il s’accorde assez avec les humains.
- Des entrées courtes : n’envoyez que la question, la réponse et les passages de contexte réellement utilisés.
- Des vérifications déterministes d’abord : format JSON valide, longueur, présence d’une citation. Ce qui se teste par code ne demande pas de juge.
- Un seuil de déclenchement : ne notez que les réponses qui ont passé les contrôles simples.
Pour relier ces choix aux jetons consommés, l’article sur le coût d’un agent IA montre comment suivre les tokens avec OpenTelemetry.
Observer le juge lui-même
Un juge en panne produit un tableau de bord vide, que l’on prend à tort pour une bonne nouvelle. Langfuse exécute les évaluateurs dans son worker, pas dans l’application. Chaque exécution crée une trace : la documentation indique de filtrer l’environnement langfuse-llm-as-a-judge dans la table des traces. Les statuts sont Completed, Error, Delayed (limite de débit, nouvel essai) et Pending. Cette page précise aussi que les traces d’exécution permettent de surveiller la consommation de jetons.
Quatre signaux à suivre, quel que soit l’outil :
- le nombre de notes produites par heure, comparé au taux d’échantillonnage attendu ;
- la part d’exécutions en erreur ou en attente ;
- les jetons consommés par le juge, séparés de ceux de l’application ;
- la distribution des scores : une bascule soudaine signale souvent un changement de prompt ou de modèle.
Si le juge est appelé via un SDK instrumenté OpenTelemetry, la durée de l’appel peut alimenter l’histogramme gen_ai.client.operation.duration (unité s). Selon la spécification OpenTelemetry GenAI, cette métrique est encore au statut Development : ses noms peuvent changer. Ce billet ne décrit aucune intégration Dynatrace documentée pour les scores de juge. Une équipe qui utilise Dynatrace peut publier ses scores comme attributs ou métriques via OpenTelemetry, à condition de définir elle-même le schéma. Les garde-fous des agents IA complètent cette surveillance.
Bonnes pratiques
- Un juge par critère, avec une grille courte et des sorties catégorielles.
- Un jeu d’or humain, revu à chaque changement de modèle ou de prompt.
- Un budget explicite : notes par jour et jetons maximaux, avec alerte en cas de dépassement.
- Un juge d’une autre famille que le modèle évalué, pour limiter le favoritisme envers ses propres sorties.
- Les notes servent à repérer des tendances et à orienter la relecture humaine, pas à décider seules d’un blocage.
Questions fréquentes
Faut-il noter 100 % des réponses en production ?
Rarement. Un échantillon stable du trafic ordinaire, plus la totalité des cas suspects, donne un signal exploitable à un coût borné. Langfuse propose d’ailleurs un taux d’échantillonnage dans chaque règle d’évaluation.
Un juge LLM peut-il remplacer l’évaluation humaine ?
Non. Il la prolonge. Les auteurs de l’article MT-Bench rapportent un fort accord avec les humains pour un juge puissant, mais décrivent aussi des biais. Un contrôle humain régulier reste nécessaire pour garder le juge aligné.
Comment savoir si le juge coûte trop cher ?
Mesurez les jetons et le nombre d’appels du juge séparément de l’application, puis rapportez-les au volume de traces. Si le juge approche le coût de l’application, réduisez le taux d’échantillonnage, raccourcissez les entrées ou testez un modèle plus petit.
Conclusion
Un LLM-as-judge en production reste un service à part entière, avec un budget, des erreurs et une dérive possible. L’échantillonnage, le ciblage de l’étape et la calibration sur un jeu humain donnent un signal utile à coût maîtrisé.
Sources
- LLM-as-a-Judge, documentation Langfuse
- Modèle de données de l’évaluation, documentation Langfuse
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, arXiv
- Conventions sémantiques OpenTelemetry GenAI
span.observer est un blog indépendant, non affilié à Dynatrace LLC ni à Langfuse. Les noms de produits cités appartiennent à leurs propriétaires respectifs ; le code est un exemple pédagogique.