يقوم LLM-as-judge في الإنتاج على أن يُقيّم نموذج لغوي ثانٍ الردود الحقيقية لتطبيق ذكاء اصطناعي توليدي. الفكرة جذابة: درجة آلية تحلّ محل المراجعة البشرية. لكن كل درجة هي بحد ذاتها استدعاء لنموذج، أي كلفة وزمن استجابة إضافيان. وبلا إطار واضح قد تبلغ كلفة القاضي كلفة التطبيق الذي يراقبه.
تقترح هذه المقالة طريقة للإبقاء على هذه الكلفة تحت السيطرة: تقييم عيّنة، واستهداف الخطوات المناسبة، ومعايرة القاضي بأمثلة بشرية، ثم قياس القاضي كأي خدمة أخرى. وهي تكمّل مقالة تقييم نظام RAG مع LlamaIndex التي تعالج خصوصًا التقييم خارج الإنتاج. أما هنا فالزاوية هي التشغيل المستمر من جهة SRE.
باختصار
- يتلقى القاضي LLM معيار تقييم، والمدخل، والمخرج، ومرجعًا عند الحاجة؛ ويعيد درجة وتعليلًا.
- في الإنتاج تُضبط الميزانية عبر أخذ العيّنات، واستهداف الملاحظات (observations)، واختيار نموذج القاضي.
- للقاضي انحيازات موثقة: يجب معايرته بأمثلة موسومة قبل الاعتماد عليه.
- يجب مراقبة القاضي نفسه: الكلفة، والمدة، والأخطاء، وطابور الانتظار.
LLM-as-judge في الإنتاج: كم يكلّف القاضي
بحسب وثائق Langfuse، يتلقى القاضي معيار تقييم، والمدخل، والمخرج المراد تقييمه، ومرجعًا اختياريًا. ويعيد درجة مصحوبة بتعليل. وتوضح الصفحة نفسها أن الكلفة تتوقف على نموذج القاضي وحجم المدخلات. ومن ذلك رافعتان: تقليل عدد الدرجات وتقليل الحجم المرسل إلى القاضي.
الفرق عن التقييم خارج الإنتاج بسيط. خارج الإنتاج، يُعاد تشغيل مجموعة اختبار ثابتة قبل الإطلاق. أما في الإنتاج فالحركة مفتوحة وكبيرة وتتغير باستمرار. تقييم كل طلب ليس ضروريًا ولا مرغوبًا. لذا يجب تحديد ما يُقيَّم، وبأي وتيرة، وبأي نموذج.
اختيار ما يُقيَّم
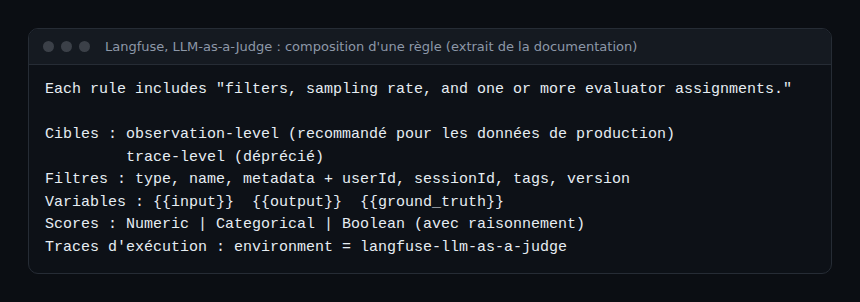
تصف وثائق Langfuse قاعدة التقييم المباشر بأنها مجموعة من المرشّحات (filters)، ونسبة أخذ العيّنات، وتعيين مُقيِّم واحد أو أكثر. هذا التقسيم مفيد حتى خارج هذه الأداة لأنه يطرح الأسئلة الصحيحة.
استهداف الخطوة المهمة
توصي Langfuse باستخدام مُقيِّمين على مستوى الملاحظة (observation) لبيانات الإنتاج، وتشير إلى أن المُقيِّمين على مستوى التتبع (trace) صاروا مهجورين. عمليًا، قيّم الردّ النهائي للنموذج لا كل استدعاء وسيط يجريه الوكيل. وتضيف الصفحة أن المُقيِّم على مستوى الملاحظة لا يحمّل الملاحظات الشقيقة أو الفرعية: لذلك يجب أن تكون كل المعلومات المفيدة موجودة في المدخل والمخرج المُقيَّمين.
التصفية قبل أخذ العيّنات
تتناول المرشّحات المتاحة نوع الملاحظة واسمها وبياناتها الوصفية، إضافة إلى المستخدم والجلسة والوسوم (tags) وإصدار التتبع. والمرشّح على الإصدار ثمين: بعد تغيير في الـ prompt أو النموذج، يُقيَّم الإصدار الجديد أكثر، ثم تنخفض النسبة عند عودة الثقة. لمعرفة كيف تعمل التتبعات والمعرّفات، راجع مقالة Langfuse وOpenLLMetry.
أخذ العيّنات بطريقة قابلة للتكرار
السحب العشوائي الصرف يصعّب المقارنات. أما أخذ العيّنات الحتمي بالاعتماد على معرّف التتبع فيضمن أن يُقيَّم التتبع نفسه دائمًا أو لا يُقيَّم أبدًا، أيًّا كانت الخدمة التي تقرر. المثال أدناه مخطط تعليمي من span.observer وليس دالة من مكتبة.
import hashlib

def a_noter(trace_id: str, taux: float) -> bool:
    # Vrai pour environ `taux` des traces, de façon stable.
    h = int(hashlib.sha256(trace_id.encode()).hexdigest(), 16)
    return (h % 10_000) < int(taux * 10_000)

# 5 % du trafic courant, 100 % des traces signalées (erreur, retour négatif)
taux = 1.0 if est_signalee else 0.05
if a_noter(trace_id, taux):
    envoyer_au_juge(trace_id)
تكفي غالبًا شريحتان: نسبة صغيرة من الحركة العادية، وجميع الحالات المشبوهة أصلًا (ملاحظات سلبية، أخطاء، إصدار حديث). وهو المنطق نفسه المتّبع في أخذ عيّنات التتبعات: الاحتفاظ بما هو نادر ومفيد.
معايرة القاضي قبل الوثوق به
القاضي ليس أداة محايدة. فالورقة البحثية «Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena» تذكر أربعة مواضع ضعف: الحساسية لترتيب الردود، وتفضيل الردود الطويلة، والمحاباة لمخرجاته هو، وضعف الاستدلال. ويفيد مؤلفوها كذلك بأن قاضيًا قويًا مثل GPT-4 يبلغ اتفاقًا يفوق 80% مع البشر، وهو مستوى الاتفاق نفسه بين البشر. هذا الرقم مصدره دراستهم ومجموعات بياناتهم. ولا ينتقل إلى معيارك ولا إلى ردودك.
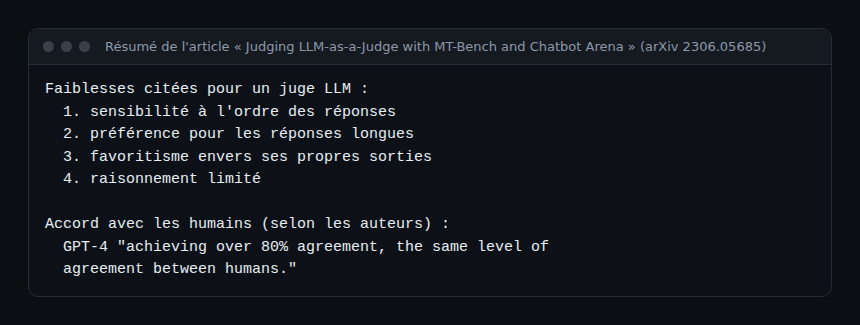
تعطي صفحة Langfuse التوجيه العملي نفسه: تحقق من prompt القاضي بأمثلة موسومة قبل استخدامه. وهذه طريقة موجزة.
- أنشئ مجموعة ذهبية: بضع عشرات من الردود الحقيقية يوسمها شخص يعرف المجال.
- اكتب معيارًا ضيقًا: معيار واحد لكل قاضٍ (مثل الأمانة للسياق)، بدرجة منطقية أو فئوية بدل علامة من عشرة.
- قارن درجات القاضي بالوسوم البشرية، واقرأ حالات الاختلاف واحدة واحدة.
- صحّح المعيار ثم أعد المحاولة. وكرّر هذا الفحص مع كل تغيير لنموذج القاضي.
- راجع عيّنة كل أسبوع: فانحراف الحركة مع الزمن يُفقد القاضي توافقه.
الدرجات الفئوية والمنطقية، التي تقدمها Langfuse إضافة إلى الدرجات الرقمية، أسهل معايرة: فالاختلاف فيها واضح. وترتبط الدرجة بتتبع (trace) أو بملاحظة (observation) أو بجلسة أو بتشغيل لمجموعة بيانات، وفق نموذج بيانات Langfuse.
خفض كلفة كل درجة
- قاضٍ أرخص حين يكون المعيار بسيطًا. تشير صفحة Langfuse إلى أن المُقيِّم يستخدم النموذج الافتراضي للمشروع ما لم يُختر نموذج مخصص. جرّب نموذجًا أصغر على المجموعة الذهبية واحتفظ به إذا اتفق بما يكفي مع البشر.
- مدخلات قصيرة: أرسل السؤال والجواب ومقاطع السياق المستخدمة فعلًا فقط.
- فحوصات حتمية أولًا: JSON صالح، الطول، وجود اقتباس. وما يمكن اختباره بالشيفرة لا يحتاج إلى قاضٍ.
- عتبة تشغيل: قيّم فقط الردود التي اجتازت الفحوصات البسيطة.
لربط هذه الخيارات بالرموز (tokens) المستهلكة، تبيّن مقالة كلفة وكيل الذكاء الاصطناعي كيف تُتابع الرموز عبر OpenTelemetry.
مراقبة القاضي نفسه
القاضي المتعطل ينتج لوحة مراقبة فارغة يُظن خطأً أنها خبر جيد. تشغّل Langfuse المُقيِّمين في الـ worker الخاص بها لا في التطبيق. وكل تشغيل ينشئ تتبعًا: تنصح الوثائق بتصفية البيئة langfuse-llm-as-a-judge في جدول التتبعات. الحالات هي Completed وError وDelayed (حد المعدل، إعادة المحاولة) وPending. وتوضح الصفحة أيضًا أن تتبعات التشغيل تتيح مراقبة استهلاك الرموز.
أربع إشارات تُتابع، أيًّا كانت الأداة:
- عدد الدرجات المنتجة في الساعة، مقارنةً بنسبة أخذ العيّنات المتوقعة؛
- حصة عمليات التشغيل التي انتهت بخطأ أو التي في الانتظار؛
- الرموز التي يستهلكها القاضي، منفصلة عن رموز التطبيق؛
- توزيع الدرجات: فالتحول المفاجئ يشير غالبًا إلى تغيير في الـ prompt أو النموذج.
إذا استُدعي القاضي عبر SDK مزوّد بأدوات OpenTelemetry، فيمكن لمدة الاستدعاء أن تغذي المدرج التكراري gen_ai.client.operation.duration (الوحدة s). وبحسب مواصفة OpenTelemetry GenAI، لا تزال هذه المقياس بحالة Development: قد تتغير أسماؤه. لا تصف هذه المقالة أي تكامل موثق مع Dynatrace لدرجات القاضي. يمكن لفريق يستخدم Dynatrace أن ينشر درجاته كسمات أو مقاييس عبر OpenTelemetry، بشرط أن يحدد المخطط بنفسه. وتكمّل حواجز الأمان لوكلاء الذكاء الاصطناعي هذه المراقبة.
أفضل الممارسات
- قاضٍ واحد لكل معيار، بمعيار قصير ومخرجات فئوية.
- مجموعة ذهبية بشرية، تُراجع مع كل تغيير في النموذج أو الـ prompt.
- ميزانية صريحة: عدد الدرجات يوميًا والحد الأقصى للرموز، مع تنبيه عند التجاوز.
- قاضٍ من عائلة نماذج مختلفة عن النموذج المُقيَّم، للحد من المحاباة لمخرجاته.
- تُستخدم الدرجات لرصد الاتجاهات وتوجيه المراجعة البشرية، لا لاتخاذ قرار الحظر وحدها.
الأسئلة الشائعة
هل يجب تقييم 100% من الردود في الإنتاج؟
نادرًا. تعطي عيّنة ثابتة من الحركة العادية، مع جميع الحالات المشبوهة، إشارة قابلة للاستخدام بكلفة محدودة. وتتيح Langfuse فعلًا نسبة أخذ عيّنات في كل قاعدة تقييم.
هل يمكن للقاضي LLM أن يحل محل التقييم البشري؟
لا. إنه يمدّه فقط. فمؤلفو ورقة MT-Bench يفيدون باتفاق مرتفع مع البشر لدى قاضٍ قوي، لكنهم يصفون أيضًا انحيازات. ويبقى التحقق البشري المنتظم ضروريًا للحفاظ على توافق القاضي.
كيف أعرف أن القاضي يكلّف أكثر من اللازم؟
قِس رموز القاضي وعدد استدعاءاته بمعزل عن التطبيق، ثم قارنها بحجم التتبعات. فإذا اقتربت كلفة القاضي من كلفة التطبيق، فخفّض نسبة أخذ العيّنات، أو قصّر المدخلات، أو جرّب نموذجًا أصغر.
الخلاصة
يبقى LLM-as-judge في الإنتاج خدمة قائمة بذاتها، لها ميزانية وأخطاء وانحراف محتمل. ويمنح أخذ العيّنات واستهداف الخطوة والمعايرة على مجموعة بشرية إشارة مفيدة بكلفة مضبوطة.
المصادر
- LLM-as-a-Judge، وثائق Langfuse
- نموذج بيانات التقييم، وثائق Langfuse
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena، arXiv
- اتفاقيات OpenTelemetry الدلالية لـ GenAI
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC ولا لـ Langfuse. Dynatrace علامة تجارية لشركة Dynatrace LLC. أسماء المنتجات المذكورة تعود إلى مالكيها، والشيفرة مثال تعليمي. تحقق دائمًا من القيم في الوثائق الرسمية الخاصة بإصدارك.