El LLM-as-judge en producción consiste en pedir a un segundo modelo de lenguaje que puntúe las respuestas reales de una aplicación de IA generativa. La idea es atractiva: una nota automática sustituye la revisión humana. Pero cada nota es en sí misma una llamada a un modelo, es decir, un coste y una latencia más. Sin un marco, el juez puede costar tanto como la aplicación que vigila.
Este artículo propone un método para mantener ese coste bajo control: puntuar una muestra, apuntar a las etapas adecuadas, calibrar el juez con ejemplos humanos y medir el juez como cualquier otro servicio. Complementa el artículo sobre la evaluación de un RAG con LlamaIndex, que trata sobre todo la evaluación fuera de línea. Aquí el enfoque es la operación continua, desde el lado SRE.
Resumen
- Un juez LLM recibe una rúbrica, la entrada, la salida y, si hace falta, una referencia; devuelve una puntuación y una justificación.
- En producción, el presupuesto se regula con el muestreo, la selección de observaciones y la elección del modelo juez.
- Un juez tiene sesgos documentados: hay que calibrarlo con ejemplos etiquetados antes de fiarse de él.
- El juez debe observarse: coste, duración, errores, cola de espera.
LLM-as-judge en producción: lo que cuesta un juez
Según la documentación de Langfuse, un juez recibe una rúbrica de evaluación, la entrada, la salida que se evalúa y una referencia opcional. Devuelve una puntuación acompañada de un razonamiento. La misma página precisa que el coste depende del modelo juez y del tamaño de las entradas. De ahí se derivan dos palancas: reducir el número de notas y reducir el volumen enviado al juez.
La diferencia con la evaluación fuera de línea es sencilla. Fuera de línea, se vuelve a ejecutar un conjunto de pruebas fijo antes de una puesta en producción. En producción, el tráfico es abierto, voluminoso y cambia sin cesar. Puntuar cada petición no es necesario ni deseable. Hay que decidir qué puntuar, con qué frecuencia y con qué modelo.
Elegir qué puntuar
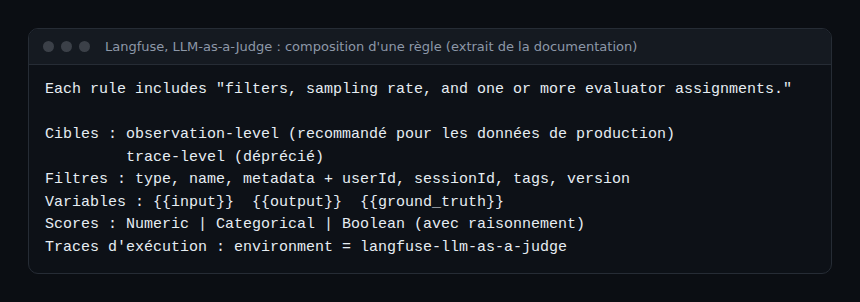
La documentación de Langfuse describe una regla de evaluación en vivo como un conjunto de filtros, una tasa de muestreo y una o varias asignaciones de evaluadores. Este reparto es útil incluso fuera de esa herramienta, porque plantea las preguntas correctas.
Apuntar a la etapa que importa
Langfuse recomienda evaluadores a nivel de observación para los datos de producción e indica que los de nivel de traza están obsoletos. En concreto, puntúa la respuesta final del modelo, no cada llamada intermedia de un agente. La página añade que un evaluador a nivel de observación no carga las observaciones hermanas ni hijas: toda la información útil debe figurar, por tanto, en la entrada y la salida evaluadas.
Filtrar antes de muestrear
Los filtros disponibles se refieren al tipo, el nombre y los metadatos de la observación, así como al usuario, la sesión, las etiquetas y la versión de la traza. Un filtro por versión es valioso: tras un cambio de prompt o de modelo, se puntúa más la versión nueva y luego se baja el ritmo cuando la confianza se restablece. Para el funcionamiento de las trazas y los identificadores, consulta el artículo sobre Langfuse y OpenLLMetry.
Muestrear de forma reproducible
Un sorteo puramente aleatorio dificulta las comparaciones. Un muestreo determinista sobre el identificador de traza garantiza que una misma traza se puntúe siempre, o nunca, sea cual sea el servicio que decide. El ejemplo siguiente es un esquema pedagógico de span.observer, no una función de una biblioteca.
import hashlib

def a_noter(trace_id: str, taux: float) -> bool:
    # Vrai pour environ `taux` des traces, de façon stable.
    h = int(hashlib.sha256(trace_id.encode()).hexdigest(), 16)
    return (h % 10_000) < int(taux * 10_000)

# 5 % du trafic courant, 100 % des traces signalées (erreur, retour négatif)
taux = 1.0 if est_signalee else 0.05
if a_noter(trace_id, taux):
    envoyer_au_juge(trace_id)
Suelen bastar dos estratos: un pequeño porcentaje del tráfico ordinario y la totalidad de los casos ya sospechosos (valoraciones negativas, errores, versión reciente). Es el mismo razonamiento que para el muestreo de trazas: conservar lo que es raro y útil.
Calibrar el juez antes de confiar en él
Un juez no es un instrumento neutro. El artículo de investigación «Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena» nombra cuatro debilidades: la sensibilidad al orden de las respuestas, la preferencia por las respuestas largas, el favoritismo hacia sus propias salidas y un razonamiento limitado. Sus autores también indican que un juez fuerte como GPT-4 alcanza más de un 80 % de acuerdo con los humanos, el mismo nivel de acuerdo que hay entre humanos. Esa cifra procede de su estudio y de sus conjuntos de datos. No se traslada a tu rúbrica ni a tus respuestas.
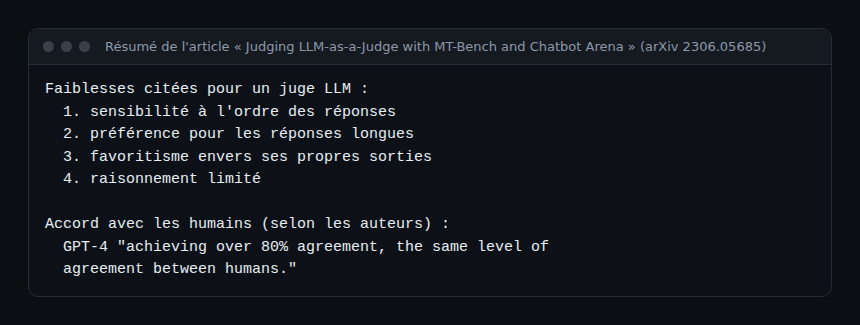
La página de Langfuse da la misma consigna práctica: comprobar el prompt del juez con ejemplos etiquetados antes de usarlo. Aquí tienes un método breve.
- Constituir un conjunto de oro: unas decenas de respuestas reales, etiquetadas por una persona que conozca el oficio.
- Redactar una rúbrica estrecha: un criterio por juez (por ejemplo, la fidelidad al contexto), con una puntuación booleana o categórica en lugar de una nota sobre diez.
- Comparar las notas del juez con las etiquetas humanas y leer los desacuerdos uno por uno.
- Corregir la rúbrica y volver a empezar. Repetir esta comprobación con cada cambio de modelo juez.
- Revisar una muestra cada semana: la deriva del tráfico acaba por desalinear al juez.
Las puntuaciones categóricas y booleanas, que Langfuse ofrece además de las numéricas, se calibran con más facilidad: el desacuerdo es nítido. Una puntuación se asocia a una traza, a una observación, a una sesión o a una ejecución de un conjunto de datos, según el modelo de datos de Langfuse.
Reducir el precio de cada nota
- Un juez más barato cuando la rúbrica es sencilla. La página de Langfuse indica que un evaluador usa el modelo por defecto del proyecto, salvo que se elija uno dedicado. Prueba un modelo más pequeño con el conjunto de oro y consérvalo si coincide lo bastante con los humanos.
- Entradas cortas: envía solo la pregunta, la respuesta y los pasajes de contexto realmente usados.
- Comprobaciones deterministas primero: JSON válido, longitud, presencia de una cita. Lo que se puede probar con código no necesita un juez.
- Un umbral de activación: puntúa solo las respuestas que han pasado los controles simples.
Para relacionar estas decisiones con los tokens consumidos, el artículo sobre el coste de un agente de IA muestra cómo seguir los tokens con OpenTelemetry.
Observar al propio juez
Un juez averiado produce un dashboard vacío que se toma por error como una buena noticia. Langfuse ejecuta los evaluadores en su worker, no en la aplicación. Cada ejecución crea una traza: la documentación indica filtrar el entorno langfuse-llm-as-a-judge en la tabla de trazas. Los estados son Completed, Error, Delayed (límite de tasa, nuevo intento) y Pending. Esa página precisa también que las trazas de ejecución permiten vigilar el consumo de tokens.
Cuatro señales que seguir, sea cual sea la herramienta:
- el número de notas producidas por hora, comparado con la tasa de muestreo esperada;
- la proporción de ejecuciones en error o en espera;
- los tokens consumidos por el juez, separados de los de la aplicación;
- la distribución de las puntuaciones: un cambio brusco suele indicar un cambio de prompt o de modelo.
Si el juez se invoca mediante un SDK instrumentado con OpenTelemetry, la duración de la llamada puede alimentar el histograma gen_ai.client.operation.duration (unidad s). Según la especificación OpenTelemetry GenAI, esta métrica sigue en estado Development: sus nombres pueden cambiar. Esta entrada no describe ninguna integración de Dynatrace documentada para las puntuaciones de juez. Un equipo que use Dynatrace puede publicar sus puntuaciones como atributos o métricas mediante OpenTelemetry, siempre que defina él mismo el esquema. Las barreras de seguridad de los agentes de IA complementan esta vigilancia.
Buenas prácticas
- Un juez por criterio, con una rúbrica corta y salidas categóricas.
- Un conjunto de oro humano, revisado con cada cambio de modelo o de prompt.
- Un presupuesto explícito: notas por día y tokens máximos, con alerta si se supera.
- Un juez de una familia distinta a la del modelo evaluado, para limitar el favoritismo hacia sus propias salidas.
- Las notas sirven para detectar tendencias y orientar la revisión humana, no para decidir por sí solas un bloqueo.
Preguntas frecuentes
¿Hay que puntuar el 100 % de las respuestas en producción?
Rara vez. Una muestra estable del tráfico ordinario, más la totalidad de los casos sospechosos, da una señal aprovechable a un coste acotado. De hecho, Langfuse ofrece una tasa de muestreo en cada regla de evaluación.
¿Puede un juez LLM sustituir la evaluación humana?
No. La prolonga. Los autores del artículo MT-Bench indican un alto acuerdo con los humanos para un juez potente, pero también describen sesgos. Sigue siendo necesario un control humano regular para mantener alineado al juez.
¿Cómo saber si el juez cuesta demasiado?
Mide los tokens y el número de llamadas del juez por separado de la aplicación y luego relaciónalos con el volumen de trazas. Si el juez se acerca al coste de la aplicación, reduce la tasa de muestreo, acorta las entradas o prueba un modelo más pequeño.
Conclusión
Un LLM-as-judge en producción sigue siendo un servicio de pleno derecho, con un presupuesto, errores y una posible deriva. El muestreo, la selección de la etapa y la calibración con un conjunto humano dan una señal útil a un coste controlado.
Fuentes
- LLM-as-a-Judge, documentación de Langfuse
- Modelo de datos de la evaluación, documentación de Langfuse
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, arXiv
- Convenciones semánticas de OpenTelemetry GenAI
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Langfuse. Dynatrace es una marca de Dynatrace LLC. Los nombres de productos citados pertenecen a sus respectivos propietarios; el código es un ejemplo pedagógico. Comprueba siempre los valores en la documentación oficial correspondiente a tu versión.