Une passerelle LLM est un proxy placé entre vos applications et les fournisseurs de modèles : toutes les requêtes passent par un point unique, qui peut compter les tokens, attribuer chaque dépense à une équipe et couper un budget dépassé. Pour un SRE, c’est le moyen le plus direct de répondre à la question « qui consomme quoi, et pourquoi la facture a doublé ? » sans modifier le code de chaque service. Cet article compare deux projets open source, LiteLLM et Helicone, sur ce seul usage : suivre les coûts.
Le principe est le même qu’une API gateway classique : l’identité de l’appelant (clé virtuelle, en-tête) devient une dimension de la métrique. Sans elle, un compteur de tokens global ne dit rien de l’équipe fautive. Avec elle, un budget par clé et une alerte par équipe deviennent possibles.
Précision d’honnêteté : span.observer n’a déployé ni LiteLLM ni Helicone pour cet article. Les extraits, noms de métriques et en-têtes viennent des pages officielles de documentation consultées le 31 octobre 2026. Aucun chiffre de coût n’est mesuré ici.
Passerelle LLM : ce que les deux projets proposent
- LiteLLM : le dépôt
BerriAI/litellmaffiche environ 62 400 étoiles à la date de consultation. Le fichier LICENSE indique la licence MIT, sauf le dossierenterprise/, soumis à sa propre licence. Le README présente le proxy comme une « AI Gateway » auto-hébergée pour plus de 100 LLM, derrière une interface au format OpenAI, avec clés virtuelles, suivi des dépenses, garde-fous, répartition de charge et interface d’administration. Les versions publiées ne sont pas reprises ici : la page du dépôt n’en affichait aucune de façon fiable. - Helicone : le dépôt
Helicone/heliconeest sous licence Apache 2.0 (fichier LICENSE lu), avec environ 6 200 étoiles. Il se décrit comme une plateforme d’AI Gateway et d’observabilité LLM. La documentation donne l’URLhttps://ai-gateway.helicone.aicomme base pour un client compatible OpenAI. Le dépôt propose un déploiement Docker Compose ; le chart Helm de production est réservé aux clients entreprise, selon le README.
La différence de fond tient à la façon dont chacun conserve les données. LiteLLM garde ses lignes de dépense dans votre base PostgreSQL et expose des métriques Prometheus que vous collectez vous-même. Helicone, dans l’usage décrit par sa documentation, centralise coûts et usage dans son propre tableau de bord ; l’option auto-hébergée existe mais n’a pas été détaillée dans les pages lues. Ce point est à vérifier avant tout choix.
Mettre en place LiteLLM pour suivre les coûts
Prérequis
Une base PostgreSQL et la variable DATABASE_URL : la documentation des clés virtuelles indique qu’elles sont nécessaires pour générer des clés, et le suivi des dépenses repose sur la même base. Le format attendu est postgresql://<user>:<password>@<host>:<port>/<dbname>.
Étape 1 — Déclarer les modèles et activer les métriques
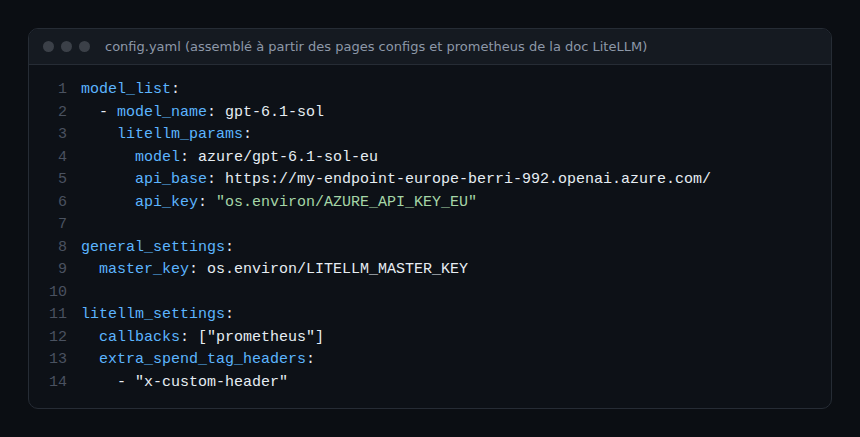
Le fichier de configuration liste les modèles exposés, une clé maître et les callbacks. La capture assemble les exemples des pages « configs » et « prometheus » de la documentation ; les noms de modèles viennent de la documentation et sont fictifs.
Lignes à retenir :
master_keylit sa valeur dans l’environnement (préfixeos.environ/) : aucune clé en clair dans le fichier.callbacks: ["prometheus"]active l’endpoint/metricssur le port du proxy.extra_spend_tag_headerstransforme un en-tête de requête (icix-custom-header) en étiquette de dépense, par exemple pour un identifiant de projet.
Démarrage, d’après la documentation :
export DATABASE_URL="postgresql://user:password@localhost:5432/litellm"
litellm --config /path/to/config.yaml
Étape 2 — Créer une clé par équipe avec un budget
La dépense est attribuée à la clé virtuelle, puis à son utilisateur et à son équipe. La documentation donne l’appel /key/generate avec la clé maître en en-tête Authorization ; max_budget et budget_duration y figurent comme paramètres de requête, mais pas dans un exemple unique :
curl 'http://0.0.0.0:4000/key/generate' \
  --header 'Authorization: Bearer <your-master-key>' \
  --header 'Content-Type: application/json' \
  --data-raw '{"models": ["gpt-6.1-sol"], "max_budget": 10, "budget_duration": "30d", "metadata": {"user": "equipe-plateforme"}}'
Les valeurs 10 et 30d sont des exemples à adapter, et le nom du modèle est celui de la documentation. Chaque application ou équipe reçoit ainsi sa propre clé : c’est ce qui rend la dépense lisible. Attention à la remarque de la documentation : le paramètre user d’une requête est enregistré comme utilisateur final, mais ne modifie pas les totaux du propriétaire de la clé. Pour un suivi par utilisateur fiable, il faut renseigner user_id à la création des clés.
Étape 3 — Étiqueter les requêtes
Chaque appel écrit une ligne dans la table LiteLLM_SpendLogs : clé hachée, utilisateur, équipe, étiquettes, modèle, dépense et nombre de tokens. Les étiquettes se passent par requête via metadata.tags, par clé ou équipe à la création, ou par en-tête avec extra_spend_tag_headers. La réponse porte aussi le coût calculé dans l’en-tête x-litellm-response-cost. Pour relire les lignes : GET /spend/logs (avec summarize=false pour le détail) ou GET /spend/logs/v2 paginé, dont la documentation signale un total plafonné à 10 000.
Comment vérifier que ça fonctionne
Après quelques requêtes, interrogez l’endpoint de métriques. La documentation précise que, depuis la version 1.85.0, /metrics exige par défaut une clé d’API LiteLLM : ajoutez un bloc authorization de type Bearer à la configuration de scrape Prometheus. La page de référence liste notamment :
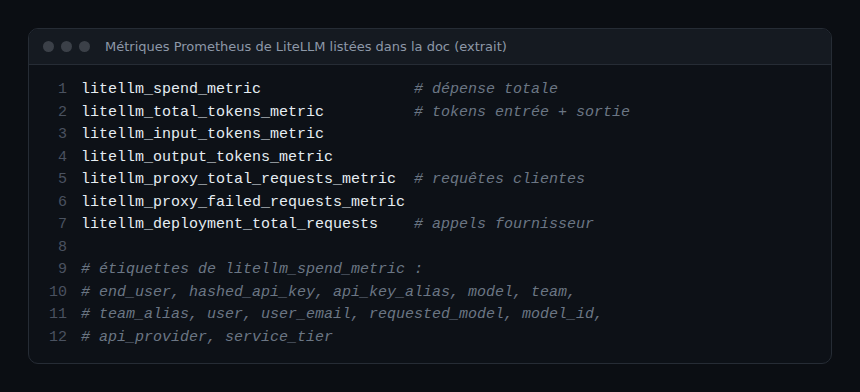
La page indique que ces compteurs s’interrogent avec le suffixe _total dans les requêtes PromQL. Une requête utile pour l’équipe finance interne, à valider sur votre instance : la somme de litellm_spend_metric_total groupée par team_alias et model, sur une fenêtre de 24 heures. Un compteur litellm_zero_cost_requests_total signale en outre les requêtes qui ont consommé des tokens sans être valorisées : un modèle absent de la table de prix fausserait sinon vos totaux sans bruit.
Les métriques de dépense ne sont pas marquées « enterprise » sur la page lue, contrairement aux métriques de batch gérés. Les étiquettes (team, api_key_alias, model, user_email…) sont nombreuses : surveillez la cardinalité de votre Prometheus avant de tout activer, voir OpenTelemetry et Prometheus.
Helicone : le suivi par en-têtes
Avec Helicone, la configuration côté client se réduit à deux changements : l’URL de base et la clé. Les dimensions de coût passent par des en-têtes : Helicone-User-Id, réservé au suivi par utilisateur, et Helicone-Property-[Nom] pour toute propriété personnalisée, comme l’environnement ou l’application.
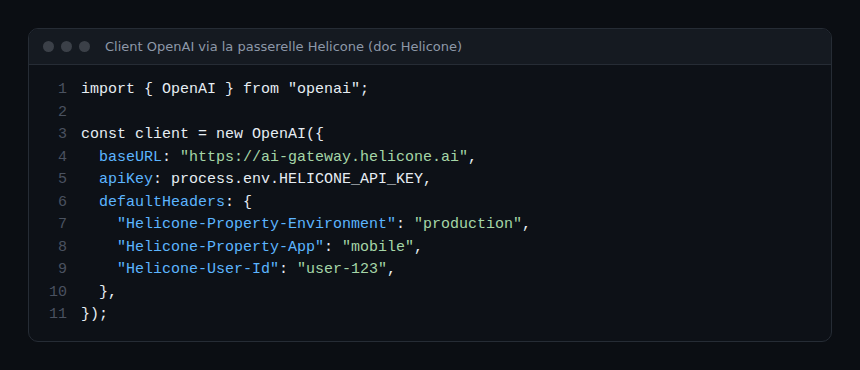
La documentation de la passerelle affirme suivre usage, coûts et performances de tous les fournisseurs dans un tableau de bord et annonce une marge de 0 % sur les tokens avec ses crédits, face à 5,5 % pour OpenRouter : ces chiffres sont ceux de l’éditeur, non vérifiés ici. Une page voisine, consacrée au mode proxy historique (gateway.helicone.ai avec l’en-tête Helicone-Target-Url), signale que la valorisation des coûts n’est pas prise en charge pour plusieurs fournisseurs, dont AWS Bedrock et Cohere. Avant d’adopter l’un ou l’autre, vérifiez que vos fournisseurs et modèles sont couverts.
Et la trace côté OpenTelemetry et Dynatrace ?
La documentation LiteLLM prévoit un callback otel : callbacks: ["otel"], avec des variables d’environnement. Pour un collecteur OTLP HTTP, la page utilise OTEL_EXPORTER_OTLP_ENDPOINT, OTEL_EXPORTER_OTLP_PROTOCOL et OTEL_EXPORTER_OTLP_HEADERS. La page ne fournit pas de configuration complète : testez-la avant de vous y fier. L’export gRPC demande le paquet grpcio.
Côté Dynatrace SaaS, la documentation d’export OTLP donne la base https://{id-environnement}.live.dynatrace.com/api/v2/otlp avec les chemins /v1/traces, /v1/metrics et /v1/logs. Elle précise que gRPC n’est pas pris en charge et que le format est Protobuf binaire ; elle recommande un Collector pour convertir. Le jeton se passe en Authorization=Bearer ; les droits d’ingestion listés par la page sont de la famille openpipeline:…:ingest, à contrôler dans la documentation des jetons de votre version. Pour Managed, cette page ne donne pas d’URL : se reporter à la documentation Managed. Aucune intégration Dynatrace propre à LiteLLM ou Helicone n’a été trouvée dans les pages lues ; seul OTLP est documenté.
Le chemin le plus sûr est donc passerelle → Collector OpenTelemetry → Dynatrace. Pour relier les tokens et les coûts aux traces d’un agent, voir le coût d’un agent IA en OpenTelemetry, et pour le même rôle de point de contrôle sur les outils MCP, agentgateway. Si la trace détaillée des prompts compte plus que la dépense, Langfuse et OpenLLMetry répondent à un autre besoin.
Bonnes pratiques
- Une clé virtuelle par application et par équipe : sans elle, la dépense ne s’attribue à personne.
- Fixez un budget par clé dès le départ, et alertez avant le plafond plutôt qu’au refus des requêtes (un budget atteint coupe un service : c’est un risque de disponibilité, pas seulement de coût).
- Limitez les étiquettes de métriques à celles dont vous avez besoin : l’équipe et le modèle suffisent souvent.
- Surveillez les requêtes à coût nul : un modèle non valorisé fausse le suivi.
- Traitez la passerelle comme un composant critique : elle devient un point unique de passage, donc de panne. Prévoyez des réplicas, une alerte sur le taux d’échec (
litellm_proxy_failed_requests_metric) et une version épinglée. - Ne journalisez pas les prompts sans politique de rétention : ils contiennent souvent des données personnelles.
Questions fréquentes
Une passerelle LLM remplace-t-elle l’observabilité de l’application ?
Non. Elle compte tokens, coûts et erreurs au niveau des appels aux modèles. Elle ne dit rien du reste de la requête utilisateur : les traces applicatives restent nécessaires pour situer la latence.
LiteLLM ou Helicone pour suivre les coûts ?
Selon leur documentation, LiteLLM s’auto-héberge avec votre PostgreSQL et expose des métriques Prometheus ; Helicone s’utilise par changement d’URL et d’en-têtes avec son tableau de bord. Le choix dépend de l’endroit où vous voulez conserver les données et de la couverture de vos fournisseurs.
Peut-on envoyer ces données à Dynatrace ?
Par OTLP uniquement, d’après les pages lues, et pas en gRPC direct : passez par un Collector qui convertit vers OTLP/HTTP. Aucun connecteur dédié n’est documenté.
Conclusion
Une passerelle LLM donne enfin une dimension « équipe » et « application » aux coûts de modèles, à condition de créer des clés distinctes, d’étiqueter les requêtes et de scruter la valorisation des tokens. LiteLLM s’intègre naturellement à une pile Prometheus, Helicone se branche plus vite mais déplace la donnée. Sources : métriques Prometheus LiteLLM, suivi des dépenses LiteLLM, passerelle Helicone et export OTLP vers Dynatrace.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC, à BerriAI ni à Helicone. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans leur documentation officielle.