
Un jour, un ticket arrive : « la trace de l’appel au partenaire est coupée en plein milieu dans les logs ». Vous ouvrez l’enregistrement et vous constatez qu’il s’arrête net. La charge utile dépassait une limite quelque part. Les logs volumineux Dynatrace posent exactement cette question d’exploitation : jusqu’à quelle taille un enregistrement passe-t-il, et sur quel chemin ?
Cet article part de cette décision (garder, découper ou réduire un enregistrement) et vérifie chaque chiffre sur la documentation officielle, lue le 12 novembre 2026. Il vaut pour Dynatrace SaaS (Grail et OpenPipeline). Je n’ai pas vérifié les limites de Dynatrace Managed pour cet article : je n’en cite aucune.
Si les notions de coût vous manquent, lisez d’abord le coût des logs : ingestion, rétention et requêtes.
Le cas typique : un enregistrement de plusieurs centaines de kilo-octets
Un message XML de facturation, une réponse JSON d’API de partenaire, une pile d’appels avec le contexte complet : ces événements dépassent vite le kilo-octet. Le billet de l’éditeur place cette zone entre quelques centaines de kilo-octets et plusieurs mégaoctets. Longtemps, la réponse par défaut était de tronquer ou de découper en amont, au prix d’un contexte perdu.
Le même billet annonce la prise en charge native d’événements de log allant jusqu’à 10 Mo, sans configuration, par OneAgent, OpenTelemetry, l’API ou d’autres collecteurs. C’est un texte de présentation de l’éditeur : il ne dit pas ce qui arrive au-delà de 10 Mo. La documentation de référence, elle, précise les conditions.
Logs volumineux Dynatrace : les limites à vérifier
La page des limites par défaut de Log Management and Analytics donne ces valeurs :
- Corps de l’entrée (content) : 10 Mo, mais 512 ko pour les logs traités par le pipeline Classic.
- Requête vers l’API : 10 Mo au point d’entrée ; un lot qui dépasse 16 Mo après prétraitement est rejeté avec un code HTTP 413.
- Enregistrements par requête : 50 000.
- Attributs : 500 par log, valeur d’un attribut limitée à 32 ko, clé à 100 octets, 5 niveaux d’objets imbriqués.
- Taille après traitement dans OpenPipeline : 16 Mo, d’après la page des limites d’OpenPipeline.
Retenez la première ligne : « 10 Mo » n’est pas une promesse universelle. Le chemin Classic reste à 512 ko. Si un log long disparaît ou s’arrête net, vérifiez d’abord par quel pipeline il passe.
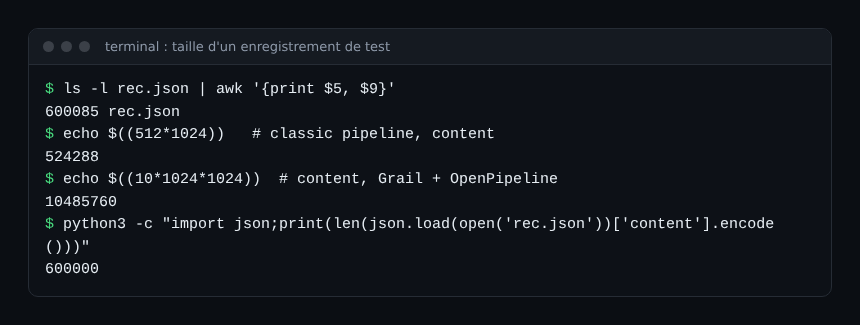
Cette capture est la sortie réelle de commandes lancées sur un fichier de test. L’enregistrement de 600 000 octets dépasse la limite Classic, mais reste très en dessous des 10 Mo.
Envoyer un gros enregistrement et vérifier la taille
Voici la marche à suivre pour tester sur un environnement de préproduction.
- Créez un jeton d’API avec le scope d’ingestion de logs, et gardez-le dans une variable d’environnement.
- Construisez un fichier JSON avec un champ
contentvolumineux. - Envoyez-le avec
curlvers l’API d’ingestion et notez le code de retour. - Interrogez les logs en DQL pour mesurer la longueur du contenu reçu.
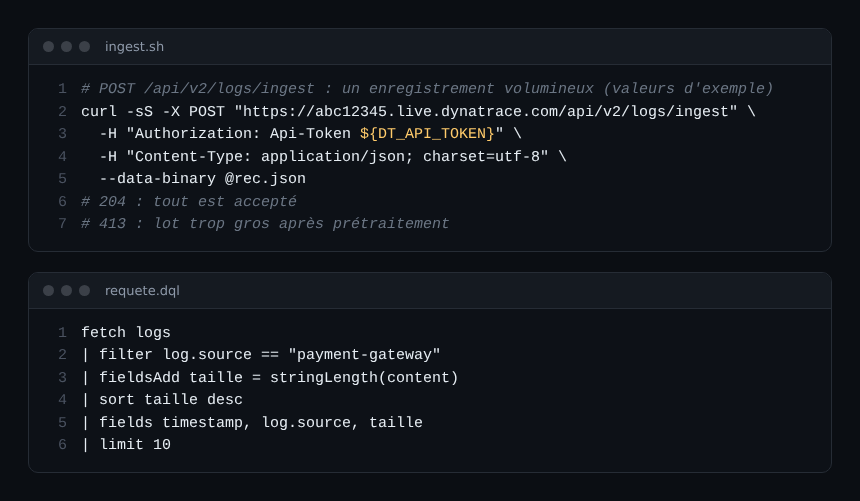
fetch logs
| filter log.source == "payment-gateway"
| fieldsAdd taille = stringLength(content)
| sort taille desc
| limit 10
Le code 204 signifie que tout a été accepté. La documentation indique aussi des codes 400 ou 200 selon que tout ou partie des événements sont hors plage de dates. Si la taille mesurée est inférieure à celle envoyée, une limite a coupé le contenu : revenez au tableau ci-dessus. Pour la syntaxe, voyez l’analyse des patterns de logs.
Que faire d’un log énorme une fois ingéré ?
Un enregistrement de plusieurs mégaoctets coûte au stockage, à la requête et à la lecture. Posez-vous trois questions dans cet ordre :
- Qui le lit ? Si personne ne lit le corps entier, extrayez les champs utiles (code d’erreur, identifiant de commande) et gardez le reste pour l’enquête.
- Quelle partie est sensible ? Un gros JSON contient souvent des données personnelles. Voyez le masquage dans OpenPipeline.
- Quel est le bon pipeline ? Routez ces logs vers un pipeline dédié, avec des règles propres : créer et router un pipeline.
Attention à deux limites de traitement. Un attribut extrait est tronqué à 4 096 caractères quand il est ajouté au modèle d’événement. Chaque processeur DQL accepte un script de 8 192 caractères au plus, d’après la page des limites d’OpenPipeline.
Bonnes pratiques
- Mesurez d’abord la taille réelle de vos événements les plus gros avant de modifier quoi que ce soit.
- Confirmez le pipeline (Classic ou OpenPipeline) de chaque source qui produit de gros logs.
- Ne comptez pas sur les logs pour transporter des fichiers : un log est un événement, pas un stockage.
- Extrayez les champs utiles à l’ingestion et supprimez le reste quand c’est possible.
- Testez un envoi au-delà de la limite en préproduction pour connaître le comportement réel : la documentation consultée ne le décrit pas pour tous les chemins.
Questions fréquentes
Quelle est la taille maximale d’un log dans Dynatrace ?
D’après la documentation SaaS, le corps d’une entrée peut atteindre 10 Mo, mais 512 ko seulement sur le pipeline Classic. Vérifiez la page des limites avant de vous engager, car elle évolue.
Faut-il découper les logs volumineux avant l’envoi ?
Plus nécessairement sur le chemin à 10 Mo, selon le billet de l’éditeur. Sur le pipeline Classic, la limite de 512 ko s’applique encore. Mesurez avec la requête DQL ci-dessus.
Cela vaut-il pour Dynatrace Managed ?
Cet article ne couvre que le SaaS. Pour Managed, lisez la documentation Managed et ne reprenez pas ces chiffres.
Conclusion
Les logs volumineux Dynatrace passent jusqu’à 10 Mo sur le chemin Grail, mais le pipeline Classic coupe à 512 ko : l’incident du début tient souvent à ce détail. Mesurez, routez, extrayez. Sources : limites par défaut de Log Management and Analytics, limites d’OpenPipeline, et le billet de l’éditeur sur les gros enregistrements.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Les marques citées appartiennent à leurs propriétaires. Les limites évoluent : vérifiez-les dans la documentation officielle.