
Ce soir, l’équipe plateforme draine le nœud node-07 pour une mise à jour du noyau. Une question décide du feu vert : quels services perdent des replicas, et qui prévenir ? Le graphe de topologie Kubernetes de Dynatrace SaaS répond en une requête DQL, à condition de savoir le parcourir. Cet article part de quatre décisions d’exploitation et en tire les requêtes.
Les faits sur la syntaxe viennent de la documentation Dynatrace. Les idées de cas d’usage s’inspirent du billet de l’éditeur sur ce thème. Les requêtes ci-dessous sont réécrites et n’ont pas été exécutées sur un tenant pour cet article : testez-les sur un petit périmètre avant de vous y fier. Ce contenu vaut pour Dynatrace SaaS uniquement.
La syntaxe générale de smartscapeNodes et de traverse est détaillée dans l’article sur DQL et Smartscape. Ici, on ne refait pas le tour des commandes : on s’en sert.
Pourquoi interroger la topologie Kubernetes plutôt que kubectl
Avec kubectl, chaque réponse est un instantané d’un seul cluster. Pour savoir quels services dépendent d’un nœud, vous enchaînez trois commandes, puis vous recoupez à la main. Avec dix clusters, l’exercice devient une corvée.
Le graphe stocke les objets comme des nœuds (K8S_NODE, K8S_POD, K8S_SERVICE, K8S_NAMESPACE, K8S_DEPLOYMENT, K8S_SECRET) et leurs liens comme des arêtes : runs_on relie un pod à son nœud, routes_to un service à ses pods, belongs_to un objet à son namespace, is_part_of un pod à son contrôleur, uses un pod à un Secret. Une seule requête couvre donc tous les clusters rattachés à l’environnement.
Trois éléments de syntaxe à retenir
smartscapeNodes "*"démarre la requête. Le type s’écrit sans guillemets (HOST), entre accolades pour plusieurs types, entre guillemets pour un motif. La documentation précise qu’un motif accepte au plus 64 jokers.traverse arête, type_ciblesuit un lien. Le sens par défaut estforward. Avecdirection: backward, on remonte contre le sens de l’arête, par exemple du nœud vers ses pods.fieldsKeepgarde des champs du nœud de départ dans le tableaudt.traverse.history. Chaquetraverseajoute un enregistrement, etdt.traverse.history[0][name]relit le nom du premier niveau.
Décision 1 : drainer un nœud sans surprise
Avant un drain, vous voulez la liste des services touchés, classés par nombre de pods perdus. On part du nœud, on descend vers ses pods, puis vers les services qui les routent.
smartscapeNodes "*"
| filter type == "K8S_NODE" and name == "node-07"
| traverse runs_on, K8S_POD, direction: backward,
    fieldsKeep: {name, `k8s.namespace.name`, `k8s.cluster.name`}
| traverse routes_to, K8S_SERVICE, direction: backward,
    fieldsKeep: {name}
| fieldsAdd pod = dt.traverse.history[1][name]
| summarize pods_perdus = countDistinctExact(pod),
    by: {service = name,
         namespace = `k8s.namespace.name`,
         cluster = `k8s.cluster.name`}
| sort pods_perdus desc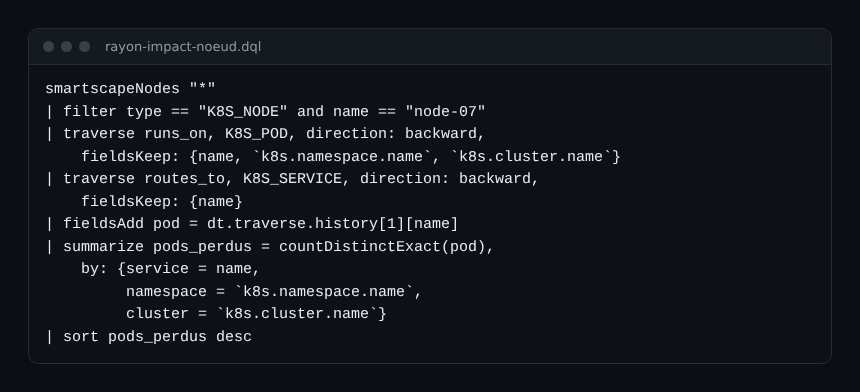
Lisez le résultat avec méthode. Un service qui perd un seul pod sur douze ne vous inquiète pas. Un service qui perd deux pods sur deux justifie de reporter le drain. Un résultat vide peut aussi signifier que le nom du nœud est faux : vérifiez-le d’abord avec smartscapeNodes "*" | filter type == "K8S_NODE".
Décision 2 : qui prévenir, et où chercher
La topologie ne devine pas les responsables. Elle relit les étiquettes que vos équipes posent sur les namespaces. Si le namespace porte une étiquette owner, la requête la sort à côté du cluster :
smartscapeNodes "*"
| filter type == "K8S_NAMESPACE"
| fields namespace = name, cluster = `k8s.cluster.name`, owner = tags[owner]
| sort cluster asc, namespace asc
Chaque ligne sans owner est un trou de gouvernance, pas un bug de la requête. Corrigez-le à la source, par exemple avec l’enrichissement décrit dans l’article sur le metadata enrichment Kubernetes. Joignez ensuite cette liste au résultat de la décision 1 pour savoir qui appeler.
Décision 3 : tourner un Secret sans casser la production
Changer un Secret impose souvent de redémarrer les pods qui le montent. La question est donc : combien de pods et de services en dépendent ? On part des Secrets et on remonte la relation uses.
smartscapeNodes "*"
| filter type == "K8S_SECRET"
| traverse uses, K8S_POD, direction: backward,
    fieldsKeep: {name, `k8s.cluster.name`}
| fieldsAdd pod = name
| traverse routes_to, K8S_SERVICE, direction: backward, fieldsKeep: {name}
| fieldsAdd service = dt.traverse.history[1][name]
| summarize pods = countDistinctExact(pod),
    services = countDistinctExact(service),
    by: {secret = dt.traverse.history[0][name], cluster = `k8s.cluster.name`}
| sort pods desc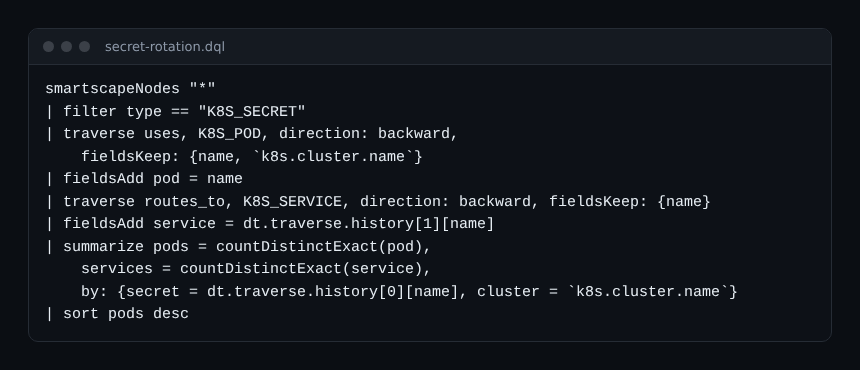
Un Secret monté par quarante pods se tourne en plusieurs vagues. Un Secret monté par deux pods se tourne dans la fenêtre de maintenance habituelle. Le chiffre sert de base de discussion avec les équipes concernées, il ne remplace pas leur avis.
Décision 4 : repérer les risques avant l’incident
Deux requêtes hebdomadaires valent un rituel. La première liste les deployments qui n’ont qu’un pod, donc aucun filet pendant un drain :
smartscapeNodes "*"
| filter type == "K8S_DEPLOYMENT"
| traverse is_part_of, K8S_POD, direction: backward,
    fieldsKeep: {name, `k8s.namespace.name`, `k8s.cluster.name`}
| summarize pods = count(),
    by: {deployment = dt.traverse.history[0][name],
         namespace = `k8s.namespace.name`, cluster = `k8s.cluster.name`}
| filter pods == 1
Limite à connaître : un deployment à zéro pod n’apparaît pas, puisqu’il n’a aucun pod à compter. La seconde requête cherche les pods disparus pendant la dernière journée, grâce au champ lifetime :
smartscapeNodes "*"
| filter type == "K8S_POD"
| fieldsAdd fin = lifetime[end]
| filter fin < now() - 5m and fin > now() - 1d
| fields pod = name, cluster = `k8s.cluster.name`, namespace = `k8s.namespace.name`, fin
| sort fin desc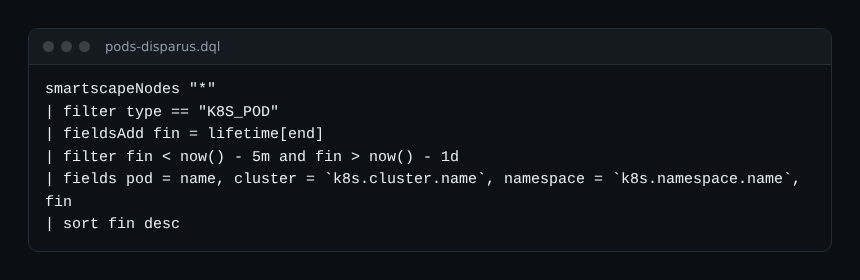
Les seuils de cinq minutes et d’un jour sont des choix : ajustez-les à votre rythme de déploiement. Un pod disparu hors fenêtre de déploiement mérite une question. Pour transformer ces listes en alertes plutôt qu’en lecture manuelle, voyez les alertes Kubernetes sur nœuds, pods et quotas.
Bonnes pratiques pour la topologie Kubernetes en DQL
- Filtrez tôt sur
typeet sur le cluster : untraversesur tout l’environnement coûte plus cher. - Nommez vos champs avec
fieldsAddjuste après chaquetraverse, pour ne pas confondre les indices dedt.traverse.history. - Enregistrez les requêtes utiles dans un Notebook ou un Dashboard. Pour retrouver un identifiant d’entité, voir l’article sur les identifiants d’entité.
- Exécutez chaque requête sur un cluster de test avant de l’automatiser.
Questions fréquentes
Faut-il activer quelque chose pour interroger la topologie Kubernetes ?
Il faut que le monitoring Kubernetes alimente l’environnement SaaS et que votre rôle donne accès à la table Grail smartscape, qui demande la permission storage:smartscape:read selon la documentation. Je n’ai pas vérifié ici la procédure complète d’activation.
Quelle différence entre smartscapeNodes et smartscapeEdges ?
smartscapeNodes renvoie des objets, smartscapeEdges renvoie des liens. Utilisez les arêtes pour inventorier les types de relations disponibles, et traverse pour les suivre d’un objet à l’autre.
Ces requêtes fonctionnent-elles sur Dynatrace Managed ?
Cet article ne couvre que Dynatrace SaaS. Je n’ai pas vérifié la disponibilité de ces commandes sur Managed : ne les y transposez pas sans test.
Conclusion
Un graphe ne sert que s’il répond à une décision. Drainer un nœud, tourner un Secret, repérer un point de défaillance unique : chaque requête ci-dessus remplace un recoupement manuel. Pour les compléter par des tendances chiffrées, relisez les commandes DQL filter, summarize et timeseries. La référence officielle de syntaxe est la page des commandes Smartscape.
Blog indépendant, non affilié à Dynatrace LLC. Dynatrace est une marque de Dynatrace LLC.