
Il est 22 h, un client reçoit un montant faux, les logs ne disent rien et la variable qui explique tout n’est jamais écrite. Reproduire en local prend des heures, redéployer avec un log de plus en prend autant. Le Live Debugger de Dynatrace vise exactement ce cas : lire l’état d’une ligne de code dans l’application qui tourne, sans l’arrêter ni la redéployer.
Cet article part d’une décision d’exploitation : faut-il laisser des développeurs poser des points d’arrêt en production ? La réponse dépend moins de l’outil que des garde-fous. Les faits viennent de la documentation Dynatrace SaaS, lue le 12 novembre 2026, et de l’annonce de l’éditeur. Je n’ai pas testé la fonction sur un environnement réel.
Périmètre : la documentation décrit un environnement Dynatrace SaaS avec un abonnement DPS. Je n’ai trouvé aucune page équivalente pour Dynatrace Managed : je ne la décris donc pas pour Managed.
Le problème : un log de plus, c’est un déploiement de plus
Quand l’information manque, le réflexe est d’ajouter un log. Il faut alors modifier le code, passer la CI, déployer, attendre que le bug se reproduise, puis recommencer si le log ne suffit pas. Chaque tour allonge le MTTR et expose la production à un nouveau changement.
Un point d’arrêt non bloquant inverse l’ordre. Vous choisissez une ligne, l’agent collecte l’état de l’application chaque fois que cette ligne s’exécute, et le processus continue de servir le trafic. Vous obtenez un instantané, appelé snapshot, qui contient la pile d’appels, les variables locales et des informations de processus et de traçage.
Ce que la documentation garantit, et ce qu’elle ne dit pas
La page officielle fixe des prérequis précis :
- un environnement Dynatrace SaaS avec une souscription DPS incluant la capacité Code Monitoring ;
- OneAgent en version 1.309 ou supérieure, avec les fonctions « Java Live-Debugger » et/ou « Node.js Live-Debugger » activées ;
- les modes Full-Stack, Infrastructure ou Discovery (avec injection du module de code dans le conteneur) ;
- les modules de code Java et Node.js, seuls cités.
La facturation passe par Code Monitoring, mesurée en heures-conteneur, y compris pour des charges hors conteneur. Les tarifs ne figurent pas sur la page : je n’en cite aucun. L’annonce de l’éditeur évoque aussi la collecte dans des bibliothèques tierces et un accès depuis VS Code ou IntelliJ. Je n’ai pas pu confirmer ces points sur les pages de documentation lues, donc je ne les tiens pas pour acquis.
Live Debugger : activer sans tout ouvrir d’un coup
L’activation se fait en trois couches, de la plus large à la plus fine.
- Dans Settings, sous Collect and capture, General monitoring settings, OneAgent features, activez Java Live-Debugger, Node.js Live-Debugger ou les deux, puis redémarrez les processus concernés.
- Activez Observability for Developers. La portée va de l’environnement entier jusqu’à un groupe de processus, un cluster Kubernetes, un namespace, un groupe d’hôtes ou un déploiement.
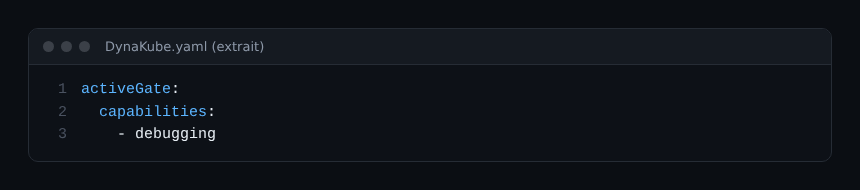
- Option recommandée : activez le module de débogage d’un ActiveGate (version 1.311 ou supérieure). Il n’est pas obligatoire, mais il centralise le trafic, surtout sous Kubernetes.
Avec l’opérateur Kubernetes, l’ActiveGate reçoit la capacité de débogage dans le DynaKube :
Mon conseil d’exploitation : commencez par un namespace de préproduction ou un seul groupe de processus, jamais par « Enable for entire tenant ». Élargir ensuite coûte un clic, réduire après un incident de confiance coûte beaucoup plus.
Poser un point d’arrêt qui ne fait pas de dégâts
Dans l’application Live Debugger, vous filtrez les instances à cibler, chargez le code source (local ou depuis un fournisseur Git), puis cliquez dans la marge devant le numéro de ligne. Trois réglages décident de l’impact en production.
Les limites par défaut
Chaque point d’arrêt a une limite de temps (7 jours par défaut), une limite de captures (100 par défaut) et un niveau de collecte (Medium par défaut). Une fois la limite atteinte, il passe à l’état Disabled. Vous le réactivez par un clic droit, Enable, ce qui remet le compteur à zéro.
Le niveau de collecte
Trois niveaux fixent la profondeur d’objet, la largeur de chaîne et le nombre d’éléments collectés par liste. Sur JVM, Low va à la profondeur 2 (128 caractères, 10 éléments), Medium à 5 (512, 15) et High à 8 (4 096, 25). Sur Node.js, les valeurs sont 2/128/5, 3/512/10 et 5/4 096/20. Commencez par Low : un snapshot léger répond souvent à la question.
Les conditions
Une condition limite la collecte aux cas qui vous intéressent, par exemple un seul client ou un montant anormal. La documentation donne ces exemples d’expressions avancées :
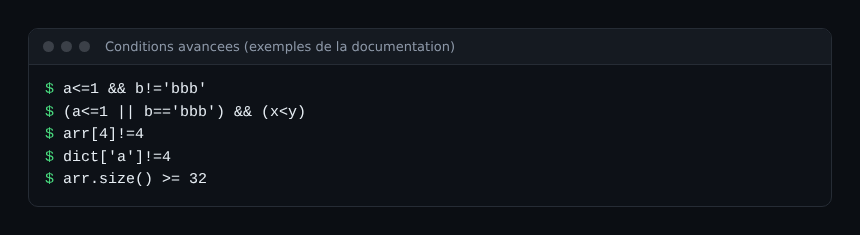
Les opérateurs documentés sont ==, !=, >, >=, <, <=, in, &&, || et les parenthèses. Pour la taille d’une liste, utilisez size(), pas len ni length.
Comprendre pourquoi aucun snapshot n’arrive
Un point d’arrêt a cinq états : Active, Pending, Disabled, Error, Warning. Les cas fréquents de la documentation :
- Active sans snapshot : la ligne n’est pas exécutée dans la bonne instance, ou la fonction tournait déjà quand vous avez posé le point. Seuls les appels postérieurs sont couverts.
- Pending : OneAgent absent, application hors filtre, fichier source non chargé ou ligne sans code exécutable. Côté JVM, des classes compilées sans informations de débogage bloquent aussi.
- Error : le fichier source vu dans l’IDE diffère de celui déployé, ou la collecte a pris trop de temps. Dynatrace vérifie la version du fichier avant de poser le point.
- Warning : un mécanisme de limitation de débit échantillonne la collecte sur un chemin très chaud, pour protéger les performances.
Sous Node.js, du code transpilé sans source maps ou un débogueur concurrent comme celui de WebStorm posent aussi problème. Le message de statut, via clic droit puis Status, donne la cause exacte.
Qui peut poser un point d’arrêt : les permissions
La vraie réponse à la décision de départ tient dans les politiques IAM. Deux permissions existent : dev-obs:breakpoints:set pour voir les agents et poser des points, dev-obs:breakpoints:manage pour voir et désactiver ceux de tous les utilisateurs. Des conditions permettent de restreindre par namespace, cluster, groupe de processus ou hôte. La lecture des snapshots passe par une permission de stockage distincte.
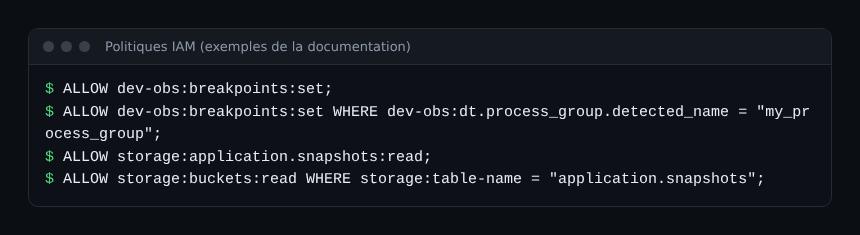
Séparer « poser » et « lire » est utile : un snapshot peut contenir des variables sensibles. L’annonce de l’éditeur mentionne des contrôles de masquage et de rétention des données. Vérifiez leur configuration réelle dans la documentation avant toute ouverture en production.
Bonnes pratiques
- Réservez
breakpoints:setà une équipe nommée et limitez-la à un namespace ou un groupe de processus. - Gardez les limites par défaut ou réduisez-les : 100 captures suffisent presque toujours.
- Posez une condition dès que le trafic est élevé, plutôt que de compter sur le rate limiting.
- Notez dans le ticket d’incident quel point d’arrêt a été posé, par qui et pourquoi.
- Associez le snapshot à une trace : il répond à « quelle valeur », la trace à « quel service ». Pour la consommation CPU, voyez plutôt le profilage continu, un outil tiers distinct.
Pour relier ce travail à la santé du service, regardez d’abord l’état des pods dans le diagnostic CrashLoopBackOff et OOMKilled, puis suivez l’effet de votre correctif dans un dashboard DQL.
Questions fréquentes
Le Live Debugger arrête-t-il l’application ?
Non. La documentation parle de points d’arrêt non bloquants : l’état est collecté sans arrêter le code en cours. Un mécanisme de limitation de débit protège les chemins très sollicités.
Quels langages sont pris en charge ?
La page de prérequis cite les modules de code Java et Node.js. Pour tout autre langage, rien n’est documenté sur cette page : vérifiez avant de planifier un déploiement.
Fonctionne-t-il sur Dynatrace Managed ?
La documentation lue décrit un environnement SaaS avec DPS. Je n’ai trouvé aucune page Managed : considérez la fonction comme non disponible sur Managed tant que l’éditeur ne le documente pas.
Conclusion
Le Live Debugger remplace le cycle « ajouter un log, déployer, attendre » par une lecture ciblée et bornée dans le temps. Son intérêt en production dépend des garde-fous : portée d’activation étroite, permissions IAM, limites et conditions. Pour aller plus loin, lisez la documentation du Live Debugger.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Les marques citées appartiennent à leurs propriétaires. Les fonctions évoluent vite : vérifiez les prérequis et les limites dans la documentation officielle.