
Un mardi, l’équipe paiement ajoute un pipeline de logs et oublie l’étiquette de centre de coût. Trois semaines plus tard, la finance découvre un volume sans propriétaire. Les groupes de pipelines OpenPipeline existent pour ce cas précis : décider ce qui doit s’exécuter pour tout le monde et ce que chaque équipe reste libre de régler.
Cet article part d’une décision d’exploitation, pas d’un tour de l’interface. Les faits viennent de la documentation officielle OpenPipeline et du billet de l’éditeur, lus le 12 novembre 2026. Je n’ai pas testé la fonction sur un tenant : ce qui n’est pas vérifié est signalé. Le sujet vaut pour Dynatrace SaaS ; le billet ne parle pas de Managed et je n’affirme rien pour lui.
Pour créer un pipeline et le router, voir notre tutoriel sur le pipeline de logs et sa route. Ici, on regarde ce qui se passe quand vingt équipes en font autant.
Le problème : une règle copiée vingt fois dérive
Deux réflexes courants échouent à l’échelle. Le premier verrouille tout : l’équipe plateforme valide chaque changement, et un simple filtre devient un ticket. Le second copie les règles : chaque équipe recopie le bloc « étiquette de coût + contexte de sécurité », puis les copies divergent.
Dans les deux cas, le coût se mesure en fiabilité et en argent : une étape de sécurité sautée, une facture imprévue, un délai d’observabilité pour un nouveau service. La vraie question est : quelles étapes doivent être imposées par la plateforme, et lesquelles laissées aux équipes ?
Groupes de pipelines OpenPipeline : le principe
Un groupe de pipelines regroupe des pipelines et fixe leur ordre d’exécution. Les règles de base, d’après la documentation :
- un pipeline appartient à un seul groupe à la fois ;
- les groupes ne s’imbriquent pas ;
- un pipeline de base reste inactif tant qu’il n’est pas dans un groupe.
Le groupe contient une « composition » : une liste ordonnée de pipelines de base et d’un seul emplacement réservé aux pipelines membres. Ce qui est placé avant l’emplacement s’exécute d’abord, les pipelines des équipes s’exécutent à l’emplacement, ce qui est placé après s’exécute en dernier.
Deux rôles en découlent. Le pipeline de base (basePipeline) porte la configuration commune. Le pipeline membre (memberPipeline) porte la logique d’une équipe. L’interface affiche un badge « Member pipeline » sur les membres.
Imposer et restreindre : deux leviers distincts
La documentation distingue deux mécanismes, et c’est la partie à bien comprendre avant de concevoir quoi que ce soit.
- Imposer (mandate) : les étapes des pipelines de base de la composition s’exécutent toujours, dans l’ordre défini par rapport aux étapes des membres. Exemple de la documentation : une étape de permission avant la logique d’un département.
- Restreindre (restrict) : les étapes exclues deviennent indisponibles pour les membres. Une équipe peut ajouter des étapes facultatives après les étapes imposées, pas redéfinir celles qui sont restreintes.
Un piège : si un pipeline de base et un pipeline membre activent la même étape, les deux s’exécutent. Pour bloquer une étape côté membres, il faut l’exclure via memberStages.
Étapes : concevoir un groupe pour vos logs
Voici une démarche de conception, à adapter. Je pars d’un cas fictif : deux unités métier, une équipe plateforme.
- Listez ce qui ne doit jamais varier. Par exemple : unité métier, centre de coût, contexte de sécurité, bucket de stockage selon la rétention. Cela devient vos pipelines de base.
- Placez-les autour de l’emplacement. Ce qui doit être posé avant que les équipes ne touchent aux données va avant l’emplacement ; l’affectation du stockage peut aller après.
- Fixez les étapes ouvertes aux membres avec
memberStages:includeAllouinclude. - Rattachez les pipelines des équipes dans
memberPipelines. - Appliquez la configuration par l’API Settings : la vue JSON de l’interface est en lecture seule.
Le schéma suit le motif builtin:openpipeline.<portée>.pipeline-groups, avec une portée par type de données (logs, spans, metrics, events, bizevents, etc.). Chaque type a donc ses propres groupes.
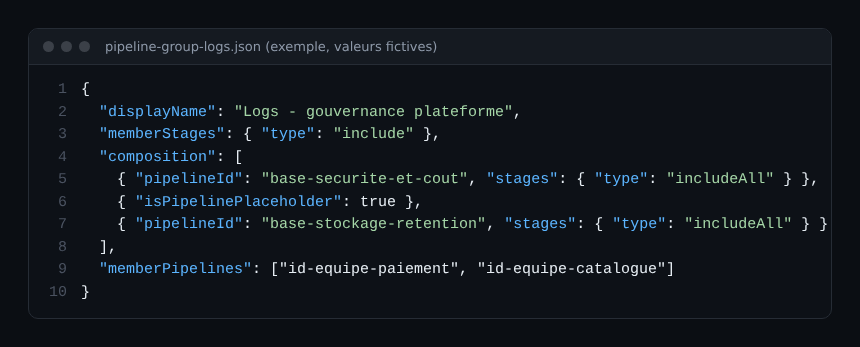
Les noms de champs viennent de la documentation. Les identifiants et valeurs sont fictifs. Je n’ai pas vérifié la valeur exacte attendue pour stages.type dans la composition : contrôlez-la dans le schéma de votre tenant avant d’appliquer.
Routage : ce qui change pour les membres
Dans un groupe, un pipeline membre reçoit les données de la première route qui correspond. Les pipelines de base d’un groupe ne sont en général pas routables ; les pipelines prêts à l’emploi d’extension, hors groupe, font exception. Concrètement, vos routes pointent vers les pipelines des équipes, et la plateforme n’a pas à les surveiller une par une : le socle s’applique tout seul.
Si vous connaissez le masquage, un pipeline de base est le bon endroit pour une règle de ce type, car aucune équipe ne peut la contourner. Voir le masquage des données sensibles avec OpenPipeline.
Comment vérifier que ça fonctionne
Après application, contrôlez dans un Notebook que chaque enregistrement porte les champs imposés. Si un champ manque, l’étape de base ne s’est pas exécutée.
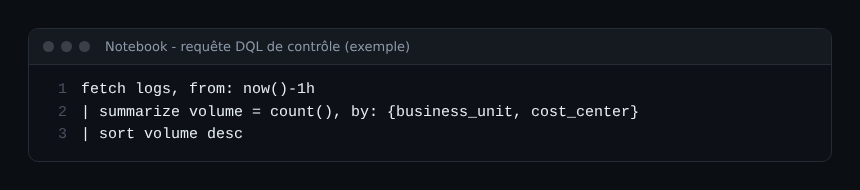
Les champs business_unit et cost_center sont ceux que mon groupe fictif ajoute ; remplacez-les par les vôtres. Une ligne avec des valeurs vides est le signal à chercher : un chemin d’ingestion qui contourne le groupe. Pour surveiller aussi les silences d’ingestion, voir la détection des trous de couverture.
Bonnes pratiques
- Réservez la propriété du groupe aux administrateurs plateforme ou SRE ; laissez les pipelines membres aux équipes applicatives.
- Gardez les pipelines de base courts : sécurité, coût, stockage, rien d’autre.
- Testez un changement de groupe sur un type de données à faible volume avant d’étendre.
- Documentez qui possède quel pipeline membre, car le groupe ne le fait pas pour vous.
Questions fréquentes
Un pipeline peut-il appartenir à deux groupes ?
Non. La documentation indique qu’un pipeline appartient à un seul groupe à la fois, et que les groupes ne s’imbriquent pas.
Une équipe peut-elle contourner une étape imposée ?
Pas une étape d’un pipeline de base de la composition : elle s’exécute toujours. Une étape exclue via memberStages est indisponible pour les membres. Attention aux étapes activées des deux côtés : elles s’exécutent toutes les deux.
La fonction existe-t-elle sur Dynatrace Managed ?
Le billet de l’éditeur indique une disponibilité générale en version SaaS 1.332 et ne mentionne pas Managed. Je ne l’ai pas vérifié pour Managed : consultez la documentation Managed avant de planifier.
Conclusion
Les groupes de pipelines OpenPipeline séparent « ce qui doit toujours arriver » de « ce que chaque équipe décide », et font respecter cette frontière par la plateforme. Commencez par un seul type de données et trois règles de base. Source principale : documentation des groupes de pipelines.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Les marques citées appartiennent à leurs propriétaires. Les fonctions évoluent vite : vérifiez les options dans la documentation officielle.