
Vous ouvrez un nœud Linux récent pour chercher une erreur, et il n’y a plus de fichier à lire : tout passe par systemd. Les logs journald restent sur la machine, dans un format binaire, et disparaissent avec elle si personne ne les centralise. Cet article part de cette décision d’exploitation : qui collecte le journal, avec quelle règle, et comment s’assurer que les lignes arrivent vraiment dans Dynatrace.
Le cadre est Dynatrace SaaS avec OneAgent. J’ai lu la documentation SaaS actuelle de la collecte Journald et la page des feature flags du module de logs, mises à jour en 2026. Je n’ai pas installé la chaîne complète pour cet article : les captures reproduisent des extraits de la documentation, et ce que je n’ai pas pu vérifier est dit dans le texte.
Pour la vue d’ensemble de l’ingestion, voyez d’abord l’ingestion de logs : résilience et self-service. Ici, on traite un seul cas, le journal systemd.
Le problème : un journal local ne se centralise pas tout seul
journald stocke ses entrées dans des fichiers binaires compressés, sous /var/log/journal/ quand le stockage est persistant. Il gère lui-même la taille, la rotation et la rétention. C’est pratique en local, avec journalctl. En revanche, rien ne les envoie ailleurs sans composant supplémentaire.
Pour l’astreinte, la conséquence est directe. Un nœud qui plante ou qu’on remplace emporte ses logs système. Un incident qui touche dix machines oblige à ouvrir dix sessions SSH. Le temps de diagnostic (MTTR) dépend alors du nombre de machines, pas de la gravité du problème.
Logs journald : trois façons de les sortir du nœud
Avant de configurer quoi que ce soit, tranchez entre trois approches :
- Un agent tiers ou un transfert syslog. Vous gardez vos outils, mais vous maintenez le parsing de la gravité et des unités. Dynatrace documente aussi une ingestion syslog, à traiter comme un autre chantier.
- Le module de logs d’OneAgent. Il lit le journal par l’API de systemd, sans suivre de fichiers à la main. C’est l’option de cet article.
- L’API d’ingestion. Utile pour des sources qu’aucun agent ne couvre. Elle exige que vous écriviez l’envoi vous-même.
Si OneAgent tourne déjà sur vos hôtes, la deuxième option évite un composant de plus. Le billet de l’éditeur (How to observe logs with Journald and Dynatrace, avril 2025, mis à jour en juin 2026) la présente comme valable pour Dynatrace SaaS et pour Dynatrace Managed. Je n’ai pas trouvé de page Managed équivalente dans la documentation : sur Managed, vérifiez la procédure avant de l’appliquer.
Comment OneAgent lit le journal
D’après la documentation, le module de logs ouvre la bibliothèque libsystemd.so et se comporte comme un client de journald. Il lit les entrées une à une et mémorise sa position. Aucun chemin n’est codé en dur : le module ouvre l’emplacement par défaut du contexte journald.
Chaque entrée est convertie en attributs :
- le champ
MESSAGEdevient le contenu du log ; - le champ
UNIT(à défautSYSTEMD_UNIT) alimente l’attributJournald.unit, et la documentation précise qu’aucun des deux champs n’est parfois présent ; - le champ
PRIORITYdonne la gravité,LogEntryLevel.
Cette dernière correspondance vaut qu’on s’y arrête, car elle conditionne vos alertes.
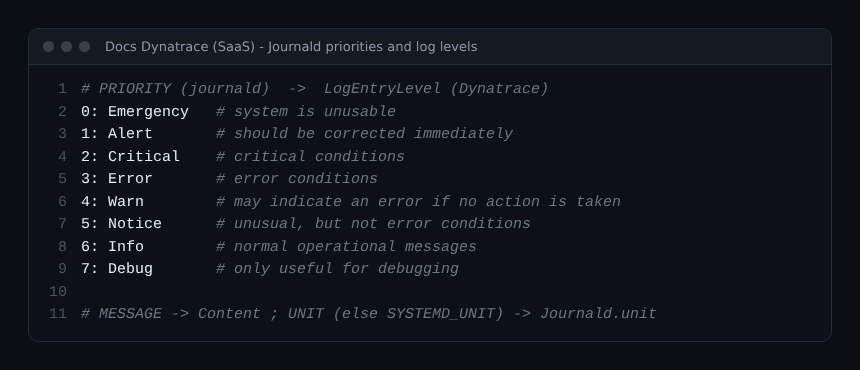
Une alerte sur les erreurs doit couvrir les priorités 0 à 3, pas seulement la 3. Si vous voulez filtrer le bruit, lisez comment réduire le bruit des alertes sur les logs.
Étapes : activer la collecte des logs journald
Prérequis : un OneAgent d’une version 1.307 ou supérieure sur un hôte Linux avec systemd, et le droit de modifier les réglages du tenant. La documentation exige deux réglages distincts, et c’est là que l’on se trompe.
- Activez le détecteur. Dans les feature flags du module de logs, cochez « Enable Journald log detector ». Il est actif par défaut pour les nouveaux tenants. Les tenants existants doivent l’activer eux-mêmes. Sans lui, la documentation prévient que les logs n’apparaissent pas, même avec des règles d’ingestion.
- Activez une règle d’ingestion. La règle intégrée « [Built-in] Ingest Journald logs » ingère tous les logs journald. Pour un nouveau compte, elle est déjà active.
- Ou ciblez une unité. Créez une règle avec deux matchers : l’attribut « Journald Unit » avec une valeur comme
kubelet.service, puis l’attribut « Log source » avec la valeur « Journald ».
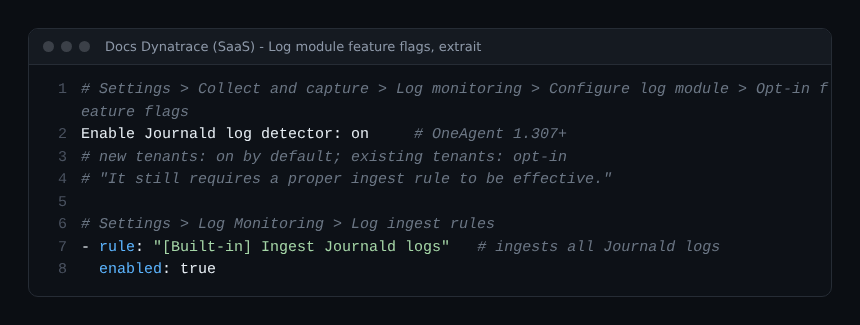
Un détail de navigation : la page des feature flags place ce réglage sous « Collect and capture > Log monitoring », alors que la page Journald écrit encore « Settings > Log Monitoring ». Les deux pages datent d’époques différentes de la documentation. Suivez le menu que vous voyez dans votre tenant.
Cibler une unité plutôt que tout ingérer
La règle intégrée est simple, mais elle ingère tout le journal. Sur un nœud Kubernetes ou un serveur chargé, cela inclut des unités très bavardes. Le volume se paie en ingestion, comme le détaille le coût des logs : ingestion, rétention et requête.
Voici un choix raisonnable en trois temps :
- Commencez avec la règle intégrée sur un seul hôte de test, pour voir ce qui arrive.
- Listez les unités utiles à l’astreinte : par exemple
kubelet.service,sshd.serviceou l’unité de votre application. - Remplacez la règle globale par une règle par unité, sur le modèle ci-dessous.
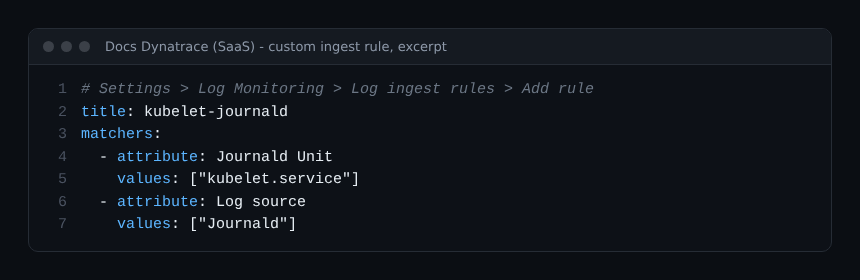
Le nom de règle kubelet-journald est un exemple de ma part, pas une valeur imposée. Je n’ai pas mesuré la réduction de volume qu’apporte ce ciblage sur un parc réel : mesurez-la sur le vôtre avant de la promettre.
Comment vérifier que ça fonctionne
Sur l’hôte, produisez une ligne dont vous connaissez le texte, par exemple avec logger -p user.err "test journald dynatrace". Elle entre dans le journal avec la priorité 3. Puis cherchez-la dans Dynatrace, dans l’application Logs ou par une requête DQL :
fetch logs, from:now() - 15m
| filter contains(content, "test journald dynatrace")
| limit 20
Si la ligne n’apparaît pas, vérifiez dans cet ordre : la version d’OneAgent, le détecteur Journald, la règle d’ingestion, puis la présence d’une unité ou d’un identifiant dans l’entrée. Je n’ai pas vérifié ici le nom exact de l’attribut qui porte la source dans Grail : n’écrivez pas de filtre dessus sans l’avoir lu dans un enregistrement réel. Pour aller plus loin avec DQL, voyez les requêtes DQL sur les erreurs de logs.
Une fois les logs dans Grail, ils peuvent être traités par OpenPipeline avant stockage. C’est le bon endroit pour masquer ou router : voir créer un pipeline OpenPipeline pour router les logs.
Bonnes pratiques
- Activez le détecteur et la règle ensemble, et notez les deux dans votre runbook.
- Préférez une règle par unité dès que le test initial est concluant.
- Alertez sur la gravité, pas sur un mot-clé fragile.
- Gardez
journalctlpour le dépannage local : il reste utile quand l’agent est arrêté. - Contrôlez après chaque montée de version d’OneAgent que les logs arrivent encore.
Questions fréquentes
Faut-il configurer quelque chose sur systemd ?
La documentation que j’ai lue ne demande aucune configuration côté journald : OneAgent lit le journal via la bibliothèque système. Vérifiez seulement que l’hôte utilise systemd.
Pourquoi mes logs journald n’arrivent-ils pas ?
La cause la plus probable est un tenant ancien dont le détecteur Journald n’a pas été activé. Sans lui, même une règle d’ingestion correcte reste sans effet, selon la documentation.
Cette méthode vaut-elle pour Dynatrace Managed ?
Le billet de l’éditeur l’affirme. Je n’ai toutefois pas trouvé de page Managed dédiée : confirmez la procédure dans la documentation de votre version avant de l’utiliser.
Conclusion
Centraliser les logs journald se résume à deux actions et une vérification : activer le détecteur, activer une règle, puis retrouver une ligne de test. Ciblez ensuite les unités qui comptent pour garder le volume sous contrôle. Source principale : la page Log Monitoring from Journald de la documentation Dynatrace.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Les marques citées appartiennent à leurs propriétaires. Les produits évoluent vite : vérifiez les réglages et les versions dans la documentation officielle.