Parcours : Métriques Dynatrace SaaS · Module 5/7 — métriques Kubernetes Grail, processus, runtimes et conteneurs · Format : fiches de référence · Plateforme : Dynatrace SaaS (Grail, DQL)
Dans ce module :
- Un tableau récapitulatif de 21 métriques
dt.process.*,dt.runtime.*,dt.containers.*etdt.kubernetes.*. - Une fiche par métrique : ce qu’elle mesure, quand s’en servir, le piège à éviter et une requête
timeseries. - Une méthode pour vérifier qu’une clé existe bien dans votre environnement avant de construire un tableau de bord.
Ce cinquième module du parcours métriques Dynatrace SaaS rassemble les métriques Kubernetes Grail et celles des couches qui tournent dessous : processus, machines virtuelles Java et conteneurs. Ce sont les métriques que l’on ouvre quand un pod redémarre, quand un service ralentit sans raison visible côté requêtes, ou quand un nœud sature. Chaque fiche donne la clé exacte, son unité, ses dimensions principales et une requête DQL prête à adapter.
Tout ce module concerne Dynatrace SaaS avec Grail et DQL. En Dynatrace Managed, les mêmes signaux existent sous forme de clés classiques builtin:tech.*, builtin:containers.* et builtin:kubernetes.*, interrogées avec le metric selector : elles sont traitées dans le module métriques processus builtin du parcours Managed.
Les fiches vont droit à la clé. Pour combiner ces métriques en ratios (requêtes contre consommation, saturation, quotas) et en alertes, le module 7 sur DQL timeseries donne les paramètres utiles.
Les métriques Kubernetes Grail et leurs voisines en un tableau
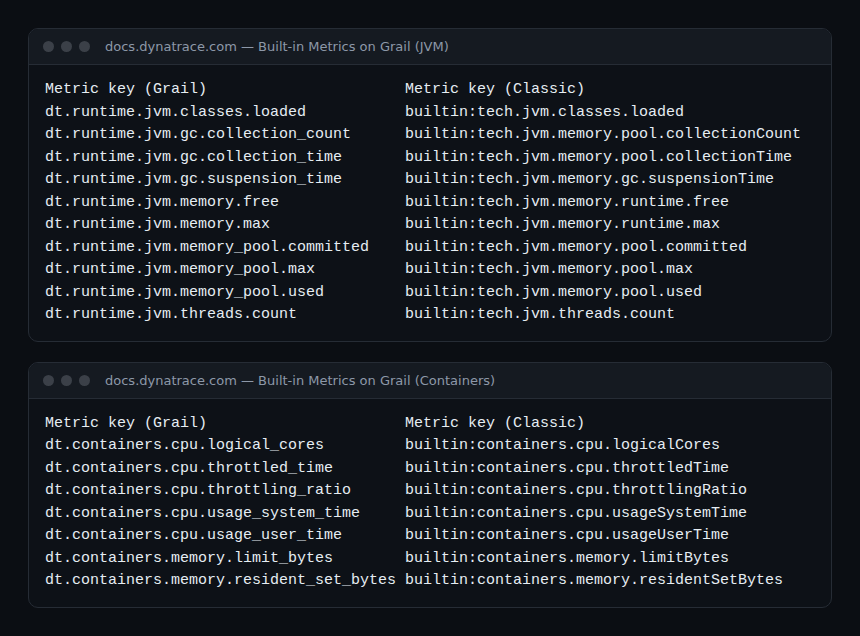
Les clés ci-dessous figurent toutes dans la page Built-in Metrics on Grail. Les unités sont celles de l’équivalent classique documenté dans la référence des métriques intégrées. Les dimensions indiquées sont celles qu’on utilise le plus souvent pour regrouper ; ouvrez le navigateur de métriques pour voir la liste complète.
| Clé Grail | Unité | Dimensions principales | Ce qu’elle mesure |
|---|---|---|---|
dt.process.cpu.usage |
% | dt.entity.process_group_instance | CPU consommé par un processus |
dt.process.memory.working_set_size |
octets | dt.entity.process_group_instance | Mémoire de travail du processus |
dt.process.handles.file_descriptors_percent_used |
% | dt.entity.process_group_instance | Part des descripteurs de fichiers utilisés |
dt.process.network.sessions.reset |
par seconde | dt.entity.process_group_instance | Sessions TCP entrantes terminées par un reset |
dt.runtime.jvm.memory_pool.used |
octets | dt.entity.process_group_instance | Mémoire utilisée par pool de la JVM |
dt.runtime.jvm.gc.suspension_time |
% | dt.entity.process_group_instance | Temps de pause dû au ramasse-miettes |
dt.runtime.jvm.gc.collection_count |
nombre | dt.entity.process_group_instance | Collectes du ramasse-miettes |
dt.runtime.jvm.threads.count |
nombre | dt.entity.process_group_instance | Threads de la JVM |
dt.containers.cpu.throttled_time |
ns/min | dt.entity.container_group_instance | Temps de bridage CPU d’un conteneur |
dt.containers.memory.resident_set_bytes |
octets | dt.entity.container_group_instance | Mémoire résidente du conteneur |
dt.containers.memory.limit_bytes |
octets | dt.entity.container_group_instance | Limite mémoire du conteneur |
dt.kubernetes.container.cpu_usage |
millicores | k8s.cluster.name, k8s.namespace.name, k8s.workload.name | CPU consommé par les conteneurs |
dt.kubernetes.container.requests_cpu |
millicores | k8s.cluster.name, k8s.namespace.name, k8s.workload.name | CPU demandé (requests) |
dt.kubernetes.container.memory_working_set |
octets | k8s.cluster.name, k8s.namespace.name, k8s.workload.name | Mémoire de travail des conteneurs |
dt.kubernetes.container.limits_memory |
octets | k8s.cluster.name, k8s.namespace.name, k8s.workload.name | Limite mémoire déclarée |
dt.kubernetes.container.restarts |
nombre | k8s.cluster.name, k8s.namespace.name, k8s.workload.name | Redémarrages de conteneurs |
dt.kubernetes.container.oom_kills |
nombre | k8s.cluster.name, k8s.namespace.name, k8s.workload.name | Arrêts pour manque de mémoire (OOMKilled) |
dt.kubernetes.workload.pods_desired |
nombre | k8s.cluster.name, k8s.namespace.name, k8s.workload.name | Pods souhaités par le workload |
dt.kubernetes.pods |
nombre | k8s.cluster.name, k8s.namespace.name, k8s.workload.name | Pods existants |
dt.kubernetes.node.cpu_allocatable |
millicores | k8s.cluster.name | CPU allouable des nœuds |
dt.kubernetes.persistentvolumeclaim.used |
octets | k8s.cluster.name, k8s.namespace.name | Espace utilisé d’un volume persistant |
Processus : dt.process.*
Les métriques de processus sont collectées par OneAgent pour chaque instance de groupe de processus. Elles répondent à la question « quel processus consomme quoi sur cet hôte ? ».
dt.process.cpu.usage
Pourcentage du CPU de l’hôte consommé par le processus, tous ses workers additionnés. 100 % signifie que le processus occupe toutes les ressources CPU disponibles de l’hôte. Utile pour isoler le processus responsable quand dt.host.cpu.usage grimpe. Piège : sur un hôte de 16 cœurs, 10 % représente déjà plus d’un cœur et demi ; comparez toujours au nombre de cœurs avant de conclure.
timeseries cpu = avg(dt.process.cpu.usage), by: {dt.entity.process_group_instance}
| sort arrayAvg(cpu) desc
| limit 10
dt.process.memory.working_set_size
Mémoire de travail du processus, en octets. Une courbe qui monte en escalier sans jamais redescendre après les pics de charge est le signe classique d’une fuite mémoire. Pour une application Java, croisez-la avec les pools de la JVM : la mémoire du processus inclut aussi le code natif, les threads et les tampons hors tas.
timeseries ws = max(dt.process.memory.working_set_size), by: {dt.entity.process_group_instance}dt.process.handles.file_descriptors_percent_used
Part des descripteurs de fichiers ouverts par rapport au maximum autorisé pour le processus. Un serveur qui approche 100 % finit par refuser des connexions avec des erreurs « too many open files », souvent loin de la cause réelle. Une alerte précoce sur cette métrique évite un incident difficile à diagnostiquer. Le seuil reste à fixer selon votre application.
timeseries fd = max(dt.process.handles.file_descriptors_percent_used), by: {dt.entity.process_group_instance}
| filter arrayMax(fd) > 80
dt.process.network.sessions.reset
Nombre de sessions TCP entrantes terminées par une erreur de reset, par seconde. Une hausse soudaine accompagne souvent un pool de connexions mal dimensionné, un pare-feu qui coupe des sessions inactives ou un service distant qui redémarre. Regardez cette métrique quand le taux d’erreur d’un service augmente sans exception visible dans les traces.
timeseries resets = avg(dt.process.network.sessions.reset), by: {dt.entity.process_group_instance}Runtimes : dt.runtime.jvm.*
Les métriques de runtime remplacent sur Grail les clés classiques builtin:tech.jvm.*. D’autres runtimes (Go, Node.js, .NET, PHP) ont leurs propres familles dt.runtime.* ; ce module se concentre sur la JVM, la plus répandue en production.
dt.runtime.jvm.memory_pool.used
Mémoire utilisée par chaque pool de la JVM (eden, survivor, old gen, metaspace selon le ramasse-miettes). Comparez-la à dt.runtime.jvm.memory_pool.max : un pool old gen qui reste haut après chaque collecte annonce une OutOfMemoryError. Piège : additionner tous les pools n’a pas de sens métier, regardez-les séparément.
timeseries used = avg(dt.runtime.jvm.memory_pool.used), by: {dt.entity.process_group_instance}dt.runtime.jvm.gc.suspension_time
Temps pendant lequel la JVM est suspendue par le ramasse-miettes, exprimé en pourcentage. Pendant ces pauses, aucune requête n’avance : c’est une cause fréquente de latence au 99e centile que les traces montrent sans l’expliquer. Une valeur durablement élevée appelle un réglage du tas ou du ramasse-miettes, pas un ajout de pods.
timeseries gc = avg(dt.runtime.jvm.gc.suspension_time), by: {dt.entity.process_group_instance}dt.runtime.jvm.gc.collection_count
Nombre de collectes effectuées par le ramasse-miettes. Seule, elle dit peu ; rapportée à la charge, elle révèle une application qui alloue trop d’objets éphémères. Une hausse brutale après un déploiement pointe souvent une régression de code.
timeseries gcs = sum(dt.runtime.jvm.gc.collection_count), by: {dt.entity.process_group_instance}dt.runtime.jvm.threads.count
Nombre de threads de la JVM. Une croissance continue trahit des threads qui ne se terminent pas (pool non borné, appels bloqués). Combinée à une latence qui monte, elle oriente vers un épuisement de pool.
timeseries threads = max(dt.runtime.jvm.threads.count), by: {dt.entity.process_group_instance}Conteneurs vus par OneAgent : dt.containers.*
Ces métriques viennent de OneAgent sur l’hôte et décrivent chaque instance de groupe de conteneurs. La documentation précise que les anciennes métriques classiques de conteneur ont été abandonnées au profit de ces clés.
dt.containers.cpu.throttled_time
Temps pendant lequel le conteneur a été bridé par sa limite CPU, en nanosecondes par minute. Un conteneur bridé ralentit alors que l’hôte a encore du CPU libre : c’est le piège classique des limites CPU trop basses. La page de migration Kubernetes de la documentation montre comment convertir cette valeur en millicores.
timeseries throttled = avg(dt.containers.cpu.throttled_time), by: {dt.entity.container_group_instance}dt.containers.memory.resident_set_bytes
Mémoire résidente du conteneur, en octets. C’est la mesure à rapprocher de la limite pour estimer le risque d’arrêt pour manque de mémoire. Piège : le cache de pages n’est pas compté ici ; il a sa propre clé, dt.containers.memory.cache_bytes.
timeseries rss = avg(dt.containers.memory.resident_set_bytes), by: {dt.entity.container_group_instance}dt.containers.memory.limit_bytes
Limite mémoire du conteneur, en octets. Sans limite, la valeur est vide. La documentation calcule un pourcentage d’utilisation en divisant la mémoire résidente par cette limite, ou par la mémoire physique totale quand aucune limite n’existe.
timeseries {
    rss = avg(dt.containers.memory.resident_set_bytes),
    lim = avg(dt.containers.memory.limit_bytes)
  }, by: {dt.entity.container_group_instance}
| fieldsAdd pct = 100 * rss[] / lim[]
Kubernetes : dt.kubernetes.*
Ces métriques arrivent avec la nouvelle expérience Kubernetes, via ActiveGate 1.279 ou ultérieur. Les anciennes métriques Kubernetes ne sont pas disponibles sur Grail : partez directement de ces clés.
dt.kubernetes.container.cpu_usage
CPU consommé par les conteneurs (utilisateur et système), en millicores. Sa valeur la plus utile est relative : comparée aux requests, elle montre les workloads sous- ou surdimensionnés. Le niveau le plus fin est le conteneur ; regroupez par workload pour lire une application.
timeseries cpu = sum(dt.kubernetes.container.cpu_usage),
  by: {k8s.cluster.name, k8s.namespace.name, k8s.workload.name}
dt.kubernetes.container.requests_cpu
CPU demandé par les conteneurs (requests), en millicores. Le scheduler place les pods selon cette valeur, pas selon la consommation réelle. Un écart durable entre requests et usage gaspille de la capacité ou, à l’inverse, prépare une contention sur le nœud.
timeseries {
    usage = sum(dt.kubernetes.container.cpu_usage),
    req = sum(dt.kubernetes.container.requests_cpu)
  }, by: {k8s.namespace.name, k8s.workload.name}
| fieldsAdd ratio = 100 * usage[] / req[]
dt.kubernetes.container.memory_working_set
Mémoire de travail des conteneurs, en octets. C’est la valeur que surveille le kubelet pour décider d’une éviction et que le noyau compare à la limite. La documentation l’agrège au niveau workload en sommant par cluster, namespace et workload.
timeseries memory_working_set = sum(dt.kubernetes.container.memory_working_set),
  by: {k8s.cluster.name, k8s.namespace.name, k8s.workload.name}
dt.kubernetes.container.limits_memory
Limite mémoire déclarée pour les conteneurs, en octets. Rapportée à memory_working_set, elle donne la marge restante avant un OOMKill. Piège : un conteneur sans limite n’apparaît pas dans cette série, ce qui fausse un ratio calculé sur tout un namespace.
timeseries {
    ws = sum(dt.kubernetes.container.memory_working_set),
    lim = sum(dt.kubernetes.container.limits_memory)
  }, by: {k8s.namespace.name, k8s.workload.name}
| fieldsAdd marge = 100 * ws[] / lim[]
dt.kubernetes.container.restarts
Redémarrages de conteneurs, d’après le restartCount du statut du pod. La documentation des métriques classiques précise que la valeur n’est écrite que s’il y a eu au moins un redémarrage : une série vide signifie « aucun redémarrage », pas une panne de collecte. C’est le premier indicateur d’un CrashLoopBackOff.
timeseries restarts = sum(dt.kubernetes.container.restarts),
  by: {k8s.namespace.name, k8s.workload.name}
| filter arraySum(restarts) > 0
dt.kubernetes.container.oom_kills
Nombre d’arrêts de conteneurs avec le statut OOMKilled. Comme les redémarrages, la série n’existe que s’il y a eu au moins un événement. Un OOMKill récurrent sur un workload se corrige par la limite mémoire ou par le code, rarement par un ajout de réplicas. Le diagnostic complet est détaillé dans CrashLoopBackOff et OOMKilled : diagnostiquer les pods.
timeseries oom = sum(dt.kubernetes.container.oom_kills),
  by: {k8s.namespace.name, k8s.workload.name}
dt.kubernetes.workload.pods_desired
Nombre de pods souhaités par le workload (réplicas déclarés). Comparé à dt.kubernetes.pods, il révèle un déploiement bloqué : image introuvable, quota atteint, nœuds pleins.
timeseries {
    desired = max(dt.kubernetes.workload.pods_desired),
    actual = max(dt.kubernetes.pods)
  }, by: {k8s.namespace.name, k8s.workload.name}
dt.kubernetes.pods
Nombre de pods, regroupable par workload. Utile pour suivre un autoscaling horizontal ou repérer une disparition de pods après un incident de nœud. Piège : ce compte inclut tous les pods, quel que soit leur état ; ne le lisez pas comme un nombre de pods prêts.
timeseries pods = max(dt.kubernetes.pods), by: {k8s.namespace.name, k8s.workload.name}dt.kubernetes.node.cpu_allocatable
CPU allouable des nœuds, en millicores : la capacité réellement disponible pour les pods, après réservations du système. Comparé à la somme des requests, il indique combien de pods le cluster peut encore accueillir. La même logique vaut pour memory_allocatable et pods_allocatable.
timeseries alloc = sum(dt.kubernetes.node.cpu_allocatable), by: {k8s.cluster.name}dt.kubernetes.persistentvolumeclaim.used
Octets utilisés dans un volume persistant, mesurés au niveau du PersistentVolumeClaim. Rapporté à dt.kubernetes.persistentvolumeclaim.capacity, il anticipe un disque plein sur une base de données ou une file de messages, un incident long à résoudre une fois survenu.
timeseries {
    used = avg(dt.kubernetes.persistentvolumeclaim.used),
    cap = avg(dt.kubernetes.persistentvolumeclaim.capacity)
  }, by: {k8s.namespace.name}
| fieldsAdd pct = 100 * used[] / cap[]
Comment vérifier que ça fonctionne
- Ouvrez un notebook et lancez
timeseries sum(dt.kubernetes.pods), by: {k8s.cluster.name}: chaque cluster supervisé doit renvoyer une série. Aucun résultat signifie souvent que la nouvelle expérience Kubernetes n’est pas activée. - Pour les métriques de processus et de JVM, filtrez sur un hôte connu et vérifiez que
dt.process.cpu.usagerenvoie bien ses processus principaux. - Avant de construire une alerte, affichez la clé dans le navigateur de métriques : il donne la liste exacte des dimensions disponibles dans votre environnement.
- Pour les séries « écrites seulement s’il y a un événement » (redémarrages, OOMKills), testez la requête sur une période où un incident a eu lieu.
Les requêtes de ce module suivent la syntaxe détaillée dans DQL timeseries : le guide avancé. Pour transformer ces signaux en alertes, voyez les alertes Kubernetes sur nœuds, pods et quotas.
Questions fréquentes
Pourquoi ma requête sur une ancienne clé Kubernetes ne renvoie-t-elle rien ?
Les anciennes métriques Kubernetes ne sont pas disponibles sur Grail. Utilisez les clés dt.kubernetes.* : la documentation fournit une table de correspondance avec les clés builtin:kubernetes.*.
Faut-il utiliser dt.containers.* ou dt.kubernetes.container.* ?
Partez de dt.kubernetes.* pour raisonner en workloads et namespaces. Gardez dt.containers.* pour le détail système d’un conteneur, comme le temps de bridage CPU.
Ces métriques ont-elles un coût particulier ?
La documentation indique que les nouvelles métriques Kubernetes et conteneur relèvent d’un modèle de licence distinct des unités d’hôte full-stack. Vérifiez votre contrat avant de les activer sur tous les clusters.
Avec ces 21 fiches, vous couvrez la pile d’exécution, du processus au cluster. Le module suivant sort du cluster et passe aux services cloud et aux extensions.
← Module 4 : Métriques RUM Grail · Sommaire du parcours · Module 6 : Métriques cloud Grail →
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Ce module ne remplace pas la documentation officielle : vérifiez chaque clé, unité et dimension dans la documentation et le navigateur de métriques de votre environnement.