Parcours : Métriques Dynatrace SaaS · Module 7/7 — DQL timeseries, métriques personnalisées et alertes · Durée : ~75 min · Niveau : Intermédiaire à avancé
Objectifs :
- Maîtriser les paramètres de la commande DQL timeseries :
by,filter,interval,bins,rollup,default,nonempty,union,shift. - Calculer des ratios entre séries et tracer des logs ou des spans avec
makeTimeseries. - Créer des métriques personnalisées : API d’ingestion, OpenTelemetry ou extraction OpenPipeline.
- Poser une alerte sur une requête
timeseriesavec l’application Anomaly Detection.
Prérequis : modules 1 à 6 du parcours, les bases de DQL (fetch, filter, summarize) et, pour la partie ingestion, un token autorisé à ingérer des métriques.
Une requête de métrique fausse ne plante pas : elle renvoie un graphique plausible et un SLI erroné. Ce dernier module du parcours Métriques Dynatrace SaaS explore la commande DQL timeseries au-delà de l’agrégation simple, paramètre par paramètre, puis montre comment ajouter vos propres métriques dans Grail et déclencher une alerte quand elles dérivent.
Le contenu vaut pour Dynatrace SaaS : timeseries, makeTimeseries, OpenPipeline et Anomaly Detection sont propres à la plateforme Grail. En Dynatrace Managed, l’équivalent passe par le metric selector et la Metrics API v2 ; l’API d’ingestion et son protocole de ligne existent dans les deux. Pour les bases de DQL, revoyez les fondamentaux de DQL.
La syntaxe complète de DQL timeseries
La documentation donne la forme générale suivante :
timeseries [column =] aggregation(metricKey [, filter:] [, default:] [, rollup:] [, rate:] [, scalar:])
  [, by:] [, filter:] [, union:] [, nonempty:] [, interval: | bins:]
  [, from:] [, to:] [, timeframe:] [, shift:]
Les agrégations disponibles sont sum, avg, min, max, count (le nombre de séries, donc la cardinalité), percentile, percentRank et countDistinct. Le résultat contient toujours les colonnes timeframe et interval, puis un tableau de valeurs par agrégation et par combinaison de dimensions.
by et filter : découper et restreindre
by découpe le résultat par dimension ; filter restreint les séries avant l’agrégation. Filtrer dans la commande est plus efficace que filtrer après coup, car moins de séries sont chargées.
timeseries p90 = percentile(dt.service.request.response_time, 90),
  by: { dt.entity.service },
  filter: in(dt.entity.service, "SERVICE-1", "SERVICE-2"),
  interval: 5m, from: -24h
Seules dt.service.request.response_time et dt.service.request.service_mesh.response_time acceptent percentile sans rollup. Pour une jauge comme le CPU, écrivez percentile(dt.host.cpu.usage, 90, rollup: avg). Attention aussi à l’unité : le temps de réponse de service est exprimé en microsecondes.
interval et bins : la résolution n’est jamais exactement celle demandée
interval fixe la durée d’un point, bins le nombre de points ; les deux s’excluent. La plateforme arrondit à un intervalle connu (1, 2, 3, 5, 10, 15 ou 30 minutes ; 1, 2, 3, 4, 6, 8, 12 ou 24 heures ; puis multiples de 24 heures), limite chaque série à 1 500 éléments et aligne les créneaux sur minuit. Demander interval: 5h donne donc des créneaux de 6 h. Pour un SLI, lisez toujours la colonne interval du résultat.
rollup, default, nonempty et rate
rollup(min,max,sum,avg,total) sépare l’agrégation dans le temps de l’agrégation entre séries :avg(dt.requests.failed, rollup: sum)calcule la moyenne, entre séries, des sommes par créneau.defaultremplace les créneaux vides (null) par une valeur. Indispensable avant une division.nonempty: truerenvoie une série même sans donnée. Sans lui, un ratio d’erreurs sans aucune erreur renvoie « aucun enregistrement » au lieu de 0 %.ratenormalise par une durée :sum(dt.requests.failed, rate: 1s)donne un débit par seconde, indépendant de l’intervalle choisi.
union : l’intersection silencieuse
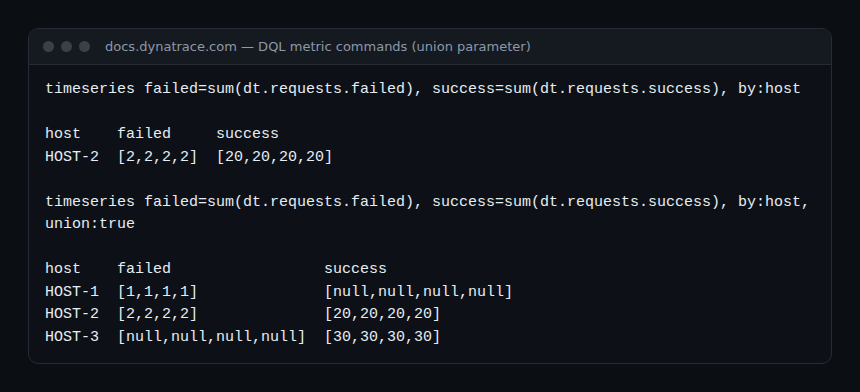
Quand une requête contient plusieurs agrégations, timeseries ne garde par défaut que les séries présentes dans toutes les colonnes, comme un INNER JOIN. Un hôte qui n’a aucune requête en échec disparaît donc du résultat. union: true conserve toutes les séries, avec des colonnes éventuellement vides.
Arithmétique entre séries et comparaison dans le temps
L’opérateur [] applique un calcul élément par élément sur des tableaux de même longueur. C’est la base des ratios d’erreurs :
timeseries {
  failed = sum(dt.service.request.failure_count, default: 0),
  total  = sum(dt.service.request.count)
}, by: { dt.entity.service }, nonempty: true, union: true
| fieldsAdd error_rate = failed[] / total[] * 100
Pour réduire un tableau à une valeur, utilisez arrayAvg, arrayMax ou arraySum, ou le paramètre scalar: true. Le paramètre shift décale la fenêtre interrogée et réaligne les horodatages ; combiné à append, il superpose aujourd’hui et la semaine dernière :
timeseries avail = avg(dt.host.disk.avail), by: { dt.entity.host }, from: -24h
| append [
    timeseries avail.7d = avg(dt.host.disk.avail), by: { dt.entity.host }, shift: -7d
  ]
makeTimeseries : des séries à partir de logs et de spans
timeseries lit des métriques. Pour tracer des enregistrements, utilisez makeTimeseries après un fetch. Le champ de temps par défaut est timestamp, puis start_time s’il n’existe pas, ce qui permet de l’appliquer directement aux spans :
fetch spans
| filter request.is_root_span == true
| filter endpoint.name == "GET /api/cart"
| makeTimeseries { p50 = median(duration), p90 = percentile(duration, 90) }
Pour les logs, fetch logs | filter loglevel == "ERROR" | makeTimeseries count(default: 0), interval: 30m, nonempty: true produit une courbe d’erreurs à zéro plutôt qu’un résultat vide. Gardez en tête le coût : makeTimeseries relit les enregistrements bruts à chaque exécution. Pour un indicateur affiché en permanence, une métrique créée à l’ingestion est préférable, ce qui mène à la suite.
Créer vos propres métriques
| Voie | Quand la choisir | Point d’attention |
|---|---|---|
| API d’ingestion (protocole de ligne) | Scripts, tâches planifiées, équipements sans SDK | Préfixe dt. réservé, charge utile limitée à 1 Mo |
| OpenTelemetry (OTLP) | Applications instrumentées avec un SDK ou un Collector | Dynatrace attend une temporalité delta |
| Extraction OpenPipeline | L’information existe déjà dans des logs, spans ou événements | La métrique n’existe qu’à partir des données ingérées après la règle |
Le protocole de ligne et l’API d’ingestion
Une ligne suit la forme metric.key,dimensions payload, avec un horodatage facultatif en millisecondes. La charge utile est une jauge (par défaut) ou un compteur :
cpu.temperature,hostname=hostA,cpu=1 55
new_user_count,region=EAST count,delta=50
mymetric,team=teamA,businessapp=hr 1000 1609459200000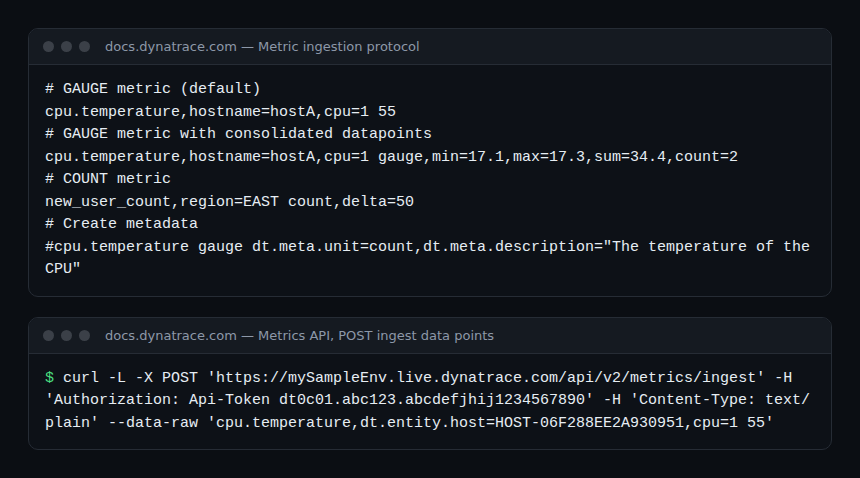
curl -L -X POST 'https://{your-environment-id}.live.dynatrace.com/api/v2/metrics/ingest' \
  -H 'Authorization: Api-Token <votre-token>' \
  -H 'Content-Type: text/plain' \
  --data-raw 'shop.orders.validated,channel=web count,delta=12'
Avec un token d’accès classique, le scope requis est metrics.ingest ; avec un token de plateforme ou un client OAuth, c’est openpipeline:metrics:ingest. Une réponse 400 signale des lignes invalides, les lignes valides étant tout de même traitées. Piège fréquent : pour un compteur, le modèle classique ajoute le suffixe .count, pas Grail. On interroge donc timeseries orders = sum(shop.orders.validated), by: { channel }.
OpenTelemetry et OpenPipeline
Un SDK ou un Collector OpenTelemetry exporte vers https://{your-environment-id}.live.dynatrace.com/api/v2/otlp/v1/metrics. Dynatrace attend des compteurs en delta (OTEL_EXPORTER_OTLP_METRICS_TEMPORALITY_PREFERENCE=delta côté SDK) ; le sujet est détaillé dans temporalité des métriques OTLP. Les attributs deviennent des dimensions : évitez les identifiants uniques.
Quand l’information est déjà dans des logs, OpenPipeline propose deux processeurs d’extraction : Counter metric compte les enregistrements qui satisfont une condition, Value metric prend la valeur numérique d’un champ, éventuellement extrait dans un champ temporaire dt.temp.* jamais stocké dans Grail. Les métriques histogrammes sont traitées dans métriques histogrammes avec OpenPipeline.
Alerter sur une requête DQL timeseries
Dans l’application Anomaly Detection, une alerte personnalisée part d’une requête timeseries et d’un analyseur. Le seuil statique compare chaque point à une valeur fixe ; la baseline saisonnière convient aux métriques qui suivent un rythme. Les paramètres d’un seuil statique, tels que la documentation les expose dans l’API Settings (schéma builtin:davis.anomaly-detectors) :
"analyzer": {
  "name": "dt.statistics.ui.anomaly_detection.StaticThresholdAnomalyDetectionAnalyzer",
  "input": [
    { "key": "query", "value": "timeseries avg(dt.host.disk.free), by:{dt.entity.host, dt.entity.disk}" },
    { "key": "threshold", "value": "10" },
    { "key": "alertCondition", "value": "BELOW" },
    { "key": "violatingSamples", "value": "3" },
    { "key": "slidingWindow", "value": "5" },
    { "key": "dealertingSamples", "value": "5" }
  ]
}
L’alerte se déclenche quand 3 points sur une fenêtre glissante de 5 passent sous le seuil, et ne se ferme qu’après 5 points revenus à la normale : les pics isolés sont filtrés et l’alerte ne bat pas. Ne mettez pas de valeur scalaire changeante dans les dimensions de la requête, sous peine de créer une série nouvelle à chaque évaluation.
Comment vérifier que ça fonctionne
- La requête de ratio d’erreurs sur un service sans erreur renvoie une série à 0, pas un résultat vide.
timeseries avg(dt.host.cpu.usage), interval: 5h, from: -2daffiche 6 h dans la colonneinterval.- La réponse de l’API d’ingestion affiche
linesInvalid: 0, etmetrics | filter metric.key == "shop.orders.validated" | limit 1renvoie la métrique quelques instants après l’envoi. - Exécutée seule dans un notebook, la requête de l’alerte renvoie une série par entité surveillée.
Bonnes pratiques
- Filtrez dans la commande
timeseriesplutôt qu’après : moins de séries lues, requêtes plus rapides. - Avant toute division, ajoutez
default: 0au numérateur,nonempty: trueet réfléchissez àunion. - Nommez vos clés avec un préfixe d’équipe et limitez les dimensions à ce qui sert à filtrer ou découper.
- Préférez une métrique extraite à
makeTimeseriespour les indicateurs affichés en permanence. - Reliez chaque alerte à un SLO ou à une action d’astreinte claire. Les exemples de requêtes DQL d’exploitation peuvent servir de base.
Exercice pratique
- Écrivez le ratio d’erreurs par service sur 24 h, sans puis avec
union. Comptez les services dans chaque résultat. - Envoyez trois lignes de compteur
training.eventsavec deux valeurs de dimensionenv, puis traceztimeseries sum(training.events), by: { env }. - Créez dans Anomaly Detection une alerte à seuil statique sur cette métrique, avec un seuil que vos envois dépassent.
Résultat attendu : vous expliquez l’écart de l’étape 1 et vous savez prévoir le déclenchement de l’alerte.
Quiz
- Que renvoie
interval: 5h? A) 5 h exactement B) 6 h C) Une erreur - Pourquoi un hôte sans échec disparaît-il d’un calcul échecs/total ? A) Le comportement par défaut est une intersection B) Une erreur de droits
- Quelle commande trace des spans dans le temps ? A)
timeseriesB)makeTimeseries - Sous quelle clé interroger dans Grail un compteur envoyé comme
coffees.brewing count,delta=2? A)coffees.brewing.countB)coffees.brewing
Corrigé
- B. 5 h n’est pas un intervalle connu ; la plateforme retient 6 h.
- A. Sans
union: true, seules les séries présentes dans toutes les colonnes sont gardées. - B.
makeTimeseriesagrège des enregistrements ;timeseriesne lit que des métriques. - B. Le suffixe
.countn’existe que dans le modèle classique.
← Module 6 : Métriques cloud Grail · Sommaire du parcours · Revenir au module 1 →
Questions fréquentes
Quelle différence entre timeseries et makeTimeseries ?
timeseries est une commande de départ qui lit les métriques stockées dans Grail. makeTimeseries se place après un fetch et construit une série à partir d’enregistrements : logs, spans, événements ou business events.
Faut-il déclarer une métrique avant de l’envoyer ?
Non. La métrique est créée à la première ingestion. Les métadonnées (nom affiché, unité, description) peuvent être ajoutées ensuite, par exemple avec une ligne commençant par #.
Comment connaître les dimensions d’une métrique ?
Utilisez metrics | filter metric.key == "ma.cle" | limit 1 ou le fichier /dt/platform/metrics.metadata avec la commande load.
Vous avez terminé le parcours : vous savez lire les métriques intégrées, les interroger avec précision, créer les vôtres et alerter dessus. Références : DQL metric commands et Metrics API, POST ingest data points.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Ce parcours ne remplace pas les formations et certifications officielles de Dynatrace University. Vérifiez les scopes et la syntaxe dans la documentation officielle de votre environnement.